La concordancia difusa es un proceso que compara cadenas de texto para identificar registros que son similares pero no idénticos. Esto es fundamental cuando los datos incluyen errores tipográficos, diferencias de formato, abreviaturas o mayúsculas y minúsculas incoherentes. El software de concordancia difusa de Match Data Pro le permite detectar estos datos casi duplicados con precisión, utilizando algoritmos de puntuación inteligentes y umbrales personalizables.
Cuando la velocidad y la precisión importan, lo tenemos cubierto
Elegir el software de cotejo difuso adecuado es fundamental cuando lo que importa es la precisión, la velocidad y la escalabilidad. Match Data Pro se creó específicamente para los profesionales de los datos que necesitan una comparación de registros de alto rendimiento con un control, una flexibilidad y una transparencia totales.
He aquí por qué los equipos eligen nuestra solución de partidos difusos:

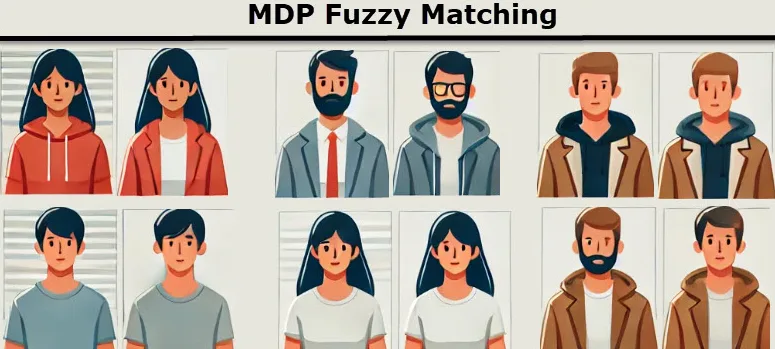
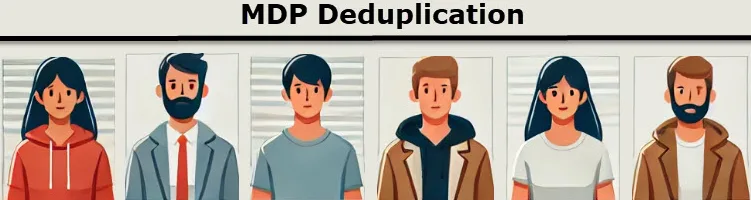
Conecte y compare fuentes de datos ilimitadas mediante nuestro potente software de coincidencias difusas. Compara registros de archivos, bases de datos y API, sin silos ni límites.
Asigne automáticamente nombres de columna similares entre fuentes de datos con el software de coincidencia difusa. Ahorra tiempo alineando campos, incluso cuando los encabezados no coinciden exactamente.
Elija entre los modos Parcial, Completo o nuestro exclusivo modo Completo+Puente para controlar cómo se agrupan los registros tras la concordancia difusa. Equilibre el rigor y la cobertura de las coincidencias en función de sus datos y objetivos.
Elija entre los métodos de puntuación por pares o por grupos para controlar cómo se calcula la similitud. La puntuación de grupo destaca cómo se compara cada registro con el maestro del grupo, lo que le ayuda a capturar coincidencias más significativas, incluso cuando algunas quedan justo por debajo del umbral.
Nuestro sistema utiliza una combinación de Jaro-Winkler y otros algoritmos de similitud para garantizar la máxima precisión en la coincidencia de registros, incluso con variaciones significativas.
Adapte sus parámetros de coincidencia difusa con definiciones y criterios personalizados para satisfacer sus necesidades y conjuntos de datos específicos.
Ajuste el nivel de difuso para afinar la sensibilidad de sus coincidencias y equilibrar entre precisión y recuperación.
Exporte exactamente lo que necesita: coincidencias, no coincidencias, registros deduplicados o diccionarios. Nuestro software de concordancia difusa le ofrece un control total sobre los resultados.
Ya sea que trabaje con registros de clientes, bases de datos de productos o cualquier otro tipo de datos, nuestra tecnología de coincidencia difusa le proporciona las herramientas necesarias para lograr una precisión superior. Explore las ventajas de nuestro software de coincidencia difusa y vea cómo puede transformar sus operaciones de datos.
La coincidencia difusa de datos identifica los registros que se refieren a la misma entidad, incluso cuando los valores no coinciden exactamente. Utiliza una puntuación de similitud para gestionar errores ortográficos, abreviaturas y diferencias de formato (por ejemplo, «Jon Smith» frente a «Jonathan Smith»). Match Data Pro combina la coincidencia difusa con la creación de perfiles y la limpieza de datos para vincular con precisión los registros relacionados entre distintas fuentes.
Los datos del mundo real son desordenados. La coincidencia aproximada elimina los casi duplicados y resuelve las inconsistencias, lo que garantiza la fiabilidad de los análisis, el marketing y los informes. En Match Data Pro, la coincidencia aproximada, junto con la limpieza de datos, genera conjuntos de datos limpios y unificados que reducen los errores y el gasto innecesario.
La coincidencia exacta requiere valores idénticos; la coincidencia aproximada evalúa la similitud. Esto permite a los sistemas encontrar coincidencias probables a pesar de errores ortográficos, transposiciones o variaciones de formato. Gracias a sus umbrales configurables, Match Data Pro equilibra la precisión y la recuperación según tu caso de uso.
Entre las técnicas más habituales se encuentran Levenshtein (distancia de edición), Jaro–Winkler, las codificaciones fonéticas (Soundex, Metaphone) y las comparaciones basadas en tokens. La mayoría de las plataformas también aplican umbrales y técnicas de bloqueo e indexación para adaptarse a la escala. Match Data Pro es compatible con múltiples algoritmos con puntuación ajustable.
Detecta y fusiona registros casi duplicados y vincula entradas que corresponden a la misma persona, empresa o dirección en distintos sistemas. Esto permite obtener una visión única y consolidada de cada entidad. Match Data Pro utiliza la agrupación difusa y puntuaciones de confianza para garantizar fusiones fiables.
Antes de la importación, la coincidencia aproximada detecta y resuelve los duplicados y las entradas incoherentes procedentes de múltiples fuentes, evitando así la presencia de datos erróneos en el nuevo CRM. En Match Data Pro, el flujo de trabajo es el siguiente: perfil → limpieza → coincidencia aproximada → validación → exportación, lo que permite obtener una base de datos de contactos limpia y unificada.
El sector sanitario utiliza la coincidencia aproximada para vincular los historiales de los pacientes con variaciones en el nombre, la dirección o el número de identificación, lo que reduce los números de registro médico (MRN) duplicados y los historiales fragmentados. Esto mejora la seguridad de los pacientes y la integridad de los datos. Las funciones de perfilado y coincidencia de Match Data Pro ayudan a crear historiales precisos y continuados.
La coincidencia aproximada elimina los duplicados de los clientes potenciales y estandariza los datos de contacto, lo que evita el envío múltiple de correos y las métricas sesgadas. Las listas más limpias mejoran la capacidad de entrega y la personalización. Match Data Pro agiliza la limpieza de listas mediante puntuaciones, umbrales y reglas automatizadas.
Los datos de los donantes proceden de eventos, formularios en línea e importaciones, y presentan numerosas variaciones en los nombres y direcciones. La coincidencia aproximada fusiona los casi duplicados en un único perfil de donante. Match Data Pro incorpora la creación de perfiles, la limpieza de datos y la validación mediante IA para garantizar la fiabilidad de la lista definitiva de donantes.
Combina la correspondencia determinista basada en reglas con la asistencia de la IA para la configuración y la revisión. Las personas definen los criterios; la IA sugiere umbrales y ponderaciones, y valida los grupos con bajo nivel de confianza. Match Data Pro utiliza este modelo híbrido para ofrecer precisión a gran escala con resultados explicables.
El análisis de perfiles permite detectar valores nulos, patrones, incoherencias y ruido; la limpieza estandariza los formatos y elimina los artefactos. Esto reduce las coincidencias falsas y mejora la recuperación. Match Data Pro analiza más de 25 métricas por columna y ofrece más de 20 herramientas de limpieza para maximizar la calidad de las coincidencias.
Utiliza umbrales por niveles (aceptación automática, revisión, rechazo), examina las puntuaciones dudosas y comprueba los campos secundarios. Las auditorías por muestreo ayudan a ajustar las reglas. La IA de Match Data Pro puede señalar grupos de casos límite, proporcionar puntuaciones de confianza y añadir notas para agilizar la revisión humana.
La IA agiliza la configuración (reglas y umbrales sugeridos), mejora la coherencia y clasifica los casos extremos con explicaciones. En lugar de analizar por fuerza bruta millones de registros sin procesar, la IA trabaja a partir de resúmenes de perfiles. Match Data Pro utiliza la IA precisamente allí donde aporta rapidez y claridad.
Datos más limpios, menos duplicados, mejores análisis, reducción de costes y mejora de la personalización y el cumplimiento normativo. Los equipos trabajan a partir de una única fuente de información fiable. Match Data Pro hace realidad estas ventajas mediante la puntuación, la agrupación y las fusiones auditables en grandes conjuntos de datos.
Busca reglas híbridas y capacidades de IA, compatibilidad con múltiples algoritmos, funciones integradas de perfilado y limpieza de datos, flujos de trabajo de revisión, escalabilidad y flexibilidad en la implementación y la integración de API. Match Data Pro ofrece una configuración sin código, una comparación de alto rendimiento, validación mediante IA y automatización para los procesos continuos.
En Match Data Pro, nuestro enfoque principal es la coincidencia de datos difusos y la resolución de entidades, pero nuestra plataforma va mucho más allá de eso.
Copyright 2026 Match Data Pro. Todos los derechos reservados