
La deduplicación de datos es un proceso crucial en la gestión de datos que implica identificar y eliminar registros duplicados dentro de un conjunto de datos. Esta práctica mejora la calidad de los datos, reduce los costos de almacenamiento y mejora la eficiencia del procesamiento de datos.
La experiencia es fundamental en la gestión de datos, y Match Data Pro aporta años de experiencia. Nuestro equipo de especialistas en datos comprende a la perfección los desafíos que enfrentan las organizaciones que gestionan grandes cantidades de datos de múltiples fuentes. A lo largo de los años, hemos perfeccionado nuestros procesos, desarrollado herramientas robustas y construido un legado de resultados confiables para nuestros clientes.
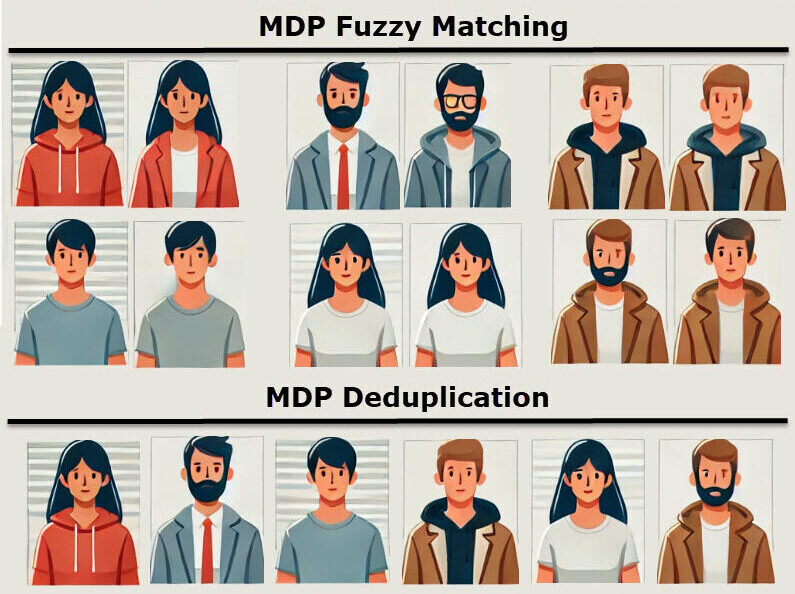
Los dos tipos principales son la deduplicación a nivel de archivo y a nivel de bloque. La deduplicación a nivel de archivo busca y elimina archivos idénticos, mientras que la deduplicación a nivel de bloque va más allá, identificando segmentos duplicados dentro de distintos archivos. Match Data Pro aplica ambos conceptos mediante una comparación avanzada a nivel de registro, lo que garantiza que los registros duplicados se eliminen con precisión, incluso cuando los formatos o la ortografía difieran.
Los datos del mundo real son desordenados. La coincidencia aproximada elimina los casi duplicados y resuelve las inconsistencias, lo que garantiza la fiabilidad de los análisis, el marketing y los informes. En Match Data Pro, la coincidencia aproximada, junto con la limpieza de datos, genera conjuntos de datos limpios y unificados que reducen los errores y el gasto innecesario.
Los principales riesgos se derivan de una coincidencia demasiado agresiva, es decir, cuando se fusionan por error registros válidos. Match Data Pro evita esto mediante umbrales configurables y una coincidencia aproximada asistida por IA, lo que te ofrece un control total y la posibilidad de revisar los datos antes de que se produzca cualquier fusión.
Tradicionalmente, la deduplicación requería el uso de scripts o una limpieza manual. Con Match Data Pro, es tan sencillo como apuntar y hacer clic: importa tus datos, define tus reglas de coincidencia (exactas o aproximadas), revisa los duplicados y fúndelos con total confianza, todo ello desde una interfaz web intuitiva.
La normalización estandariza los datos (por ejemplo, el formato de los números de teléfono o las direcciones), mientras que la deduplicación elimina las entradas repetidas o que se solapan. En Match Data Pro, estos pasos se realizan de forma conjunta —primero se normalizan y, a continuación, se deduplican— para lograr una mayor precisión en la correspondencia y unos resultados más limpios.
Depende de tu conjunto de datos, pero los resultados habituales oscilan entre una reducción de duplicados del 5 % y el 25%. El módulo de análisis de perfiles de Match Data Pro te ayuda a estimar tu tasa de duplicación antes de realizar una limpieza completa, para que puedas medir la mejora con precisión.
Excel ofrece funciones básicas para eliminar duplicados, pero no es capaz de detectar duplicados casi idénticos, como «Jon Smith» frente a «John Smyth». Match Data Pro va más allá de las coincidencias exactas: utiliza algoritmos de coincidencia aproximada y análisis de perfiles de datos para detectar duplicados que las hojas de cálculo pasan por alto.
Entre los retos más habituales se encuentran los formatos inconsistentes, los errores tipográficos, los campos que faltan y los duplicados entre fuentes. Match Data Pro resuelve estos problemas mediante un preprocesamiento inteligente —creación de perfiles, estandarización y coincidencia aproximada configurable— para garantizar la precisión a gran escala.
Cualquier tipo de datos estructurados: contactos, clientes potenciales, proveedores, clientes o productos. Match Data Pro es compatible con múltiples formatos de archivo (CSV, Excel, Parquet, bases de datos, API) y gestiona la deduplicación entre fuentes de datos y sistemas en un único flujo de trabajo.
Sí. La deduplicación es fundamental para mantener la integridad de los datos en las bases de datos. Match Data Pro se integra con las exportaciones de bases de datos o las API para detectar duplicados antes de que entren en producción, lo que permite ahorrar espacio de almacenamiento y garantizar la precisión de las consultas.
En Match Data Pro, nuestro enfoque principal es la coincidencia de datos difusos y la resolución de entidades, pero nuestra plataforma va mucho más allá de eso.
Copyright 2026 Match Data Pro. Todos los derechos reservados