
Fraud Blocker Cotejo de datos, deduplicación y resolución de entidades | MDP

Cotejo de datos, deduplicación y resolución de entidades


Coincide 2 millones de registros en menos de 2 minutos gracias a algoritmos difusos configurables y a la resolución de entidades con tecnología de Senzing. Crea perfiles, depura, deduplica y fusiona datos de archivos, bases de datos y sistemas CRM. Disponible en modalidades SaaS y de instalación local.

Sin compromiso. Prueba gratuita disponible.

Opciones de despliegue de Match Data Pro

Comparación difusa de datos mediante IA de nivel empresarial

Estadísticas de coincidencia aproximada

Tamaño del conjunto de datosÍndice de coincidenciasPlazo de tramitaciónRendimiento (grabaciones/segundo)Retirada del mercadoPrecisiónF1
1M10%30s~33,300100%100%100%
1M30%90s~11,100100%99.5%99.7%
1M90%180s~5,600100%98%99.0%
10M10%3 min~55,600100%100%100%
10M30%7 min~23,80099%99.5%99.2%
10M90%21 min~7,90099%98%98.5%
50M10%8 min~104,200100%100%100%
50M30%35 min~23,80099%99.5%99.2%
50M90%90 min~9,30098%98%98.0%
100M10%40 min~41,700100%100%100%
100M30%2 h 10 min~12,80098%99.5%98.7%
100M90%5h~5,60098%98%98.0%

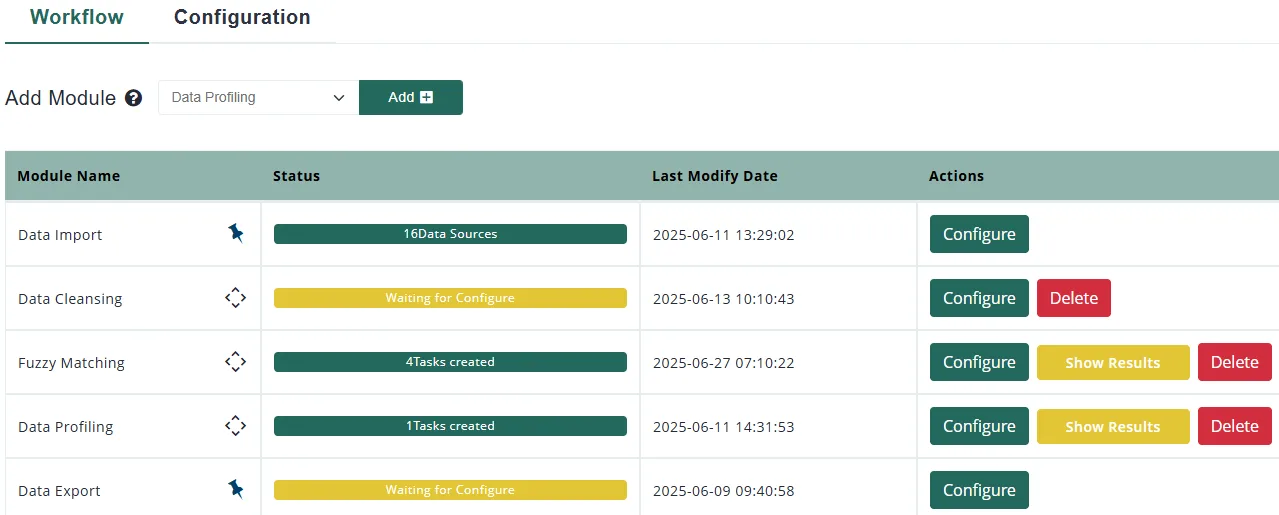
Gestión de datos basada en proyectos

Reseñas y detalles del producto de Match Data Pro

En G2.com

"Resuelto el problema de la correspondencia compleja de datos difusos"

Carlos B.

Director de Tecnología para Mercado Medio (51-1000 empleados)

El proceso paso a paso que guía al usuario a través del proceso de emparejamiento. El proceso sigue un patrón lógico para que el resultado final sea correcto. El emparejamiento de datos difusos es complejo y presenta múltiples permutaciones, pero Match Data Pro ha podido adaptarse a la complejidad de mis conjuntos de datos. Al ser un producto SaaS y local, dispongo de opciones según el usuario y el conjunto de datos. El equipo fue muy servicial durante la incorporación y la formación.

Emparejamiento de múltiples conjuntos de datos de manera oportuna y confiable.

He estado usando la plataforma durante aproximadamente 12 meses y debo decir que es muy fácil de usar.

Bret R.

Consultor Senior ERP Empresa (> 1000 emp.)

Cuenta con todas las herramientas necesarias para tus datos: creación de perfiles, limpieza, lógica difusa y mapeo. Mi favorita es la velocidad con la que la herramienta te permite estar lista y lista para usar en menos de un minuto para crear perfiles de datos.

La mayoría de las demás aplicaciones requieren una gran configuración y una curva de aprendizaje enorme.

La otra cosa es que el precio es muy fácil y claro.

Ben y James han sido excelentes al brindar apoyo y ayudar en lo que han podido.

Un poco más de videos de capacitación, pero estos ya están en producción y hay algunos más por salir.

Proporciona datos limpios con gran rapidez. Esto requiere el uso habitual de hojas de cálculo y causa retrasos, ya que los datos se procesan línea por línea. Sin embargo, con MDP se puede ver el conjunto completo de datos. Se captura cada campo y se proporciona un estado. También es fácil ver los errores con una vista rápida del archivo que muestra los datos reales.


No se necesita registro ni tarjeta de crédito

Si tiene alguna pregunta, póngase en contacto con nosotros.

Pruebe ahora nuestro cotejo de datos difusos

Vea una demostración

Qué puede hacer
con Match Data Pro

Match Data Pro no solo ofrece una función de comparación de datos difusade primer nivel, sino que está diseñado para que los flujos de trabajo con datos complejos sean más sencillos, más inteligentes y más colaborativos. Esto es lo que puedes esperar

Conectores preconstruidos

Conecte y sincronice sin problemas datos de diversas fuentes, incluso de sistemas incompatibles,
para permitir una integración de datos unificada, automatizada y en tiempo real
.

API e integraciones en la nube

Nuestras API e integraciones en la nube le permiten conectarse con las principales plataformas: Snowflake, Google Drive, OneDrive, Dropbox y otras fuentes de datos.

Sincronizar datos

Aproveche los conectores prediseñados que funcionan con prácticamente cualquier formato de archivo o estructura de datos.

Gestión de MDP

Administre todas sus integraciones y flujos de trabajo de datos desde un panel limpio e intuitivo, sin necesidad de codificación.

Replicación y sincronización de MDP

Mantenga sus datos sincronizados con las herramientas integradas de replicación y sincronización.

Herramientas de calidad de datos de MDP

Encuentre y solucione rápidamente los problemas de datos utilizando las herramientas integradas de
para crear perfiles, limpiar,
y supervisar la calidad de los datos.

Vistas de 360 grados de la compilación MDP

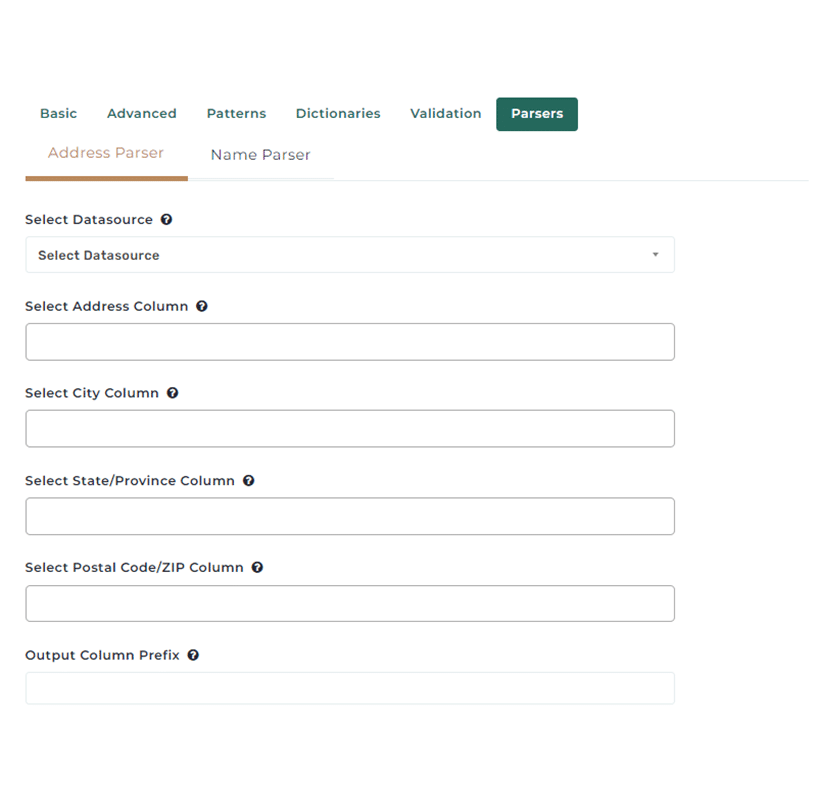
Cree rápidamente vistas de 360 grados de sus clientes, proveedores o cualquier entidad comercial utilizando fuentes internas y externas.

Herramientas de calidad de datos de MDP

Estandarice, limpie y elimine duplicados de registros a escala con reglas que evitan que datos incorrectos ingresen al sistema.

Automatización de proyectos MDP

Automatice todo su proceso con flujos de trabajo fáciles de usar, reglas reutilizables, control de versiones, programación, webhooks y activadores de API REST.

Intercambio y colaboración en proyectos del MDP

Trabaje mejor en equipo asignando diferentes niveles de acceso y compartiendo flujos de trabajo de proyectos de forma segura en toda su organización.

Descubre información detallada sobre los datos
con nuestra herramienta de perfilado basada en IA

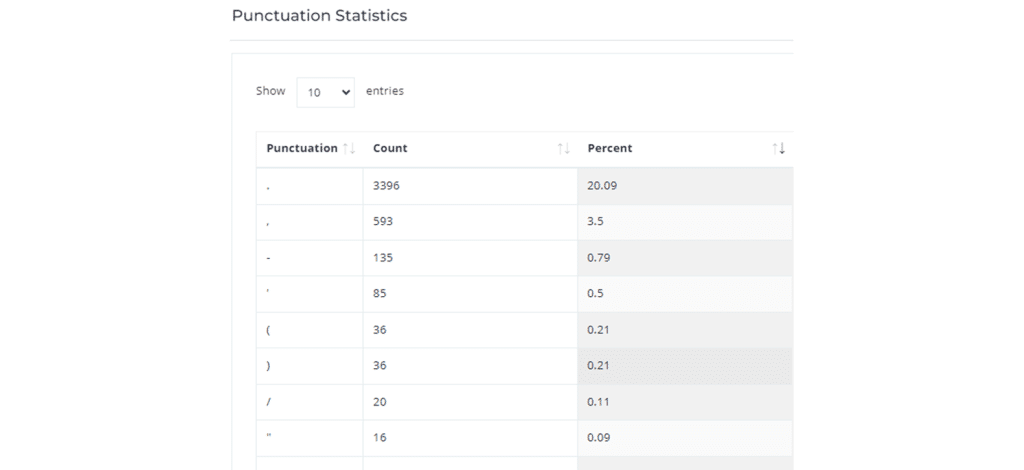
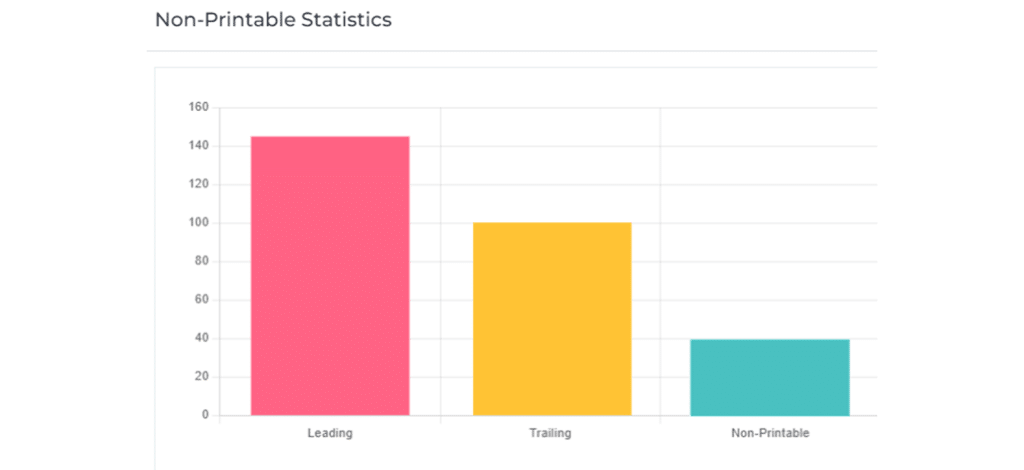
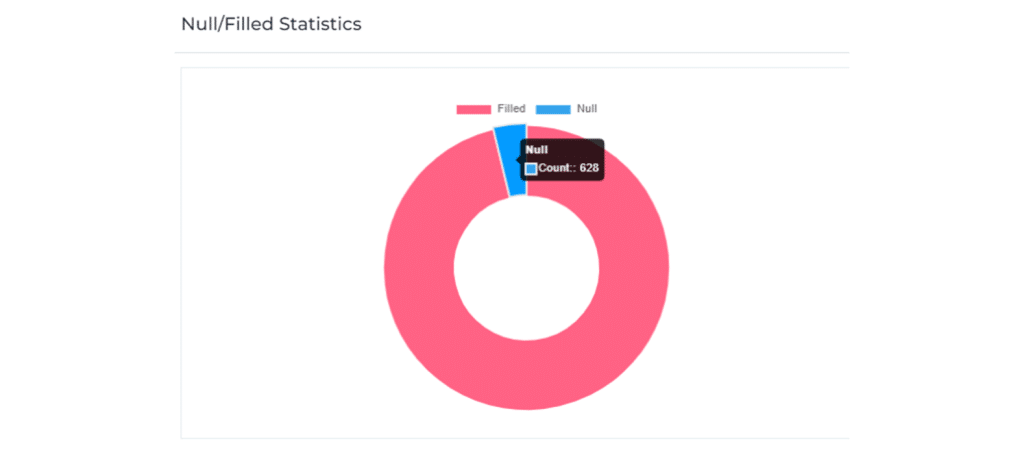
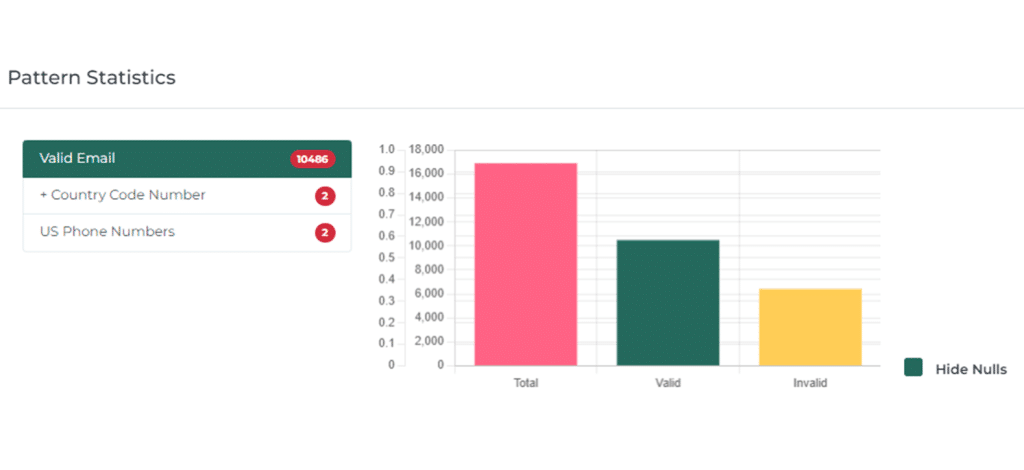
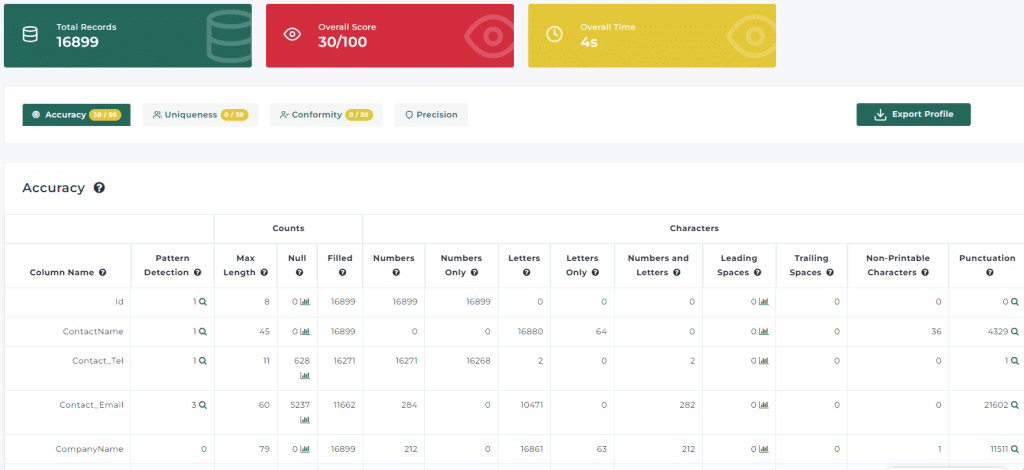
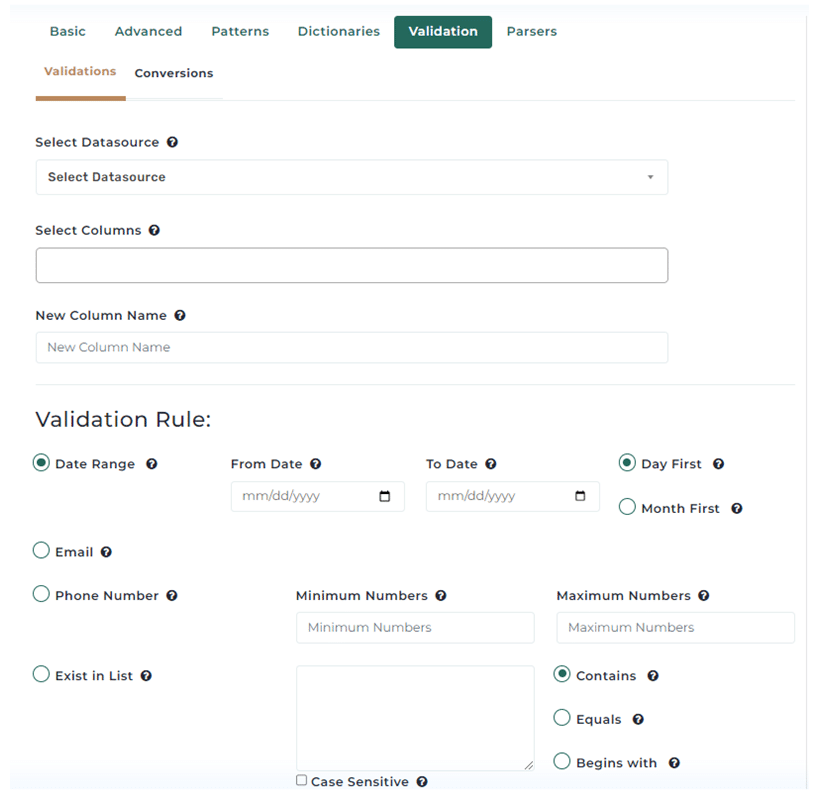
Descubre valiosos conocimientos sobre los datos con nuestra herramienta avanzada de análisis de perfiles. Con más de 25 métricas clave, te permite analizar a fondo la calidad de los datos y detectar problemas que deben abordarse. Nuestra herramienta ofrece un análisis detallado que te ayuda a identificar inconsistencias y anomalías de forma eficaz.

Mejora la gestión de tus datos con un resumen profesional generado por IA. Personaliza un informe en cuestión de segundos y crea fácilmente conclusiones prácticas gracias a la IA.

Limpieza y estandarización de datos para la IA

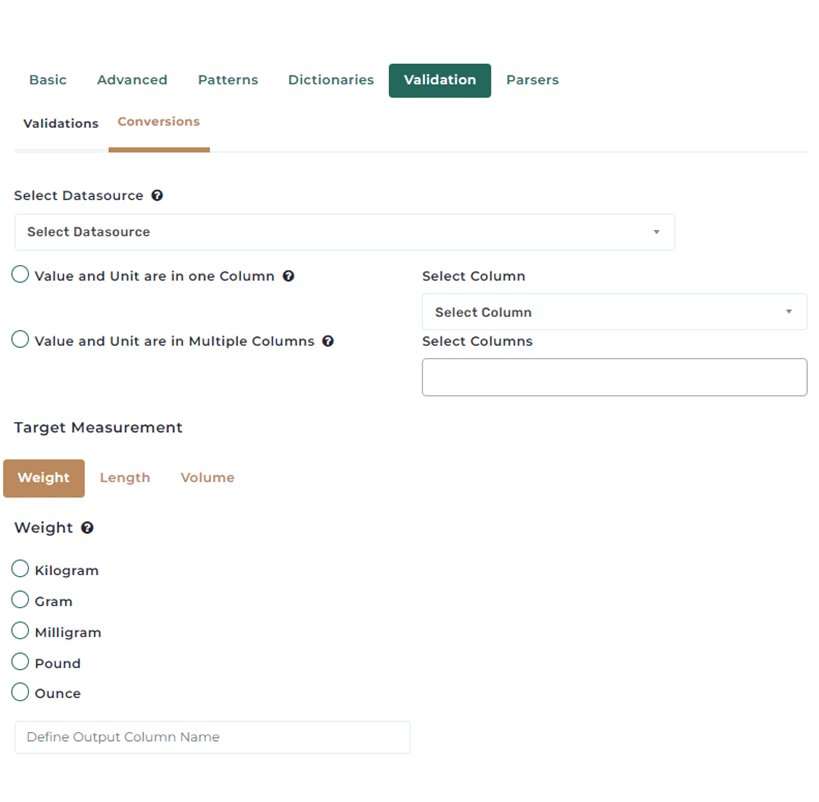
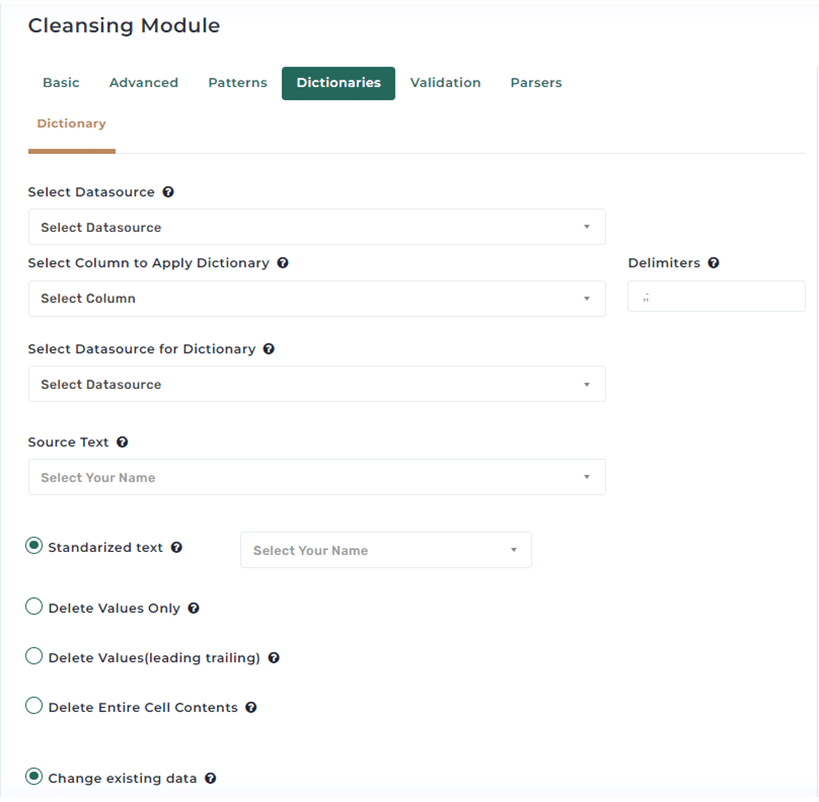
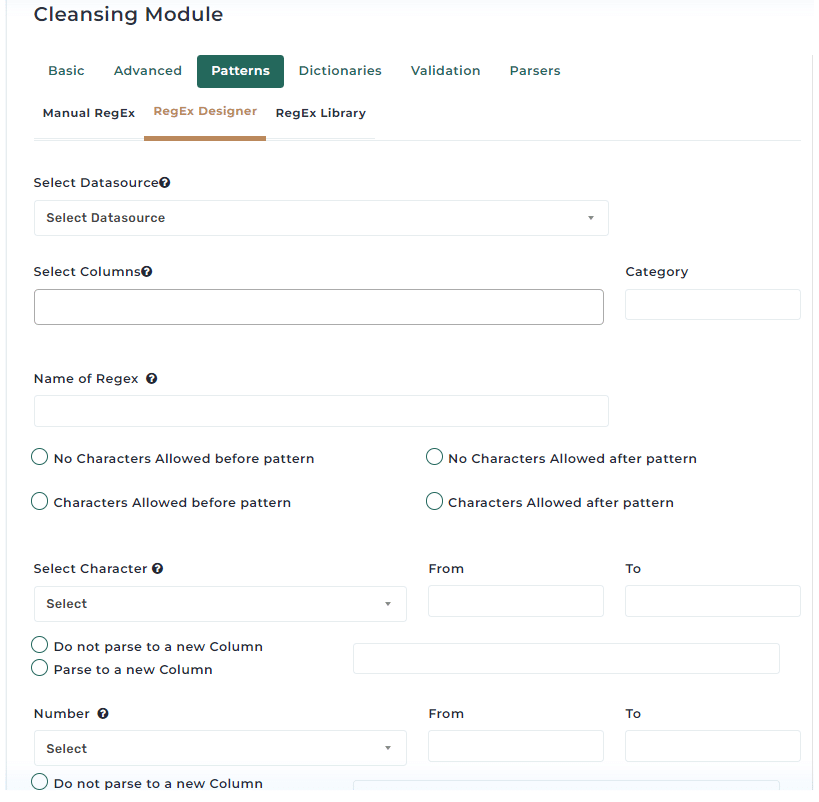
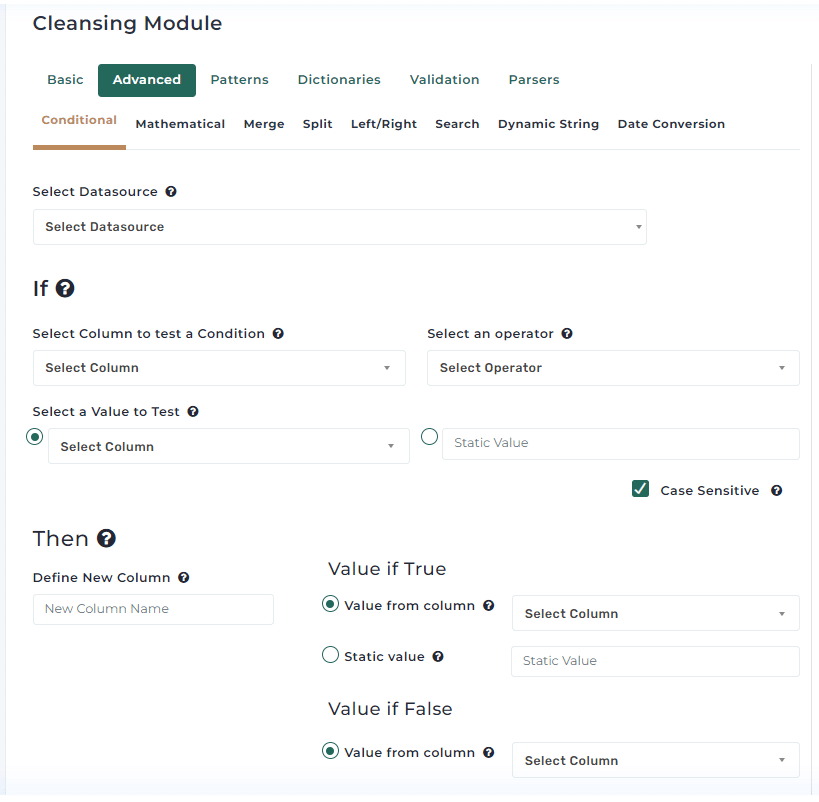
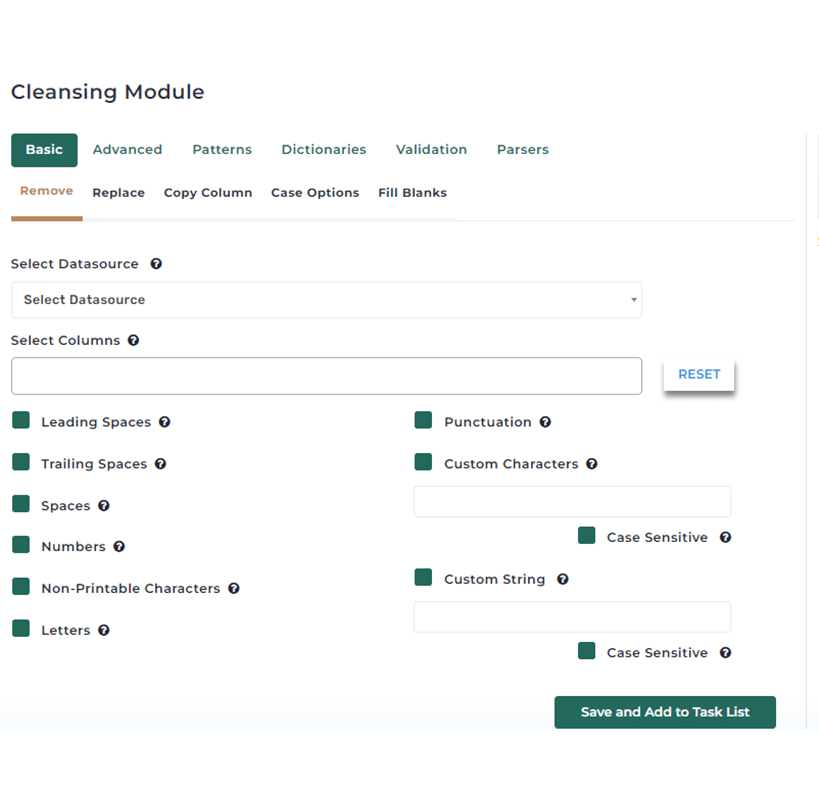
Libere todo el potencial de sus datos con nuestras herramientas de limpieza de mejores prácticas. Tanto si necesita normalizar los datos para informes específicos como garantizar que cumplen estándares de alta calidad, nuestro software de limpieza de datos irá más allá.

Diga adiós a los errores e incoherencias en los datos. Nuestra sencilla interfaz de apuntar y hacer clic le ayuda a limpiar y normalizar sus datos de forma eficaz. Con más de 20 opciones personalizables, puede asegurarse de que sus datos son precisos, fiables y están listos para el análisis.

¿Gestiona 10 fuentes de datos con los mismos problemas de calidad? Aplique sus reglas de limpieza de datos de una fuente a todas las demás en cuestión de segundos.

Limpia tus datos automáticamente dejando que la IA analice tu perfil de datos y determine exactamente qué hay que limpiar. Limpia grandes conjuntos de datos en segundos.

Coincidencia precisa y configurable de datos difusos para sus datos

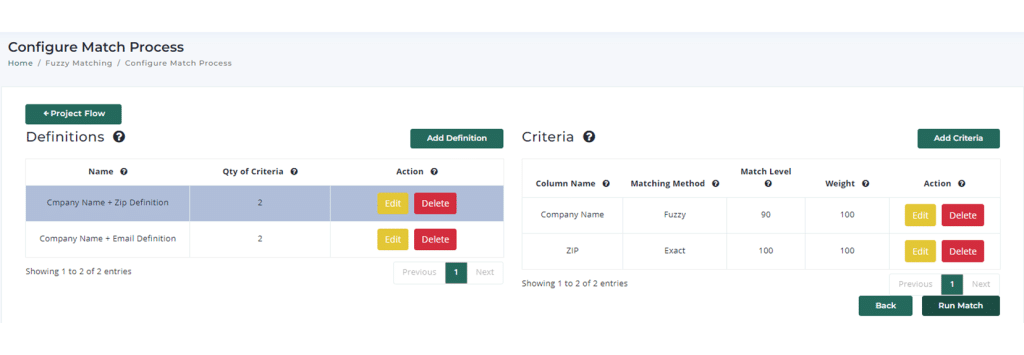
Consiga una coincidencia precisa de datos difusos con nuestra herramienta avanzada y configurable. Nuestro algoritmo personalizado gestiona pequeñas variaciones eficazmente mediante múltiples definiciones (declaraciones OR) y criterios (declaraciones AND) para garantizar una alta precisión. Compare sin problemas hasta un millón de registros en menos de 5 minutos, lo que lo hace perfecto para grandes conjuntos de datos.

Comparación de datos Características principales

Optimice su proceso de comparación de datos con nuestra potente herramienta de comparación de datos difusos.

Alta precisión

Se ha demostrado que nuestra lógica de emparejamiento y agrupación consigue más coincidencias que la competencia.

Configuración personalizada

Configure múltiples definiciones y criterios en ordet para cotejar datos incompletos e incoherentes.

Agrupación propietaria

La agrupación de partidos es importante cuando se necesita un resultado específico. Hemos desarrollado opciones que satisfacen las necesidades de cada caso de uso.

Opciones de puntuación

Somos la única herramienta del sector que ha desarrollado opciones de puntuación. Esto le permite ver la puntuación de la relación de múltiples maneras.

Procesamiento rápido

Compare hasta 1 millón de registros en menos de 5 minutos.

Automatización de proyectos

Interfaz fácil de creación de empleo

Match Data Pro guarda la configuración del proyecto, no los datos, para que pueda actualizar los datos de forma segura y reutilizar o volver a ejecutar los procesos bajo demanda. Es perfecto para tareas recurrentes como la deduplicación de clientes potenciales a partir del envío de formularios, la incorporación de listas o la correspondencia de múltiples fuentes.

Interfaz de usuario inteligente de MDP

Optimice la actualización de sus datos

Elimine el trabajo manual repetitivo con la automatización programada. Una vez configurado el proyecto, Match Data Pro le permite guardar la lógica, actualizar los datos y programarlo para que se ejecute automáticamente a los intervalos que prefiera.

Programador MDP

Activar trabajos sin problemas

Tome el control total de sus flujos de trabajo de datos con nuestra potente API REST. Active trabajos guardados mediante programación, automatice la ejecución más allá de las ejecuciones programadas e integre Match Data Pro directamente en sus herramientas o aplicaciones internas.

API de automatización de MDP

Ejemplos de casos de uso de cotejo de datos

data matching crm migration data matching software fuzzy matching

Consulte nuestros últimos artículos

Data Matching and Merging: A Complete Pipeline Guide for Data Teams

Data Matching and Merging: A Complete Pipeline Guide for Data Teams

Data matching and merging links records across siloed systems and consolidates them into a verified golden record using fuzzy scoring,…

Building Sustainable Data Assets: Long-Term Quality and Matching Practices

Building Sustainable Data Assets: Long-Term Quality and Matching Practices

Sustainable data assets require a continuous seven-stage pipeline — profiling, standardisation, address verification, fuzzy matching, entity resolution, survivorship, and monitoring…

One Customer, Many Records: A 5-Step Framework to Fix Duplicate Data at Scale

One Customer, Many Records: A 5-Step Framework to Fix Duplicate Data at Scale

When one customer appears as five records across your CRM, ERP, and marketing platform, analytics break and compliance fails. Use…

Vamos a empezar

¿Estás listo para ver cómo Match Data Pro puede simplificar tus operaciones de datos?

Preguntas frecuentes

Sí. Excel admite la búsqueda aproximada básica a través del complemento «Fuzzy Lookup», que compara valores de texto mediante algoritmos de similitud. Sin embargo, su rendimiento es limitado y no resulta ideal para conjuntos de datos de gran tamaño ni para lógicas de búsqueda complejas.

Los datos imprecisos son aquellos que no son exactos, como los errores ortográficos, las abreviaturas o los formatos inconsistentes.
Ejemplo:
«Jon Smith», «John Smyth» y «J. Smith» se refieren todos a la misma persona, pero difieren ligeramente en la ortografía o la estructura.

Sí. SQL puede realizar comparaciones aproximadas mediante funciones como SOUNDEX o DIFFERENCE, o a través de algoritmos de similitud de cadenas como la distancia de Levenshtein o la de Jaro-Winkler. Sin embargo, el SQL nativo no está optimizado para realizar comparaciones aproximadas a gran escala.

En el ámbito de la lucha contra el blanqueo de capitales (AML), la comparación aproximada se utiliza para detectar posibles coincidencias entre personas o entidades en las listas de vigilancia internacionales. Ayuda a identificar variaciones en nombres, direcciones u organizaciones que podrían indicar relaciones ocultas o de alto riesgo.

La coincidencia aproximada puede mejorarse mediante la resolución de entidades o enfoques híbridos asistidos por IA que combinan la coincidencia basada en reglas, los algoritmos fonéticos y la comparación de datos contextuales, con el fin de lograr una mayor precisión y reducir el número de falsos positivos.

Los datos difusos son aquellos que no están claramente definidos, estructurados o son coherentes. Pueden contener errores, valores que faltan o incertidumbres que dificultan la correspondencia exacta. Las técnicas difusas se utilizan para interpretar estos datos de forma más inteligente.

La coincidencia difusa también se conoce como coincidencia aproximada de cadenas, coincidencia probabilística o coincidencia por similitud. Todos estos términos describen métodos que identifican registros que son similares, pero no idénticos.

FCM son las siglas de «Fuzzy C-Means», un algoritmo de agrupación que agrupa los puntos de datos en función de los grados de pertenencia, en lugar de asignaciones rígidas. Se utiliza ampliamente en el aprendizaje automático y la segmentación de datos.

La coincidencia exacta identifica los registros que son idénticos en todos los campos, mientras que la coincidencia aproximada permite coincidencias parciales basadas en puntuaciones de similitud. La coincidencia aproximada es más flexible, por lo que resulta ideal para datos desordenados o incoherentes.

Los tres tipos principales de agrupación son:

Agrupación dura: asigna cada punto de datos a un único grupo.

Agrupación difusa: permite que los puntos de datos pertenezcan a varios grupos con probabilidades.

Agrupación jerárquica: crea agrupaciones anidadas basadas en la similitud de los datos.

Una base de datos difusa gestiona información imprecisa o incierta mediante la lógica difusa. En lugar de condiciones estrictas de verdadero/falso, almacena y procesa grados de verdad, lo que permite una consulta y un análisis de datos más flexibles.

La búsqueda difusa funciona comparando texto o cadenas de caracteres mediante métricas de similitud, como la distancia de Levenshtein o algoritmos basados en tokens. Estos determinan el grado de similitud entre dos cadenas y les asignan una puntuación de similitud.

Sí. La IA puede mejorar la coincidencia aproximada al aprender patrones contextuales y optimizar los umbrales. En lugar de basarse en puntuaciones de similitud estáticas, los sistemas impulsados por IA se adaptan en función del tipo y la estructura de los datos que se comparan.

La lógica difusa ayuda a gestionar la ambigüedad en el análisis de datos. Asigna grados de similitud en lugar de resultados binarios (verdadero/falso), lo que permite a los analistas identificar patrones y relaciones que la lógica estricta pasaría por alto.

Entre los métodos más habituales se encuentran:

Distancia de Levenshtein: cuenta las modificaciones de caracteres necesarias.

Jaro-Winkler: se centra en la coincidencia de prefijos.

Similitud coseno: compara datos de texto vectorizados.
Estas técnicas arrojan una puntuación de similitud comprendida entre 0 y 1.

Se producen errores cuando los umbrales son demasiado amplios o estrictos, o cuando los datos contienen abreviaturas, formatos incoherentes o falta contexto. Un preprocesamiento y un ajuste adecuados mejoran la precisión.

En marketing, la coincidencia aproximada identifica los clientes potenciales duplicados, fusiona los perfiles de los clientes y armoniza los datos de las campañas procedentes de múltiples fuentes, lo que permite disponer de sistemas CRM más limpios y una mejor segmentación.

Las bibliotecas tradicionales de coincidencia difusa tienen dificultades para escalar debido a su coste computacional. Las implementaciones eficientes utilizan el procesamiento distribuido o la agrupación previa para gestionar millones de registros.

Los sectores que dependen en gran medida de la precisión de los datos —como la sanidad, las finanzas, la administración pública y el comercio minorista— utilizan la coincidencia aproximada para la deduplicación, la detección de fraudes y la resolución de la identidad de los clientes.