Fraud Blocker Documentación de la búsqueda difusa en tiempo real

Documentación de la búsqueda difusa en tiempo real

Guía de vídeo

Resumen

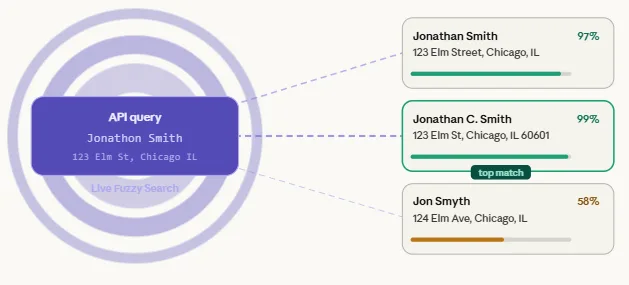
Live Fuzzy Search te permite buscar en cualquier conjunto de datos de referencia en tiempo real y obtener al instante los resultados más cercanos, incluso cuando la información introducida no sea perfecta. Está diseñado para cualquier situación en la que necesites realizar búsquedas aproximadas sobre la marcha: nombres, clientes, proveedores, empresas, pacientes o direcciones. Una de sus aplicaciones más potentes es la detección de duplicados en el momento de la introducción de datos: antes de guardar un nuevo registro en tu sistema, lo pasas por la Búsqueda difusa en tiempo real y compruebas de inmediato si ya existe algo similar. Así es como se evitan los duplicados antes de que se produzcan.

Live Fuzzy Search es un módulo estándar del flujo de trabajo de Match Data Pro. Esto significa que puede recibir datos de cualquier módulo anterior: puedes importar datos y pasarlos directamente a Live Fuzzy Search, someterlos primero a una limpieza (Cleansing), procesarlos mediante la resolución de entidades (Entity Resolution) o incluso mostrar únicamente los registros coincidentes o únicos de un trabajo de Match anterior. También puedes añadir varios módulos de Live Fuzzy Search a un mismo proyecto, uno por cada conjunto de datos que desees buscar.

Instalación y configuración del módulo

Para añadir «Live Fuzzy Search», abre el flujo de trabajo de tu proyecto, selecciónalo en la lista de módulos y haz clic en «Añadir». Una vez añadido, haz clic en «Configurar» para abrir el panel de configuración; también puedes acceder a la configuración de cualquier módulo desde el menú de la izquierda.
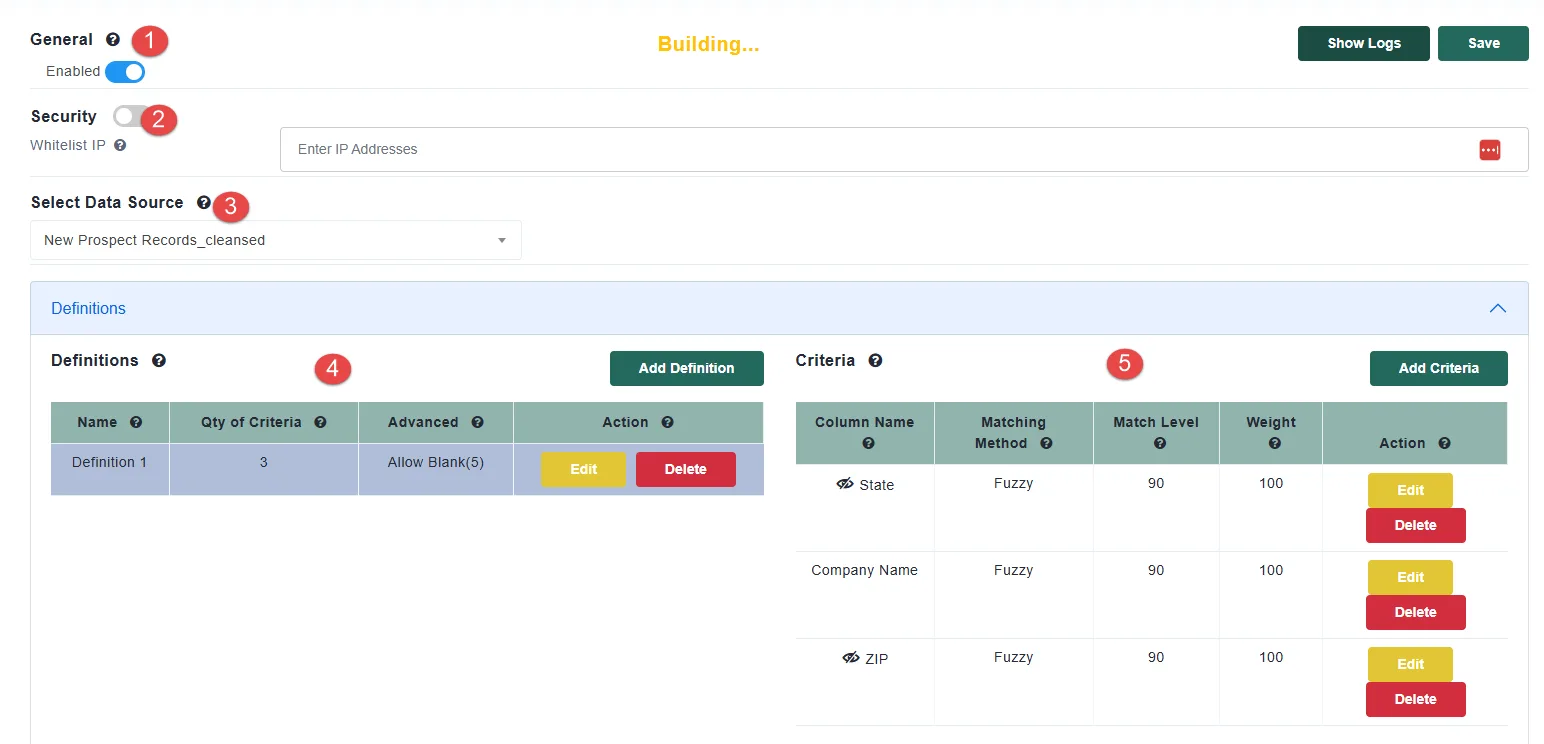
  1. El módulo se inicia en estado desactivado. Actívalo para activar el punto final.
  2. Si tienes previsto hacer pública o accesible desde el exterior la función «Live Fuzzy Search», puedes restringir el acceso introduciendo una o varias direcciones IP autorizadas. Se rechazarán todas las llamadas a la API que procedan de direcciones que no figuren en dicha lista.
  3. A continuación, selecciona la fuente de datos en la que deseas realizar la búsqueda. Normalmente se trata de un conjunto de datos depurado que ya ha sido procesado en fases anteriores. A partir de aquí, definirás tus definiciones y criterios de coincidencia, siguiendo el mismo patrón que la coincidencia difusa estándar en Match Data Pro.
  4. Puedes añadir varias definiciones, cada una con su propio conjunto de criterios, y puedes permitir que algunos criterios queden en blanco cuando un campo no siempre esté presente en el registro entrante.
  5. Para cada criterio, deberás indicar si es difuso o exacto. Los criterios exactos se procesan más rápido, por lo que utilizar criterios más exactos siempre que la precisión lo permita ayudará a mantener los tiempos de respuesta por debajo de los 300 milisegundos, que es el objetivo para todas las respuestas de la búsqueda difusa en tiempo real.

Normas de limpieza y análisis sintáctico de direcciones

Antes de que se ejecute una búsqueda, Live Fuzzy Search puede normalizar el registro entrante mediante reglas de limpieza. Esto resulta útil porque los datos de referencia ya se han limpiado y se desea que la consulta entrante sea comparable a ellos.
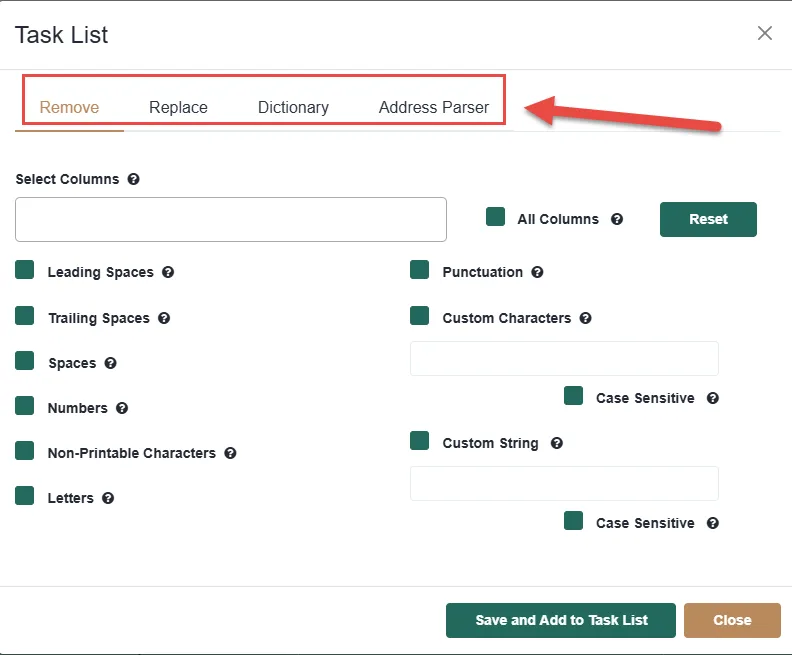
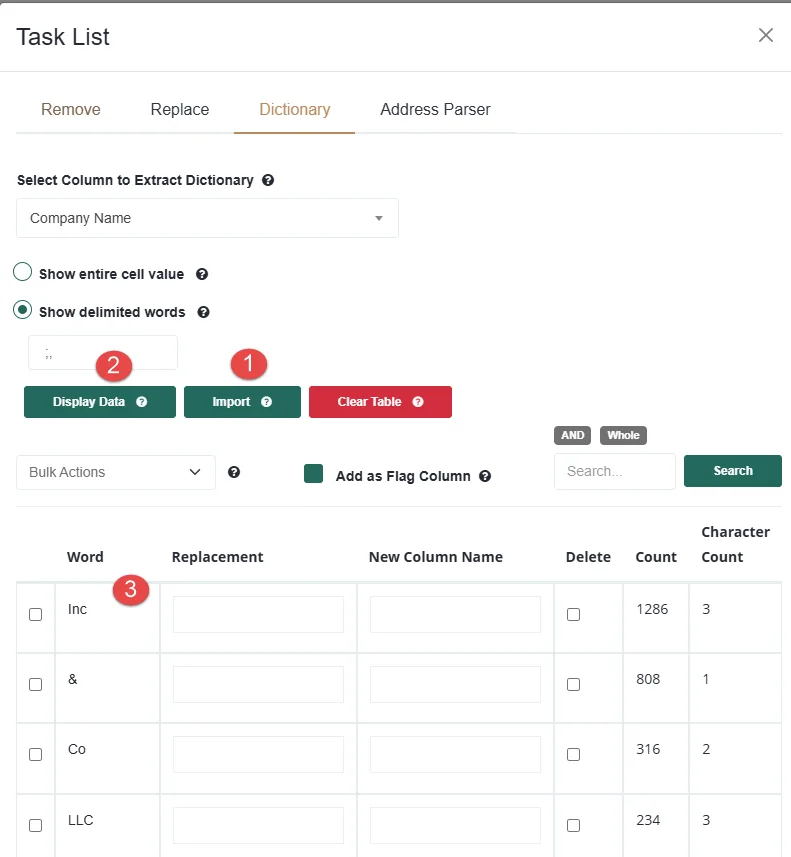
  • Haz clic en «Añadir regla» para elegir entre cuatro tipos de reglas: eliminar caracteres, sustituir datos, aplicar un diccionario o utilizar el analizador de direcciones.
  1. La regla del diccionario resulta especialmente útil para normalizar los valores con ruido.
    1. Puedes importar tu propio diccionario,
    2. o crear uno directamente a partir de tu fuente de datos haciendo clic en «Mostrar datos».
    3. Esto divide el conjunto de datos en tokens y te muestra los valores que aparecen con mayor frecuencia. A partir de ahí, puedes identificar los tokens de ruido que merman la precisión de la coincidencia y eliminarlos o sustituirlos; por ejemplo, sustituyendo el símbolo «&» por la palabra «y» para normalizar los nombres de las empresas.
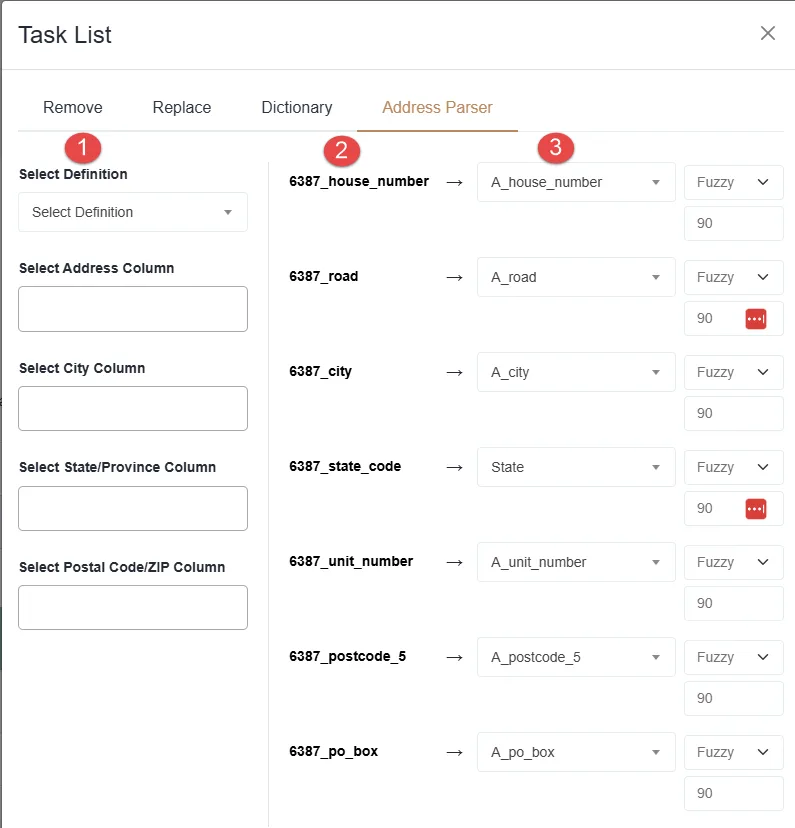
  2. Para la coincidencia de direcciones, utiliza la regla «Address Parser».
    1. Añade tu definición y especifica tus criterios: dirección 1, dirección 2, ciudad, provincia y código postal.
    2. El analizador asignará automáticamente estos datos a sus respectivos componentes de dirección: número de casa, nombre de la calle, ciudad, código de provincia, número de piso, código postal y número de apartado de correos. La asignación se realiza automáticamente mediante lógica difusa, pero debes revisar y corregir cualquier campo que se haya asignado incorrectamente.
    3. Una vez asignados, configura el tipo de coincidencia para cada componente. El número de la vivienda debe ser exacto. El nombre de la calle o vía debe ser aproximado. La ciudad debe ser aproximada. El código de la provincia debe ser exacto. El número de piso debe ser exacto. El código postal debe ser exacto. El número de apartado de correos debe ser exacto.
  3. Para gestionar tu lista de reglas, elimina las reglas duplicadas o que no desees haciendo clic en la «X» situada junto a cada regla, o selecciona varias reglas y utiliza el botón «Eliminar» para borrarlas todas a la vez.

Opciones de respuesta y la llamada a la API

La sección «Opciones de respuesta» controla los resultados que muestra Live Fuzzy Search cuando encuentra coincidencias. Hay tres categorías.
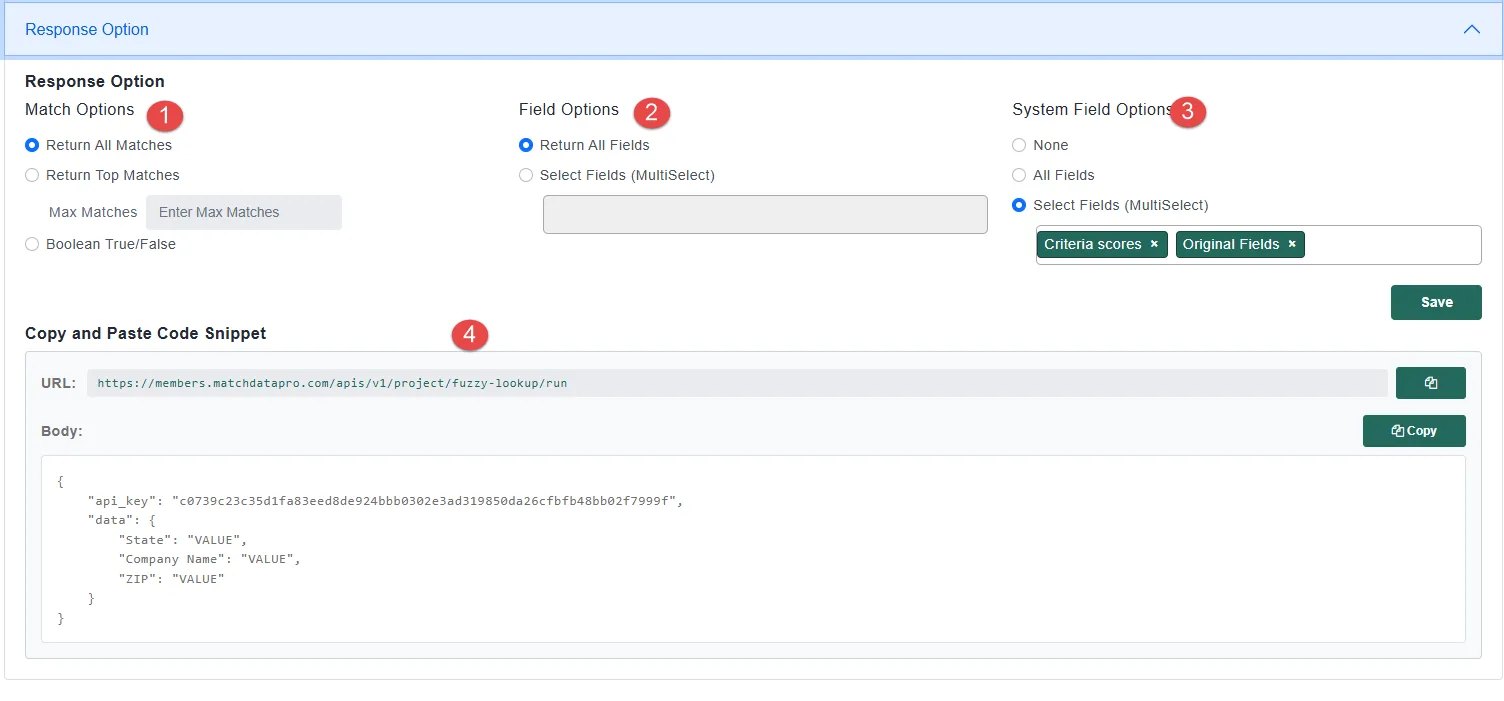
  • Partidos
  • Hacer coincidir columnas
  • Opciones de campos del sistema


  1. Partidos
    • Por defecto, devuelve todas las coincidencias encontradas.
    • La función «Top N Match» solo devuelve los resultados con mayor puntuación según la cantidad definida.
    • El operador booleano devuelve simplemente «verdadero» o «falso», lo cual resulta útil cuando solo necesitas saber si existe un duplicado, y no cuál es.
  2. Campos coincidentes
    • En «Opciones de campos», puedes elegir que se muestren todos los campos de los registros coincidentes,
    • o seleccionar solo un subconjunto concreto de campos.
  3. Opciones de campos del sistema: puedes devolver ninguno, todos o una selección de los campos generados por el sistema.
    • «Match Definition» devuelve el número entero o los números enteros de la definición de coincidencia que se corresponden con la definición encontrada.
    • La función «Criteria Scores » devuelve puntuaciones individuales para cada criterio.
    • El «Número de registro» indica la posición del registro coincidente dentro del conjunto de datos.
    • El «Nombre de la fuente de datos» identifica de qué fuente de datos procede la coincidencia.
    • «Original Fields» devuelve los valores que has enviado en la llamada a la API.
  4. Una vez configuradas las opciones de respuesta, la llamada a la API completa se genera automáticamente al hacer clic en «Guardar». El panel muestra la URL del punto final y la estructura completa de la llamada, que deberás copiar y pegar en tu aplicación. Sustituirás dinámicamente los valores de los marcadores de posición por tus propios datos en tiempo de ejecución.

Almacenamiento, generación de datos y registros

  • Al hacer clic en «Guardar», Live Fuzzy Search comienza a cargar la fuente de datos seleccionada en la memoria. Este índice en memoria es lo que permite buscar entre 5 millones de registros en menos de 300 milisegundos.
  • Es importante destacar que, si estás actualizando una configuración existente de Live Fuzzy Search, no se produce ningún tiempo de inactividad durante la reconstrucción. Mientras se cargan los nuevos datos, los datos actuales siguen atendiendo las solicitudes. Una vez que el nuevo índice se ha cargado por completo, la transición se produce en menos de un milisegundo. Puedes actualizar tus datos con la frecuencia que necesites sin interrumpir el funcionamiento de la API.
  • Para consultar el historial de actividad, abre el panel «Registros». En él se muestra un registro completo de todas las llamadas a la API que se han realizado, así como de cada vez que se han actualizado los datos. Esto resulta útil para supervisar el uso, resolver problemas y confirmar que las reconstrucciones de datos se han completado correctamente.

Preguntas frecuentes

Cualquier conjunto de datos de referencia que figure como fuente de datos en tu proyecto de Match Data Pro. Entre los casos de uso más habituales se incluyen los nombres de clientes, los nombres de empresas, los registros de proveedores, los historiales de pacientes y las direcciones. Si puedes importarlo a MDP, podrás hacerlo accesible a través de Live Fuzzy Search.

Las respuestas están diseñadas para devolverse en menos de 300 milisegundos. La velocidad exacta depende del tamaño de tu conjunto de datos y del número de criterios exactos frente a los difusos que utilice tu configuración. Los criterios exactos se procesan más rápido que los difusos, por lo que utilizar la coincidencia exacta cuando la precisión lo permita ayudará a mantener los tiempos de respuesta lo más bajos posible.

Se puede hacer, pero no es recomendable. Live Fuzzy Search está diseñado para realizar búsquedas en un conjunto de datos de referencia depurado. Las reglas de depuración integradas en el módulo tienen como objetivo normalizar los registros de las consultas entrantes para que sean comparables con tu fuente de datos ya depurada, no para sustituir un proceso completo de depuración de los propios datos de referencia.

La opción «All matches» devuelve todos los registros que cumplen tus criterios de coincidencia, ordenados por puntuación. La opción «Top 1» devuelve únicamente el registro con la puntuación más alta. La opción «Boolean» devuelve «true» si existe alguna coincidencia y «false» si no hay ninguna. Utiliza la opción «Boolean» cuando solo necesites detectar duplicados y no necesites saber qué registro ha coincidido.

Sí. Puedes introducir una o varias direcciones IP permitidas en la configuración. Cualquier llamada a la API que se origine desde una dirección que no figure en esa lista quedará bloqueada. Si dejas la lista de direcciones IP permitidas vacía, el punto final estará abierto a cualquier usuario que disponga de la URL.

No se interrumpe nada. Mientras los nuevos datos se cargan en la memoria, los datos actuales siguen atendiendo las solicitudes con normalidad. Una vez que el nuevo índice se ha creado por completo, la transición se produce en menos de un milisegundo. No hay tiempo de inactividad ni interrupción en la disponibilidad.

Sí. Match Data Pro permite tener varias instancias del mismo tipo de módulo dentro de un mismo proyecto. Puedes añadir una «Live Fuzzy Search» por cada conjunto de datos, cada una con su propia configuración y punto final.


La coincidencia según criterios estándar compara cadenas de direcciones completas. El analizador de direcciones desglosa una dirección en sus componentes individuales —número de casa, nombre de la calle, ciudad, código de provincia, número de apartamento, código postal y apartado de correos— y compara cada componente de forma independiente, con su propia configuración de coincidencia aproximada o exacta. Esto permite obtener una coincidencia de direcciones más precisa, especialmente cuando las direcciones contienen abreviaturas, números de apartamento que faltan o pequeñas diferencias de formato.

Las puntuaciones por criterio muestran la puntuación de coincidencia individual de cada criterio de tu definición, en lugar de limitarse a la puntuación global de la definición. Esto resulta útil cuando quieres saber exactamente qué campos han determinado una coincidencia o una coincidencia parcial; por ejemplo, si un nombre coincide en un 98 %, pero la dirección solo coincide en un 60 %.

Sí. Cuando la opción «Campos originales» está activada, la respuesta de la API devuelve los valores exactos que has enviado en la consulta. Esto resulta útil para el registro de eventos, la depuración y para confirmar que tu aplicación está enviando los datos esperados.

Comienza tu primer proyecto

Para comenzar, haga clic en el botón Nuevo proyecto desde el panel de control.