
Para la mayoría de los equipos de datos, la respuesta es «comprar», a menos que se cuente con un equipo de ingeniería dedicado, una autonomía financiera de más de 12 meses y un problema de correspondencia único que ninguna herramienta existente pueda resolver. Desarrollar un sistema de resolución de entidades desde cero cuesta mucho más de lo que sugieren las cuotas de licencia si se tienen en cuenta el desarrollo de algoritmos, la lógica de bloqueo, las reglas de supervivencia, el mantenimiento continuo y el coste de oportunidad que supone que los ingenieros no trabajen en el producto principal.
¿Quieres ver cómo funciona la resolución de entidades con tus propios datos? Prueba Match Data Pro de forma gratuita: sin compromiso y sin necesidad de configurar ninguna infraestructura.
Lo que realmente hay que crear para la resolución de entidades
La resolución de entidades es el proceso de determinar qué registros de varios conjuntos de datos se refieren a la misma entidad del mundo real: un cliente, una empresa, un proveedor o un paciente. Parece sencillo. En la práctica, implica al menos seis líneas de trabajo de ingeniería distintas:
- Perfilado e ingesta de datos. Es necesario saber con qué datos se cuenta antes de poder realizar comparaciones. La cardinalidad de los campos, las tasas de valores nulos y las variaciones de formato: todo ello debe catalogarse. Descubre cómo el perfilado de datos basado en IA agiliza este paso.
- Estandarización y limpieza de datos. «Robert Smith», «Bob Smith» y «R. Smith» son la misma persona. «123 Main St» y «123 Main Street, Ste 4» pueden ser la misma dirección. Tu proceso debe normalizar todos estos datos antes de realizar la comparación.
- Agrupación e indexación. Comparar cada registro con todos los demás a una escala de un millón de registros requiere cuatrillones de comparaciones. Se necesita una estrategia de agrupación —claves fonéticas, índices de n-gramas o vecindad ordenada— para reducir esto a un conjunto de candidatos manejable.
- Cálculo de similitud. Distancia de Levenshtein, Jaro-Winkler, Soundex, ratio de conjuntos de tokens: cada tipo de campo requiere un algoritmo diferente. Un campo de nombre y un campo de número de teléfono no deben utilizar la misma función de comparación.
- La lógica de la supervivencia y los registros de referencia. Una vez que se han emparejado dos registros, ¿qué valores de los campos prevalecen? ¿Los más recientes? ¿Los más completos? ¿Los de la fuente más fiable? Estas reglas deben diseñarse, programarse y someterse a pruebas. Descubre cómo funcionan en la práctica las reglas de supervivencia y los registros de referencia.
- Registro de auditoría y explicabilidad. Los equipos de cumplimiento normativo y gobernanza de datos necesitan saber por qué se han fusionado dos registros. Tu sistema debe registrar cada decisión de coincidencia con pruebas a nivel de campo.
Cada línea de trabajo constituye un proyecto de ingeniería en sí mismo. Y cada una de ellas debe mantenerse a medida que aumentan los volúmenes de datos y cambian los sistemas de origen.
El verdadero coste de desarrollar internamente un sistema de resolución de entidades
Los costes de ingeniería son el factor más importante en la opción de desarrollo. Un equipo formado por dos ingenieros de datos de nivel medio-alto que desarrollen un proceso fiable de resolución de entidades suele necesitar entre 6 y 18 meses para que el sistema esté listo para su puesta en producción. A 150.000 dólares por ingeniero al año, eso supone entre 150.000 y 450.000 dólares solo en salarios, sin contar la infraestructura, el control de calidad ni la documentación.
Estos costes se acumulan tras la puesta en marcha. Cada nueva fuente de datos requiere un reajuste. Cada cambio en el esquema de un sistema fuente conlleva el riesgo de que se rompa la lógica de bloqueo. Cada cambio en las reglas de negocio —una fusión, un cambio de marca, una expansión internacional— requiere horas de trabajo de ingeniería para actualizar los umbrales de coincidencia y las rutinas de estandarización.
Los costes ocultos son la causa más frecuente de que los proyectos de construcción se descarrilen:
- Corrección de falsos positivos. Los registros fusionados de forma incorrecta provocan errores posteriores en el CRM, la facturación y los análisis. Las colas de revisión manual suponen un elevado coste operativo.
- Desviación del algoritmo. Un umbral que funcionaba con 500.000 registros puede generar tres veces más falsos positivos con 5.000.000 de registros. El reajuste requiere conocimientos especializados.
- Dependencia del talento. Si el ingeniero que diseñó tu esquema de bloqueo se marcha, te quedarás con un vacío de conocimientos crítico. La documentación rara vez recoge todo el razonamiento.
Un coste total de propiedad realista para un sistema de resolución de entidades desarrollado internamente a lo largo de tres años: entre 500.000 y 1,5 millones de dólares, incluyendo personal, infraestructura y corrección de errores.
Qué te ofrece una plataforma especializada en resolución de entidades
Una plataforma diseñada específicamente para este fin se entrega con la infraestructura de ingeniería ya resuelta. La coincidencia aproximada y la resolución de entidades en Match Data Pro combinan algoritmos aproximados configurables con Senzing, un motor de resolución de entidades probabilístico basado en grafos que utilizan organizaciones de inteligencia y de servicios financieros.
Lo que esto significa en la práctica:
- Algoritmos configurables listos para usar. Levenshtein, Jaro-Winkler, coincidencia fonética, ratio de tokens y conjuntos, y mucho más: se pueden seleccionar según el tipo de campo, sin necesidad de código personalizado.
- Sugerencias de coincidencias generadas por IA. La plataforma muestra pares candidatos y recomienda si deben considerarse coincidentes o no en función de patrones históricos, lo que reduce considerablemente el tiempo de revisión por parte de los analistas.
- Resolución de entidades de Senzing. En entornos complejos con múltiples fuentes, la resolución de entidades de Senzing gestiona la vinculación probabilística entre fuentes a gran escala: se trata del mismo motor que utilizan organismos públicos e instituciones financieras.
- Reglas de supervivencia sin código. Las reglas de victoria a nivel de campo se configuran en la interfaz de usuario. La fuente más reciente, más completa y más fiable: todo ello sin necesidad de intervención del equipo de ingeniería.
- Conectores de importación/exportación y API REST. Los datos se importan desde archivos CSV, conexiones a bases de datos o API. Los resultados se envían a tu CRM, almacén de datos o sistema posterior a través de la API de búsqueda difusa en tiempo real y los puntos finales REST.
Plazo de implementación con una plataforma SaaS en la nube: de días a semanas, en lugar de meses o años.
Cuando construir tiene sentido
La opción «build» no siempre es incorrecta. Tiene sentido en un conjunto limitado de condiciones:
- Escala extrema con lógica de comparación propia. Si estás comparando 10 000 millones de registros al día con un algoritmo específico del sector que ningún proveedor admite, una solución a medida puede ser la única opción viable.
- Requisitos estrictos de residencia de datos. Algunos sectores regulados exigen que los datos nunca salgan de un entorno específico. Nota: muchas plataformas, entre ellas Match Data Pro, admiten la implementación local, lo que elimina este inconveniente para la mayoría de los equipos.
- La correspondencia es tu producto principal. Si la resolución de entidades es el producto que vendes —y no solo la infraestructura que necesitas—, es probable que necesites propiedad intelectual propia. El caso de un proveedor de plataformas que desarrolle una función de deduplicación para sus clientes es un caso legítimo de desarrollo.
Fuera de estos casos, la construcción supone un coste y un retraso adicionales sin aportar ninguna ventaja competitiva.
Un marco para la toma de decisiones: cinco preguntas que hay que plantearse
Plantéate estas cinco preguntas antes de decidirte por cualquiera de las dos opciones:
- ¿Cuántos registros y fuentes abarca el proyecto? Si son menos de 10 millones de registros procedentes de 3 fuentes o menos, una plataforma en la nube lo gestiona sin problemas. Si son más de 100 millones de registros procedentes de más de 20 fuentes, plantéate una infraestructura del nivel de Senzing.
- ¿Cuál es el plazo necesario para obtener resultados? Si la empresa necesita resultados en 60 días, desarrollar una solución desde cero no es una opción realista. Las plataformas pueden generar las primeras coincidencias a las pocas horas de conectarse.
- ¿Dispone de los conocimientos especializados necesarios en su propia empresa? La lógica de filtrado, el ajuste de umbrales y la selección de algoritmos requieren competencias especializadas. La mayoría de los equipos de ingeniería de datos no cuentan con conocimientos especializados en resolución de entidades.
- ¿Con qué frecuencia cambiarán tus reglas de correspondencia? Si las reglas de negocio cambian cada trimestre —nuevas líneas de productos, expansión regional, incorporación de nuevas fuentes de datos—, necesitas una plataforma configurable, no una lógica predefinida.
- ¿Cuál es tu tolerancia total de costes a lo largo de tres años? Compara los costes de las suscripciones SaaS con el coste total de propiedad (TCO) realista de una solución propia, incluyendo el tiempo de ingeniería, la infraestructura y el mantenimiento.
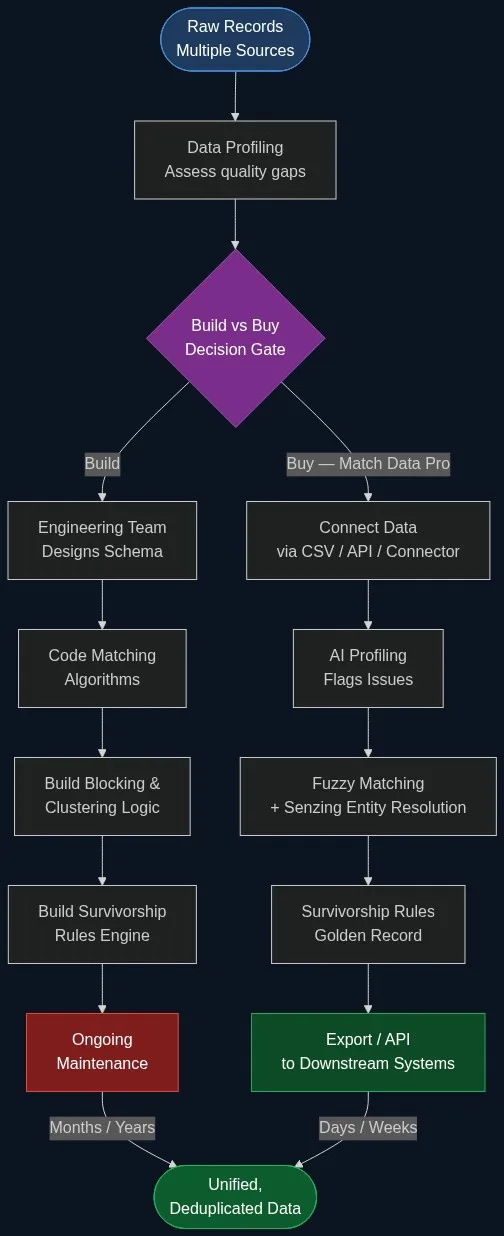
Match Data Pro está diseñado para equipos que necesitan una resolución de entidades de nivel de producción sin tener que pasar por un ciclo de desarrollo de 12 meses. La plataforma incluye la coincidencia aproximada y la resolución de entidades, la elaboración de perfiles de datos, la limpieza de datos, la integración con Senzing, las reglas de supervivencia y la exportación, todo ello en una única plataforma SaaS en la nube sin contrato a largo plazo.
Comparación entre Match Data Pro y una solución a medida
La tabla siguiente compara los aspectos clave de las opciones de desarrollo propio y adquisición. Para una evaluación más exhaustiva de las herramientas de cotejo de datos, la guía para compradores de software de cotejo de datos explica detalladamente los criterios de evaluación.
| Dimensión | Configuración personalizada | Datos de partidos Pro |
|---|---|---|
| Tiempo hasta el primer partido | De 6 a 18 meses | De horas a días |
| Configuración del algoritmo | Desarrollado internamente | Configurable a través de la interfaz de usuario, sin necesidad de programar |
| Integración de Senzing | Crear y mantener | Integrado en |
| Normas de supervivencia | Diseñado a medida para cada proyecto | Configurable en la interfaz de usuario |
| API REST y conectores | Crear y mantener | Incluido |
| Coste total de propiedad (TCO) a 3 años (típico) | Entre 500 000 y 1,5 millones de dólares | Suscripción a SaaS |
| Carga de mantenimiento | Alto — equipo interno | Bajo — gestionado por el proveedor |
| Escalado | Requiere una reingeniería | Nativo de la nube, elástico |
Empieza una prueba gratuita y ejecuta hoy mismo tu primer trabajo de resolución de entidades. O solicita una demostración para ver cómo funciona la resolución con tecnología de Senzing en tus propios datos.
Preguntas frecuentes
¿Cuánto tiempo se tarda en desarrollar un programa de resolución de entidades partiendo de cero?
La mayoría de los equipos necesitan entre 6 y 18 meses para que un sistema de resolución de entidades desarrollado a medida esté listo para su puesta en producción. Ese plazo abarca la selección de algoritmos, la lógica de bloqueo, las reglas de supervivencia, el control de calidad y la documentación, y no tiene en cuenta el mantenimiento continuo, ya que los volúmenes de datos y los sistemas de origen cambian con el tiempo.
¿Cuál es el principal riesgo de desarrollar internamente un sistema de resolución de entidades?
El principal riesgo es la concentración del conocimiento. Los procesos de resolución de entidades implican decisiones especializadas —el diseño de bloqueos clave, la calibración de umbrales, la selección de algoritmos según el tipo de campo— que rara vez se documentan adecuadamente. Cuando el ingeniero que diseñó el sistema abandona la empresa, la organización se queda con una infraestructura frágil y poco comprendida, cuya modificación resulta costosa.
¿Puede una plataforma SaaS en la nube gestionar la resolución de entidades a escala empresarial?
Sí. Las plataformas modernas de SaaS en la nube admiten la resolución de entidades a escala empresarial mediante estrategias de bloqueo, procesamiento paralelo y motores integrados como Senzing —que utilizan las agencias de inteligencia y las principales instituciones financieras para resolver miles de millones de registros—. La infraestructura elástica en la nube implica que la plataforma se encarga de la escalabilidad, y no tu equipo interno de ingeniería.
¿Qué es Senzing y por qué es importante para la resolución de entidades?
Senzing es un motor de resolución de entidades probabilístico basado en grafos que crea redes de relaciones entre registros sin necesidad de un identificador compartido. Evalúa variantes de nombres, cambios de dirección, datos parciales y variaciones temporales para determinar la identidad de las entidades. Match Data Pro integra Senzing de forma nativa, lo que permite disponer de una resolución de nivel empresarial sin necesidad de un proyecto de integración a medida. Lee la guía completa sobre la resolución de entidades de Senzing para obtener más detalles técnicos.
¿Cómo puedo valorar si me conviene desarrollar o adquirir una solución de resolución de entidades?
Empieza por cinco preguntas: ¿Cuántos registros y fuentes están incluidos en el alcance? ¿Cuál es el plazo necesario para obtener resultados? ¿Dispones de personal especializado en la comparación de datos dentro de la empresa? ¿Con qué frecuencia cambiarán las reglas? ¿Cuál es tu tolerancia de costes a tres años vista? Si respondes a más de dos de estas preguntas de forma que se prioricen la rapidez y la flexibilidad, la adquisición de una plataforma diseñada específicamente para este fin casi siempre resulta más ventajosa en cuanto al coste total de propiedad.