
La fusión de datos mediante coincidencia es el proceso de identificar registros que representan la misma entidad del mundo real en uno o más sistemas de origen y, a continuación, consolidarlos en un único registro de referencia —el «registro de oro»— mediante reglas de supervivencia configurables y estrategias de resolución de conflictos a nivel de campo. Sin una fase de fusión rigurosa, incluso un proceso de coincidencia difusa perfectamente ajustado genera datos maestros duplicados, fragmentados o contradictorios que corrompen los sistemas CRM, ERP y de análisis posteriores.
Esta guía abarca todo el proceso de fusión de registros: desde la generación de pares candidatos hasta el diseño de reglas de supervivencia, la selección de estrategias de fusión, la gestión de conflictos y la publicación del registro de referencia. Cada sección incluye ejemplos técnicos concretos extraídos de flujos de trabajo reales de deduplicación de CRM, MDM y RevOps.
¿Qué es la fusión de coincidencias? Definición de los conceptos básicos
La fusión de coincidencias se sitúa en la intersección de dos operaciones distintas: la coincidencia —determinar que dos o más registros se refieren a la misma entidad— y la fusión —consolidar esos registros en un único resultado canónico—. Muchos equipos tratan estas operaciones como un único paso, pero funcionan según una lógica y unos modos de fallo fundamentalmente diferentes.
La correspondencia es un problema de puntuación probabilístico o determinista. La fusión es un problema de gobernanza y resolución de conflictos. Confundir ambos conceptos da lugar a arquitecturas en las que los umbrales de correspondencia se ajustan para compensar una lógica de fusión deficiente, o en las que cada par coincidente se fusiona automáticamente sin tener en cuenta las diferencias en la calidad de los datos a nivel de campo entre las distintas fuentes.
Términos clave
- Pareja de candidatos: dos o más registros señalados por el motor de coincidencia como posibles co-referentes, que superan un umbral mínimo de puntuación.
- Regla de supervivencia: una política configurada que determina qué valor de campo de un clúster coincidente «sobrevive» y pasa a formar parte del registro de referencia.
- Registro de referencia: El único registro oficial resultante de la fusión de un clúster candidato, que representa la verdad más conocida sobre esa entidad.
- Agrupar clúster: el conjunto completo de registros de origen que se considera que representan una única entidad; puede contener desde dos hasta varias docenas de registros, dependiendo de la superposición entre los sistemas de origen.
- Conflicto a nivel de campo: una situación en la que registros emparejados contienen valores diferentes e irreconciliables para un mismo atributo (por ejemplo, dos números de teléfono distintos para la misma empresa).
- Puntuación de confianza de la fuente: una ponderación configurada que clasifica los sistemas de origen según su fiabilidad para tipos de atributos específicos; por ejemplo, se considera que el CRM es fiable para el nombre del contacto, mientras que el ERP lo es para la dirección de facturación.
Para profundizar en la fase de coincidencia, consulta nuestra guía sobre qué es la coincidencia aproximada y cómo funciona.
El proceso completo de fusión de coincidencias: etapa por etapa
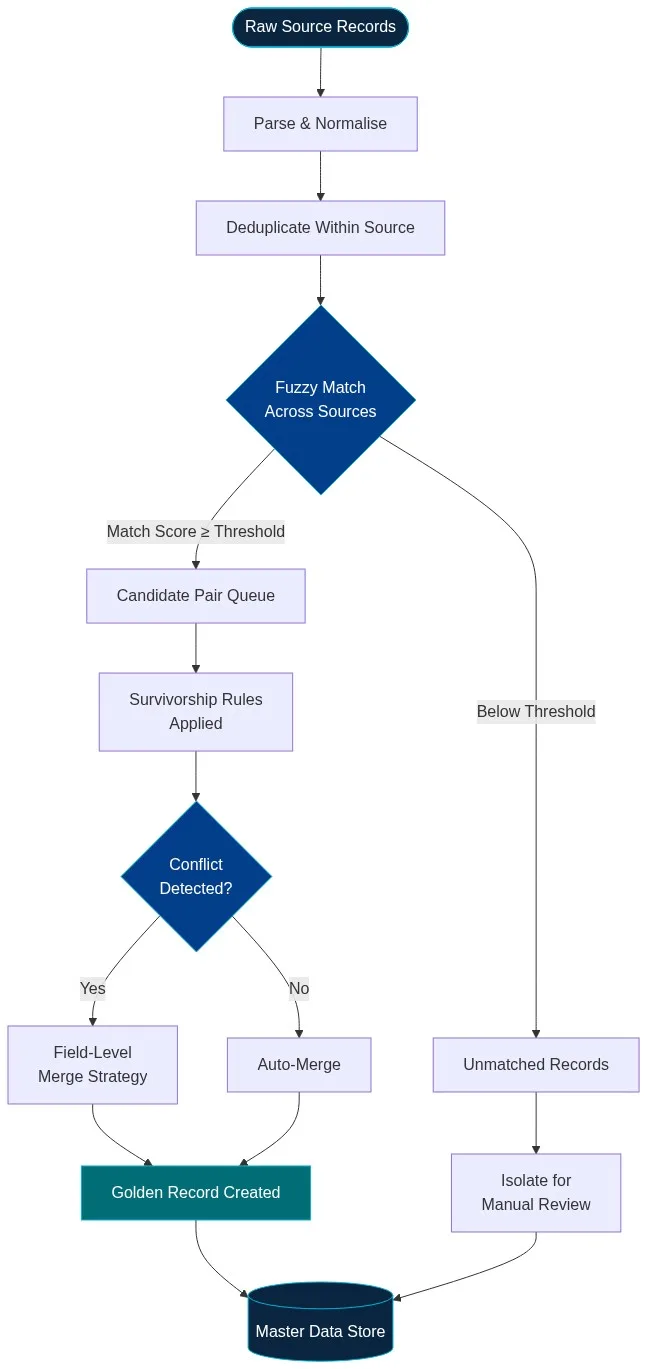
El siguiente diagrama muestra el proceso completo, desde la ingesta de datos sin procesar hasta la publicación del registro de referencia.
Etapa 1: Análisis y normalización
Antes de que pueda realizarse cualquier proceso de emparejamiento, los registros sin procesar deben normalizarse. Los números de teléfono se adaptan al formato E.164. A los nombres de las empresas se les eliminan los sufijos legales (Ltd, LLC, Inc) y se escriben en minúsculas. Las direcciones se desglosan en número de calle, nombre de la calle, ciudad, provincia y código postal. Sin esta normalización, dos registros correspondientes a «Acme Corporation, Inc.» y «ACME Corp» obtendrían una puntuación baja en una simple comparación de cadenas, a pesar de que se trata claramente de la misma entidad.
Consulta nuestra guía completa sobre limpieza de datos para conocer las técnicas de normalización aplicables a los tipos de campos más habituales.
Etapa 2: Deduplicación dentro de la misma fuente
Realiza una pasada de deduplicación en cada sistema de origen antes de llevar a cabo la comparación entre fuentes. Esto reduce considerablemente el conjunto de pares candidatos y evita que los clústeres de fusión alcancen tamaños inmanejables.
Etapa 3: Coincidencia aproximada entre fuentes
El motor de coincidencia puntúa cada par de registros utilizando una puntuación de similitud compuesta. Para obtener un desglose detallado de los algoritmos de puntuación y la calibración de los umbrales, consulta nuestra guía sobre algoritmos de puntuación de las reglas de coincidencia.
Fase 4: Aplicación de las normas de supervivencia
Para cada campo de cada grupo candidato, una regla de supervivencia determina qué valor de origen se introduce en el registro de referencia.
Etapa 5: Detección de conflictos y estrategia de fusión a nivel de campo
Cuando las reglas de supervivencia no permiten determinar un ganador inequívoco, se aplica una estrategia de fusión a nivel de campo. Las opciones son: tomar el valor más reciente, tomar el valor más completo, concatenar todos los valores o marcarlo para su revisión manual.
Etapa 6: Publicación del «Disco de Oro»
El registro definitivo se guarda en el almacén de datos maestros y se vincula a todos los registros de origen que lo han generado mediante punteros de linaje. Los registros de origen no se eliminan, sino que permanecen en sus sistemas de origen.
Estrategias basadas en la regla de supervivencia: una comparación técnica
| Estrategia | Cómo funciona | Lo mejor para | Riesgo |
|---|---|---|---|
| Prioridad de la fuente | Clasificar los sistemas de origen; tomar el valor del sistema de origen mejor clasificado que tenga un valor distinto de nulo | Campos en los que un sistema es el de referencia | Es posible que la fuente preferida esté desactualizada |
| Más recientes | Toma el valor con la marca de tiempo de modificación más reciente | Campos que se actualizan con frecuencia: dirección, teléfono, correo electrónico | Es posible que la última entrada sea un error de introducción de datos. |
| El más completo | Puntuá cada valor según su exhaustividad; selecciona el valor con la puntuación más alta | Campos de dirección y datos de contacto con índices de cumplimentación variables | La exhaustividad no implica exactitud |
| Bandera de verificación | Toma el valor marcado como «verificado» por un servicio de enriquecimiento de terceros | Campos de dirección, teléfono y correo electrónico con datos de enriquecimiento | Depende de la cobertura del servicio de enriquecimiento |
Resolución de conflictos sobre el terreno: ejemplos reales
Escenario 1: Números de teléfono de la empresa que no coinciden
Un registro del CRM muestra +1-415-555-0100 (introducido en 2021), mientras que un registro de automatización de marketing muestra +1-415-555-0177 (introducido en 2024). Aplica la regla de «recencia» únicamente cuando el valor más reciente supere la comprobación de validación de formato. Si la validación falla, recurre a la regla de «prioridad de la fuente».
Escenario 2: Nombre de la filial frente al de la empresa matriz
Una fuente indica «Acme Widget Division» y otra, «Acme Corporation». El motor de fusión debería escribir el nombre de la entidad matriz en company_name y el nombre de la división a un doing_business_as campo.
Escenario 3: Discrepancia en las cifras de ingresos
El ERP registra unos ingresos recurrentes anuales (ARR) de 4,2 millones de dólares; el CRM, de 3,8 millones. El ERP es el sistema de referencia para los datos financieros. Una regla de prioridad de fuentes resuelve esto de forma clara, pero solo si la configuración de «supervivencia» asigna explícitamente el campo de ingresos a la fuente del ERP.
Consulta nuestra guía sobre la elaboración de perfiles de datos con IA para obtener una explicación detallada sobre cómo crear perfiles antes de configurar la supervivencia.
La fusión de registros en la práctica: guía paso a paso sobre la deduplicación en CRM
Paso 1: Perfilado y normalización
Realiza un análisis de perfiles de datos mediante IA en las tres fuentes. Resultados: puntuaciones de exhaustividad a nivel de campo, mapas de distribución de formatos y una estimación de duplicados entre fuentes.
Paso 2: Configurar el bloqueo y la coincidencia
Aplica el bloqueo a los tres primeros caracteres del nombre normalizado de la empresa más el código del estado. Consulta nuestra guía sobre la coincidencia aproximada de nombres para conocer las mejores prácticas en la selección de algoritmos.
Paso 3: Configurar la supervivencia por campo
- nombre_de_la_empresa: Prioridad de la fuente — Salesforce
- billing_address: Indicador de verificación — Se da prioridad al valor certificado por CASS; si ninguno está verificado, se utiliza el más reciente
- Teléfono: Recencia con control de validación de formato
- ingresos_anuales: Prioridad de la fuente — Exportación del ERP
Paso 4: Ejecutar, revisar y publicar
Se han consolidado 280 000 registros de entrada en aproximadamente 174 000 registros de referencia, lo que supone una reducción del 38 %. Para obtener una visión general completa, consulta nuestra guía sobre la comparación y fusión de datos y la guía del comprador de 2026.
Errores habituales al fusionar coincidencias y cómo evitarlos
- Utilizar una única estrategia de supervivencia para todos los campos. Configurar la supervivencia a nivel de campo, no a nivel de registro.
- No se conservan los punteros de linaje. Los registros de referencia deben conservar las referencias a todos los registros de origen que los han generado.
- La fusión automática es demasiado agresiva. Comprueba siempre la distribución de las puntuaciones de coincidencia antes de fijar un umbral.
- Se omite la deduplicación dentro de una misma fuente antes de la comparación entre fuentes. Los duplicados internos no resueltos aumentan el tamaño de los clústeres.
- No se está ejecutando una ronda de validación tras la fusión. Realiza comprobaciones de integridad y coherencia tras la creación del registro de referencia.
- Considerar la fusión de coincidencias como una operación que solo se realiza una vez. Un proceso de fusión de coincidencias debe ejecutarse de forma incremental según un calendario establecido.
Preguntas frecuentes
¿Cuál es la diferencia entre la coincidencia y la fusión en un flujo de datos?
La coincidencia determina que dos o más registros se refieren a la misma entidad del mundo real mediante la asignación de una puntuación a su similitud. La fusión agrupa esos registros coincidentes en un único registro canónico —el «registro de referencia»— mediante la aplicación de reglas de supervivencia para resolver los conflictos a nivel de campo.
¿En qué consisten las reglas de supervivencia en la fusión de datos?
Las reglas de supervivencia son políticas configuradas que determinan qué valor de origen de un campo determinado «se mantiene» en el registro de referencia cuando varios registros coincidentes contienen valores diferentes. Entre las estrategias más habituales se encuentran la prioridad de origen, el más reciente, el más completo y el indicador de verificación.
¿Cómo se configuran los umbrales de fusión automática para la fusión de coincidencias?
Los umbrales de fusión automática deben calibrarse mediante el muestreo de pares coincidentes en distintos rangos de puntuación y su revisión manual para comprobar su exactitud. Los pares con menor nivel de confianza deben derivarse a una cola de revisión humana, en lugar de fusionarse automáticamente.
¿Qué es un «disco de oro» y en qué se diferencia de un «registro maestro»?
Un «registro de referencia» es el resultado del proceso de fusión de registros: una única representación oficial de una entidad, construida a partir de los mejores valores de los atributos de todos los registros de origen que contribuyen a ella. Todos los registros de referencia son registros maestros, pero no todos los registros maestros son registros de referencia.
¿Es posible ejecutar la fusión de registros de forma incremental, en lugar de como un trabajo por lotes completo?
Sí, y así debería ser en los procesos de producción. Match Data Pro admite tareas de fusión incrementales programadas con detección de cambios configurable y registro de historial de auditoría.
Empieza hoy mismo a combinar datos más limpios
El motor de fusión de registros de Match Data Pro combina la coincidencia aproximada configurable, las reglas de supervivencia a nivel de campo, la resolución automática de conflictos y el seguimiento completo del linaje, y se puede implementar como SaaS o en las propias instalaciones sin necesidad de un contrato a largo plazo.
Empieza tu prueba gratuita
Reserva una demostración
¿Tienes alguna pregunta? Envíanos un correo electrónico a sales@matchdatapro.com