
La limpieza de datos —también denominada depuración de datos— es el proceso de detectar y corregir errores, incoherencias, duplicados y defectos estructurales en conjuntos de datos sin procesar, de modo que todos los sistemas posteriores utilicen registros precisos y fiables. No se trata de una tarea por lotes que se realiza una sola vez, sino de una etapa repetible y automatizada del flujo de trabajo que se sitúa entre la ingesta de datos y el análisis, el entrenamiento de la IA o la elaboración de informes operativos. Sin ella, todas las conclusiones, modelos y decisiones empresariales basadas en esos datos se asientan sobre arena.
Según un informe de 2025 del IBM Institute for Business Value, el 43 % de los directores de operaciones consideran que los problemas de calidad de los datos son su principal prioridad en este ámbito, y más de una cuarta parte de las organizaciones estiman que pierden más de 5 millones de dólares al año debido a la mala calidad de los datos. Para los ingenieros de datos y los directores de datos (CDO) que gestionan flujos de datos modernos, la limpieza de datos no es un centro de costes, sino un mecanismo de protección de los ingresos.
Esta guía abarca todos los aspectos técnicos de un proceso de limpieza de datos: las seis etapas, los algoritmos que hay detrás de cada una de ellas, ejemplos concretos de flujos de trabajo, una comparación de herramientas y cómo la inteligencia artificial está agilizando cada paso.
Por qué la limpieza de datos es una cuestión de ingeniería de primer orden
Los datos sin procesar proceden de exportaciones de CRM, integraciones de API, fuentes de terceros, formularios web y migraciones de sistemas heredados. Cada una de estas fuentes plantea un tipo diferente de problema de calidad. El efecto acumulativo es grave: un CRM con un 15 % de contactos duplicados, formatos de dirección incoherentes y campos de código postal que faltan no solo genera informes de marketing erróneos, sino que también distorsiona la segmentación de clientes, aumenta el gasto en campañas y interrumpe los procesos de resolución de entidades en las fases posteriores.
La limpieza de datos resuelve problemas en seis niveles:
- Integridad: valores que faltan, campos nulos, cadenas vacías donde debería haber datos.
- Validez: Valores que incumplen una regla de dominio —un código postal de EE. UU. que contiene letras, un importe negativo en una factura, una fecha de nacimiento en el futuro—.
- Coherencia: Una misma entidad representada de forma diferente en distintos sistemas: «IBM Corp», «I.B.M.» e «International Business Machines» se refieren todas a la misma organización.
- Exactitud: valores que están presentes y tienen un formato válido, pero que son erróneos en cuanto a los datos: un número de teléfono invertido, una dirección desactualizada.
- Singularidad: registros duplicados que provocan recuentos inflados, envíos duplicados o facturaciones duplicadas.
- Actualidad: Registros que eran correctos en el momento de su incorporación, pero que desde entonces han quedado obsoletos —direcciones a las que ya no se puede acceder, nombres modificados, cuentas de correo electrónico desactivadas—.
Abordar las seis dimensiones en un proceso estructurado es lo que distingue la limpieza de datos a nivel empresarial de las soluciones puntuales en hojas de cálculo.
El proceso de limpieza de datos en seis etapas
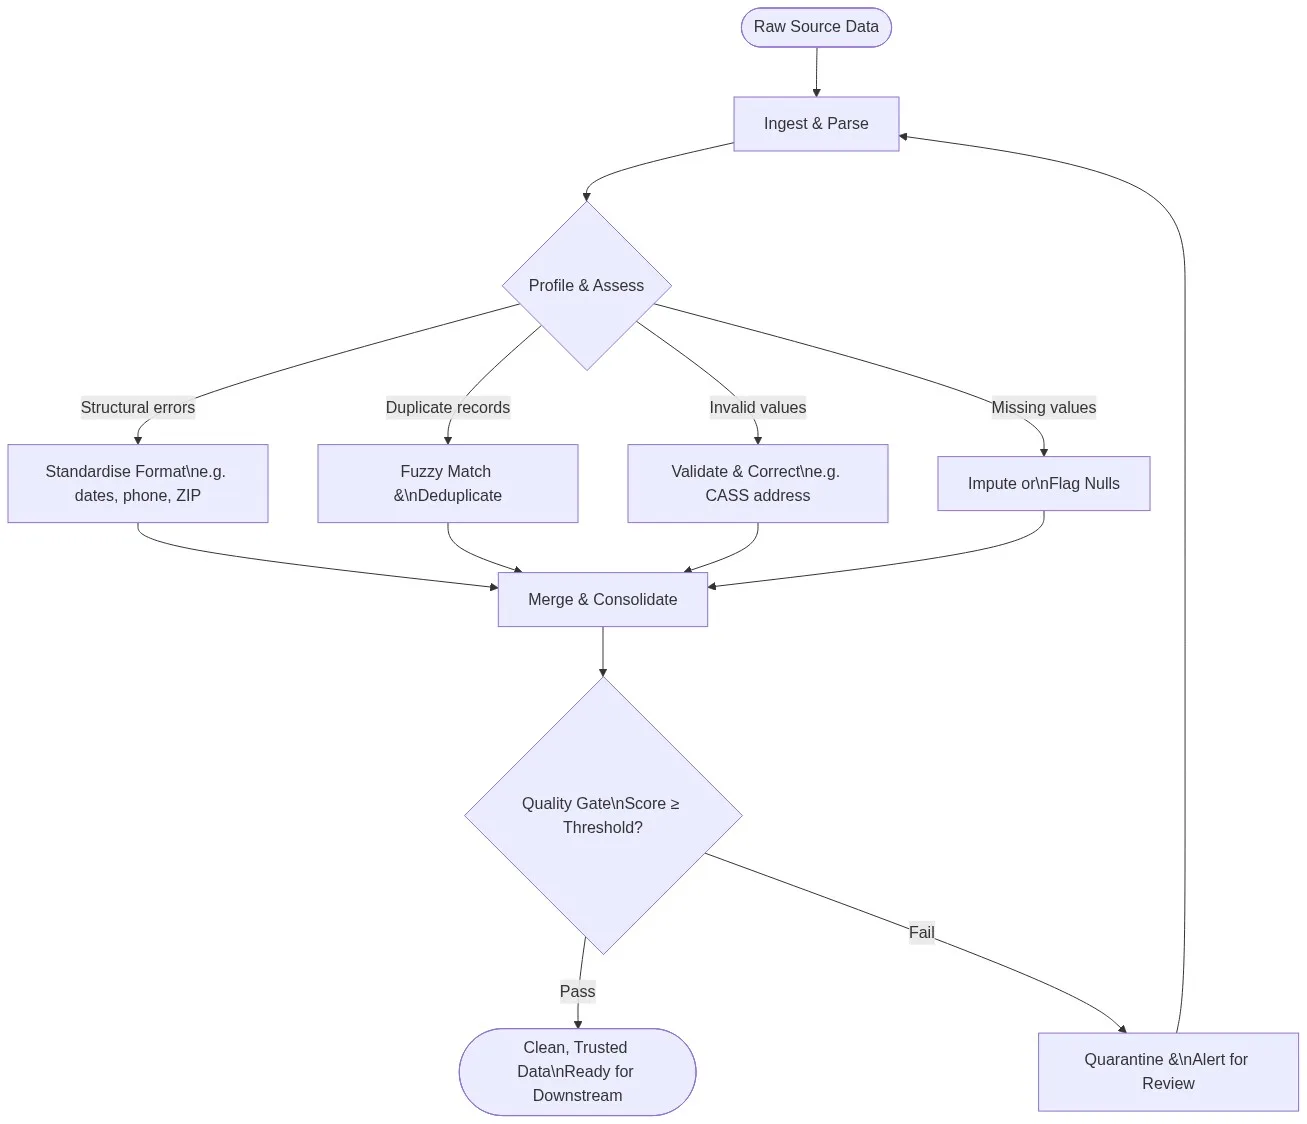
Toda implementación sólida de limpieza de datos sigue un proceso reproducible. El siguiente diagrama ilustra el flujo de principio a fin, desde los datos brutos de origen hasta un resultado limpio y sometido a controles de calidad, listo para su uso en fases posteriores.
Etapa 1: Captura y análisis
Los datos se cargan desde los sistemas de origen a través de conectores: archivos planos (CSV, Excel), bases de datos (SQL, NoSQL), API o fuentes de datos en tiempo real. En esta fase, el objetivo es la integridad estructural: confirmar que los delimitadores de columna son correctos, que la codificación es coherente (los conflictos entre UTF-8 y Latin-1 son habituales en las migraciones de sistemas heredados), que los formatos de fecha se pueden analizar y que los campos numéricos no almacenan tipos mixtos. Los conectores de importación/exportación de Match Data Pro son compatibles con todos los principales formatos de origen y señalan las anomalías de análisis antes de que se aplique cualquier lógica de limpieza.
Fase 2: Análisis y evaluación
Antes de corregir nada, debes evaluar lo que tienes. El análisis de perfiles de datos mediante IA genera una ficha de evaluación de la calidad que abarca las seis dimensiones mencionadas anteriormente: tasas de valores nulos por columna, distribución de valores, frecuencia de patrones, incumplimientos de dependencia entre campos y estimaciones de densidad de duplicados. El resultado de este análisis de perfiles determina las reglas de limpieza que se aplican en las etapas posteriores; en lugar de aplicar transformaciones generales, te centras en las clases de defectos concretas presentes en ese conjunto de datos.
Fase 3 — Estandarizar el formato
La estandarización resuelve las inconsistencias en la representación sin alterar el significado subyacente. Entre las transformaciones más habituales se incluyen:
- Normalización del nombre: «DR. JOHN A. SMITH JR» → campos estructurados: title=»Dr», first=»John», middle=»A», last=»Smith», suffix=»Jr»
- Formato del teléfono: «(800) 555-1234», «8005551234», «+1-800-555-1234» → forma canónica E.164
+18005551234 - Estandarización de fechas: «03/04/26», «3 de abril de 2026», «2026-04-03» → ISO 8601
2026-04-03 - Análisis de direcciones: Desglose de los campos de dirección de texto libre en componentes estructurados (número de calle, nombre de la calle, número de piso, ciudad, estado, ZIP+4), con certificación CASS para validar la entregabilidad comparándola con los datos del USPS.
El motor de verificación de direcciones CASS de Match Data Pro estandariza y valida direcciones postales de EE. UU. por lotes, corrigiendo las abreviaturas de las calles, verificando los códigos ZIP+4 y señalando los registros que no se pueden entregar antes de que lleguen a tu CRM o a tu sistema de gestión de pedidos.
Etapa 4: Coincidencia aproximada y deduplicación
Tras la estandarización, es necesario identificar y resolver los registros casi duplicados. La coincidencia exacta por sí sola no es suficiente: «Jon Smith» y «Jonathan Smith» en la misma dirección nunca darán una coincidencia exacta en el nombre, aunque es casi seguro que se refieran a la misma persona. Los algoritmos de coincidencia aproximada —distancia de edición de Levenshtein, similitud de Jaro-Winkler, códigos fonéticos (Soundex, NYSIIS) y ratio de ordenación de tokens— puntúan los pares de registros según su similitud en varios campos simultáneamente.
En un flujo de trabajo práctico: una empresa de SaaS B2B que fusiona dos exportaciones de CRM (Salesforce + HubSpot) para obtener una visión única del cliente realiza una coincidencia combinada en company_name (Jaro-Winkler ≥ 0,85), domain (exacto), y phone (normalizado exacto). Los registros que superan un umbral compuesto configurado se marcan como duplicados; los que se encuentran en una banda de umbral de «zona gris» se remiten a una revisión humana asistida por IA antes de su fusión.
Para casos con grandes volúmenes de datos o entidades complejas, Match Data Pro integra la resolución de entidades de Senzing, un motor probabilístico basado en grafos que resuelve entidades en millones de registros sin necesidad de reglas de coincidencia predefinidas, aprendiendo los patrones de relación a partir de los propios datos.
Etapa 5 — Validar y corregir
La validación aplica reglas de negocio específicas del ámbito para confirmar la idoneidad de los datos. Ejemplos:
- Las direcciones de correo electrónico deben ajustarse al formato del RFC 5322 Y superar la comprobación del registro MX.
- Los códigos postales de EE. UU. deben tener 5 o 9 dígitos y figurar en el archivo maestro de códigos postales del USPS.
- Los números de identificación fiscal (EIN/SSN) deben ajustarse al formato previsto y a la lógica del dígito de control.
- Las cifras de ingresos deben ser positivas y situarse dentro de un rango plausible para el tamaño de la empresa.
Los registros que no superan la validación se corrigen automáticamente (si se aplica una regla determinista), se marcan para su revisión manual o se ponen en cuarentena y se excluyen de las cargas posteriores, con un registro de auditoría completo.
Fase 6: Control de calidad y carga
Before clean data is written to the target system, a quality gate scores the post-cleansing dataset against configured thresholds (e.g., null rate < 2%, duplicate rate < 0.5%, address deliverability ≥ 95%). If the dataset passes, it loads to the destination. If it fails, the pipeline halts and alerts the data engineering team. This prevents partially-cleansed or regression-degraded data from ever entering production. Match Data Pro’s job automation engine executes this full six-stage pipeline on a configurable schedule, with email and webhook alerting on quality gate failures.
Técnicas de limpieza de datos: una comparación
No todas las técnicas de limpieza son adecuadas para todos los problemas. En la tabla siguiente se relacionan los tipos más comunes de defectos en los datos con la técnica recomendada y sus limitaciones.
| Tipo de defecto | Técnica | Fuerza | Limitación |
|---|---|---|---|
| Registros duplicados | Búsqueda aproximada + deduplicación | Detecta casi duplicados y omisiones de coincidencias exactas | Requiere ajustar el umbral; riesgo de falsos positivos |
| Formatos inconsistentes | Estandarización basada en expresiones regulares | Rápido, determinista y escalable | Es vulnerable ante formatos novedosos; requiere un mantenimiento de las reglas |
| Valores no válidos | Validación basada en reglas | Preciso para dominios conocidos (código postal, teléfono, correo electrónico) | No se pueden detectar valores verosímiles pero erróneos |
| Valores perdidos | Imputación / marcado | Conserva el recuento de registros para su análisis | Los valores imputados pueden introducir sesgos |
| Ambigüedad de entidades | Resolución probabilística de entidades (Senzing) | Resuelve gráficos de identidad complejos con múltiples fuentes | Requiere un gran esfuerzo computacional; es necesario realizar primero un análisis de los datos |
| Errores en la dirección | Verificación de direcciones CASS | Validación de la capacidad de entrega certificada por USPS | Solo direcciones de EE. UU.; para envíos internacionales se requiere un motor independiente. |
| Datos obsoletos o caducados | Captura de datos modificados + revalidación programada | Mantiene los registros actualizados a lo largo del tiempo | Requiere un mantenimiento continuo de las tuberías |
Cómo la IA está transformando la limpieza de datos en 2026
La limpieza de datos tradicional se basaba en reglas creadas manualmente: un ingeniero de datos escribía patrones de expresiones regulares, definía valores umbral y mantenía una biblioteca cada vez más amplia de scripts de transformación. Este enfoque no es escalable. A medida que crecen los volúmenes de datos y aumenta la diversidad de los sistemas de origen, las bibliotecas de reglas se vuelven imposibles de mantener y pasan por alto casos extremos que un analista humano reconocería de inmediato.
Sugerencias de emparejamientos basadas en IA
Los motores modernos de limpieza basados en IA —incluida la coincidencia aproximada impulsada por IA de Match Data Pro— utilizan el aprendizaje automático para sugerir reglas de coincidencia y umbrales de similitud basados en la distribución real de tus datos, en lugar de requerir una configuración manual. El modelo analiza la entropía de los campos, los patrones de coocurrencia y las decisiones de confirmación históricas para identificar en primer lugar los grupos de duplicados más probables, lo que reduce drásticamente la cola de revisión manual.
Detección automática de anomalías
La detección de valores atípicos mediante análisis estadístico señala aquellos valores que, aunque técnicamente válidos, resultan sospechosos en su contexto: un registro de un cliente estadounidense con un número de teléfono con formato británico, un contacto B2B con un dominio de correo electrónico de uso general (gmail.com) en un campo asignado al correo corporativo, o el importe de una transacción que supera en tres desviaciones estándar la media histórica de la cuenta. No se trata de infracciones de las normas, sino de señales que solo una IA capaz de reconocer patrones puede detectar de forma fiable.
Canalizaciones con capacidad de autorreparación
En las arquitecturas de datos maduras, la corrección asistida por IA puede cerrar el ciclo: cuando el modelo tiene confianza en una corrección (por ejemplo, un código postal estadounidense claramente invertido o un número de teléfono reconocible al que le falta el código de país), aplica la corrección automáticamente, registra la transformación y actualiza el cuadro de mando de calidad sin intervención humana. La revisión humana se reserva para correcciones de baja confianza o de alto riesgo.
Para conocer con más detalle cómo el perfilado mediante IA identifica problemas de calidad antes de que comience la limpieza de datos, consulta nuestra guía sobre el perfilado de datos mediante IA para ingenieros de datos.
Limpieza de datos, comparación de datos y fusión de datos
Estas tres operaciones suelen confundirse, pero tienen finalidades distintas en un proceso de control de calidad de datos. Comprender la relación entre ellas es fundamental para diseñar el orden de procesamiento adecuado.
- La limpieza de datos corrige los errores de los registros individuales; no establece relaciones entre ellos.
- Cruce de datos identifica registros en uno o varios conjuntos de datos que hacen referencia a la misma entidad del mundo real, generando pares coincidentes o grupos.
- Fusión de datos consolida los grupos de registros coincidentes en un único registro de referencia, aplicando reglas de supervivencia para seleccionar el mejor valor para cada campo.
La secuencia correcta es siempre: limpiar → comparar → fusionar. Realizar una comparación aproximada con datos sin limpiar da lugar a resultados de menor calidad, ya que las inconsistencias de formato reducen las puntuaciones de similitud de los registros que deberían coincidir. Un número de teléfono almacenado como «(800) 555-1234» y otro almacenado como «8005551234» obtendrán una puntuación baja en la similitud de cadenas a menos que ambos se estandaricen primero a la misma forma canónica. La estandarización durante la fase 3 del proceso de limpieza es un requisito previo para una coincidencia precisa.
Para obtener una explicación detallada de las fases de comparación y fusión, consulta nuestras guías: «¿Qué es la comparación aproximada?» y «Guía de comparación y fusión de datos 2026».
Herramientas de limpieza de datos: qué hay que tener en cuenta en 2026
A la hora de evaluar las plataformas de limpieza de datos, los equipos de ingeniería de datos y los directores de datos (CDO) deben valorar las siguientes capacidades en función de los requisitos de su pila tecnológica:
- Análisis automático de perfiles antes de la limpieza: la herramienta debería evaluar lo que va a corregir, y no limitarse a aplicar transformaciones generales.
- Algoritmos difusos configurables: los distintos conjuntos de datos requieren diferentes métricas de similitud. Una herramienta que solo admita un algoritmo (por ejemplo, Levenshtein) no ofrecerá un rendimiento óptimo en escenarios de coincidencia fonética o basada en tokens.
- Integración de la verificación de direcciones: la depuración de direcciones certificada por CASS es un requisito imprescindible para cualquier proceso de envío postal, gestión de pedidos o cumplimiento normativo en EE. UU.
- Resolución de entidades a gran escala: en el caso de los datos de clientes procedentes de múltiples fuentes, es necesaria una resolución probabilística de entidades (y no solo la deduplicación por pares) para crear un registro de referencia preciso.
- Automatización y programación de tareas: la limpieza no puede ser un proceso manual. La plataforma debe permitir la ejecución programada, basada en eventos o integrada en el flujo de trabajo.
- Registro de auditoría y trazabilidad: Cada transformación debe quedar registrada con los valores anteriores y posteriores, la regla que se ha activado y el operador o modelo que la ha validado, con fines de cumplimiento normativo y depuración.
- Flexibilidad de implementación: SaaS para una rápida obtención de valor; en las propias instalaciones o en la nube privada para sectores regulados en los que los datos no pueden salir del perímetro de la red.
Match Data Pro ofrece todo lo anterior en una única plataforma. Compáralo con otras alternativas en nuestra «Comparativa de software de calidad de datos 2026».
Preguntas frecuentes sobre la limpieza de datos
¿Cuál es la diferencia entre la limpieza de datos y la validación de datos?
La limpieza de datos detecta y corrige de forma activa los errores, las incoherencias y los duplicados en un conjunto de datos ya existente. La validación de datos es una comprobación basada en reglas que confirma si los datos entrantes cumplen los criterios de calidad definidos antes de que sean aceptados en un sistema. La validación es preventiva (se aplica en el punto de entrada); la limpieza es correctiva (se aplica a los datos que ya se encuentran en el sistema). En un proceso maduro, ambas operan conjuntamente: los filtros de validación evitan nuevos errores en el momento de la ingesta, mientras que los procesos de limpieza corrigen los defectos históricos.
¿Con qué frecuencia se debe realizar la limpieza de datos?
La frecuencia adecuada depende de la velocidad de los datos y del impacto en el negocio. Los datos operativos de alta velocidad (contactos de CRM, registros de transacciones) deben limpiarse de forma continua o con una periodicidad diaria. Los datos de referencia de menor velocidad (catálogos de productos, directorios de proveedores) pueden admitir ciclos de limpieza semanales o mensuales. El principio fundamental es que la limpieza debe realizarse antes de cualquier evento importante posterior: el lanzamiento de una campaña, una migración de datos, un reentrenamiento de un modelo de IA o una auditoría regulatoria. La automatización de tareas de Match Data Pro permite programar con cualquier frecuencia, desde la transmisión en tiempo real hasta tareas por lotes trimestrales.
¿Cuál es el orden correcto para un proceso de limpieza de datos?
La secuencia recomendada es: (1) importación y análisis sintáctico, (2) perfilado y evaluación, (3) estandarización del formato, (4) coincidencia aproximada y deduplicación, (5) validación y corrección, (6) control de calidad y carga. El perfilado debe preceder a todas las demás etapas: no se pueden escribir reglas de limpieza eficaces sin conocer primero la naturaleza de los defectos. La estandarización debe preceder a la comparación: los formatos inconsistentes reducirán las puntuaciones de similitud y provocarán que se pasen por alto duplicados.
¿Puede la IA automatizar por completo la limpieza de datos sin necesidad de una revisión humana?
La IA puede automatizar la mayoría de las transformaciones de alta fiabilidad —estandarización de formatos, detección de duplicados evidentes, correcciones determinísticas de campos— sin necesidad de revisión humana. Sin embargo, los pares de coincidencias de baja fiabilidad, las resoluciones ambiguas de entidades y las decisiones que dependen del contexto empresarial (por ejemplo, ¿deberían fusionarse dos contactos de la misma empresa en un único registro?) siguen beneficiándose de la confirmación humana. La arquitectura práctica es un sistema por niveles: la IA aplica automáticamente las correcciones de alta fiabilidad, deriva los casos dudosos a una cola de revisión y aprende de las decisiones confirmadas para mejorar las tasas de aprobación automática en el futuro.
¿Qué relación existe entre la limpieza de datos y el RGPD y el cumplimiento normativo en materia de datos?
La limpieza de datos guarda una relación directa con varias obligaciones del RGPD. El principio de exactitud (artículo 5, apartado 1, letra d)) exige que los datos personales sean exactos y se mantengan actualizados, lo que requiere procesos de limpieza activos, no instantáneas estáticas. El derecho de supresión (artículo 17) exige que las solicitudes de supresión se apliquen a todos los registros duplicados y entidades fusionadas, lo cual solo es fiable si los datos se han deduplicado correctamente. Una deduplicación incompleta implica que la solicitud de supresión de un contacto solo puede eliminar uno de los tres registros duplicados, lo que deja datos personales en el sistema y genera un riesgo normativo.
Empieza a depurar tus datos con Match Data Pro
Match Data Pro ofrece una plataforma completa de limpieza de datos: creación de perfiles basada en IA, coincidencia aproximada configurable, verificación de direcciones CASS, resolución de entidades Senzing, deduplicación automatizada y programación de tareas; todo ello disponible como SaaS (sin contrato, prueba gratuita inmediata) o mediante implementación local para entornos regulados.
- Compara Match Data Pro con otras opciones →
- Descubre cómo funciona la búsqueda aproximada →
- Descubre la resolución de entidades de Senzing →
¿Estás listo para limpiar tus datos a gran escala? Empieza hoy mismo tu prueba gratuita: sin compromiso y sin necesidad de tarjeta de crédito. O ponte en contacto con nuestro equipo en sales@matchdatapro.com para concertar una demostración técnica adaptada a tu entorno de datos.