
La limpieza de datos de direcciones es el proceso de analizar, estandarizar, corregir y verificar los registros de direcciones postales, de modo que cada entrada de la base de datos sea entregable, tenga un formato coherente y no contenga duplicados. Un registro de direcciones limpio no solo reduce el correo devuelto: es la base para una identificación fiable de los clientes, unos análisis precisos y unas operaciones de datos que cumplan con la normativa. Sin un proceso de limpieza estructurado, los errores en las direcciones se acumulan en todos los sistemas que utilizan esos datos.
Según un informe de 2025 del IBM Institute for Business Value, más de una cuarta parte de las organizaciones calculan que pierden más de 5 millones de dólares al año debido a la mala calidad de los datos. Los datos de direcciones son uno de los campos que con mayor frecuencia presentan errores en cualquier sistema CRM, ERP o base de datos de clientes. Esta guía abarca todas las etapas de un proceso de limpieza de direcciones apto para producción, desde los datos brutos hasta un registro maestro verificado y sin duplicados.
¿Estás listo para limpiar tus datos de direcciones ahora mismo? Empieza una prueba gratuita de Match Data Pro y ejecuta tu primera tarea de limpieza de direcciones en cuestión de minutos.
Por qué se deterioran los datos de direcciones y cuánto cuesta ello
Los datos de direcciones tienen una tasa de caducidad natural de aproximadamente entre el 10 % y el 15 % al año. La gente se muda, las empresas se trasladan, los ayuntamientos modifican la clasificación urbanística de las calles y cambian los límites de los códigos postales. En el momento de la introducción de datos, los errores de introducción añaden otra capa de ruido: dígitos invertidos en los códigos postales, números de local que faltan, tipos de calle abreviados que no se ajustan a las normas del USPS y nombres de ciudades que entran en conflicto con el estado indicado.
El coste derivado es tangible. Las direcciones en las que no se puede realizar la entrega provocan devoluciones de correo, entregas fallidas y gasto innecesario en franqueo. En los sistemas CRM, las variantes de dirección crean registros duplicados para un mismo cliente: «123 Main St» frente a «123 Main Street, Suite 400» pueden referirse a la misma ubicación, pero no coincidirán en una comprobación de igualdad de cadenas. Como parte de un marco más amplio de calidad de datos, la limpieza de direcciones suele ser la medida correctiva con mayor retorno de la inversión, ya que su impacto es inmediato y cuantificable.
Problemas habituales relacionados con los datos de direcciones
- Nombres de calles mal escritos: «Pensylvannia Ave» en lugar de «Pennsylvania Ave»
- Abreviaturas inconsistentes: «Street», «St», «St.», «ST» se utilizan indistintamente
- Faltan datos de la dirección secundaria: se han omitido los números de apartamento, suite o unidad
- Códigos postales incorrectos: dígitos invertidos (por ejemplo, «10291» introducido como «10921»)
- Discrepancias entre ciudad y estado: «Brooklyn, NJ» cuando el código postal corresponde a «Brooklyn, NY»
- Campos concatenados: dirección completa almacenada en una única columna de texto sin análisis sintáctico
- Direcciones obsoletas: registros que eran válidos hace tres años, pero a los que ya no se puede realizar la entrega
El proceso de limpieza de datos de direcciones: etapa por etapa
Un proceso de limpieza de direcciones de producción consta de cinco etapas distintas. Cada etapa detecta los errores que la anterior no ha podido detectar. Si se omite una etapa, los errores pasarán a la salida verificada.
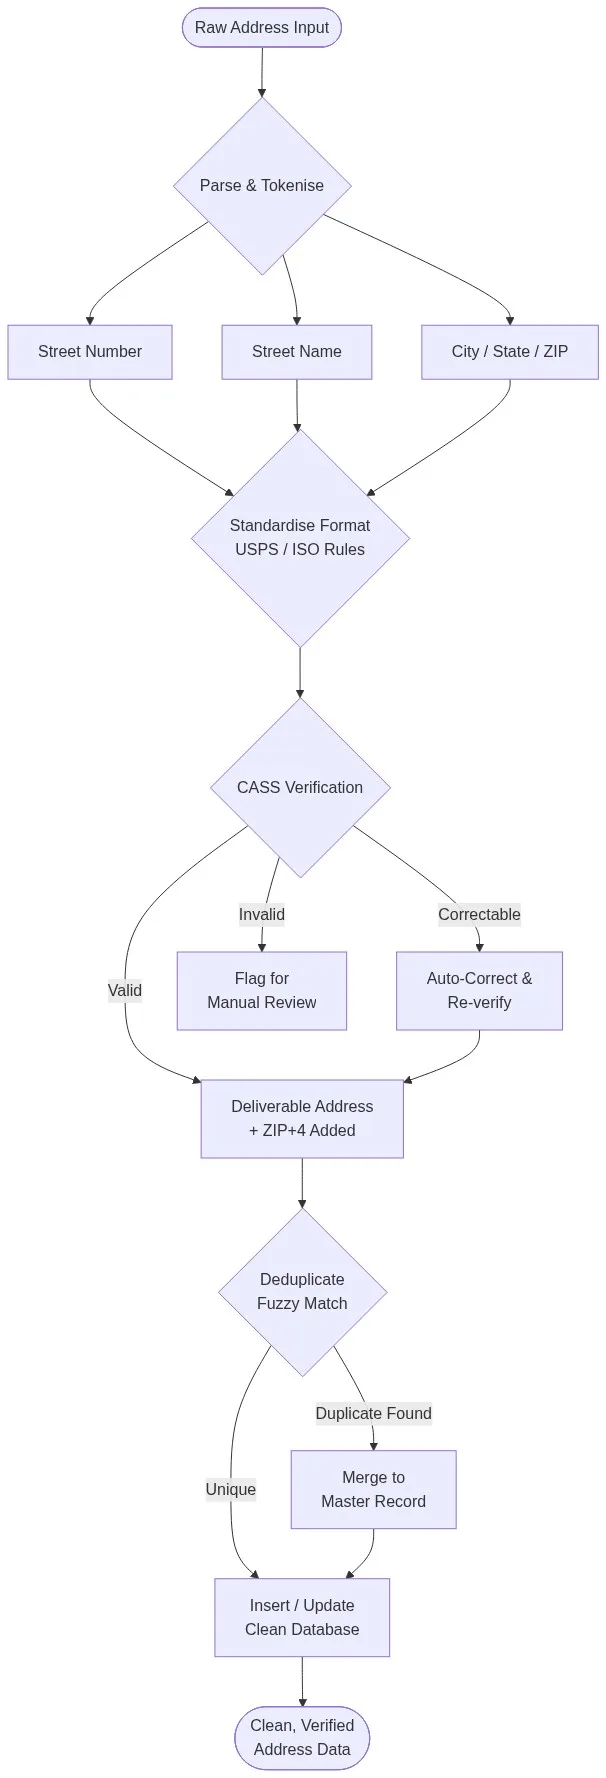
Etapa 1: Análisis sintáctico y segmentación en tokens
Antes de que se pueda realizar cualquier corrección, la cadena de dirección sin procesar debe dividirse en sus componentes: número de casa, parte previa a la dirección, nombre de la calle, sufijo de la calle, parte posterior a la dirección, tipo de vivienda, número de vivienda, ciudad, provincia y código postal. Una dirección concatenada como 123 N Main St Apt 4B, Springfield, IL 62701 debe descomponerse para que cada token pueda validarse de forma independiente.
El análisis sintáctico es más complicado de lo que parece. Direcciones como 1234 St. James Blvd NW Suite 200 contienen la abreviatura de un santo en el nombre de la calle, una dirección cardinal y una unidad secundaria, todas las cuales requieren reglas de tratamiento distintas. Un analizador basado únicamente en expresiones regulares fallará en estos casos. Un analizador de producciones utiliza una combinación de reglas gramaticales y consultas de referencia con los datos de direcciones del USPS.
Fase 2: Adaptar al formato de USPS
Una vez tokenizados, cada componente se normaliza a su forma abreviada oficial del USPS. «Street» pasa a ser «ST», «Avenue» pasa a ser «AVE» y «Northwest» pasa a ser «NW». Los nombres de los estados se convierten a sus códigos postales de dos letras. Los nombres de las ciudades se verifican cotejándolos con el fichero de ciudades y estados del USPS correspondiente al código postal en cuestión.
Esta es también la fase en la que se aplican reglas de correspondencia deterministas para corregir las variaciones conocidas. Una tabla de consulta asocia los errores ortográficos habituales («Pensylvannia» → «Pennsylvania») y las abreviaturas no estándar («Blvrd» → «BLVD») a sus equivalentes canónicos. El resultado de esta fase es una dirección con un formato coherente, pero aún sin verificar.
Fase 3: Certificación CASS y asignación del código ZIP+4
CASS (Coding Accuracy Support System) es la norma de certificación del USPS para los programas informáticos de cotejo de direcciones. Un motor certificado por CASS verifica cada dirección normalizada cotejándola con la base de datos de validación de puntos de entrega (DPV) del USPS, confirma que se trata de una ubicación real en la que se puede realizar la entrega y añade el código ZIP+4 completo, además del código de barras de dos dígitos del punto de entrega.
El proceso CASS devuelve un código de resultado para cada registro:
| Resultados del CASS | Significado | Acción |
|---|---|---|
| Y | Entrega confirmada en la dirección indicada | Aceptar, añadir ZIP+4 |
| S | Dirección normalizada, pero no confirmada por DPV | Aceptar con aviso |
| D | Edificio listo para la entrega, vivienda sin confirmar | Aceptar con indicador de unidad ausente |
| M | Se han encontrado varias direcciones coincidentes | Marcar para la resolución manual de ambigüedades |
| N | Dirección de USPS no válida | Marcar para revisión manual o descartar |
El módulo de limpieza de direcciones de Match Data Pro realiza la verificación CASS en modo por lotes o mediante API en tiempo real, y devuelve el código de resultado, la dirección corregida y el código ZIP+4 completo en una única respuesta. Los registros que devuelven un «N» se ponen en cuarentena para su revisión, en lugar de pasar silenciosamente a las fases posteriores del proceso.
Etapa 4: Coincidencia aproximada para la detección de duplicados
Incluso tras la verificación CASS, dos registros pueden referirse a la misma ubicación física. Consideremos estos dos registros en un CRM:
| ID del registro | Nombre | Dirección (sin procesar) | Después de CASS |
|---|---|---|---|
| A-001 | Acme Corp | 123 Main St, Chicago, IL 60601 | 123 MAIN ST, CHICAGO, IL 60601-1234 |
| A-002 | ACME Corporation | Calle Main, 123, oficina 100, Chicago, Illinois 60601 | 123 MAIN ST, LOCAL 100, CHICAGO, IL 60601-1234 |
Ambos superan la verificación a través de CASS. Sin embargo, pueden corresponder a la misma entidad jurídica ubicada en el mismo edificio; en uno de los registros simplemente se omite el número de despacho. Una comprobación de igualdad de cadenas no detectará esto. Una coincidencia aproximada que utilice la distancia de Levenshtein o la similitud basada en tokens con respecto a la cadena de dirección estandarizada otorgará a estos registros una puntuación de similitud de aproximadamente el 92 %. En combinación con la coincidencia de nombres (Acme Corp frente a ACME Corporation obtiene una puntuación de ~88 %), una regla de coincidencia puede marcar estos registros con seguridad como duplicados.
Etapa 5: Fusionar con el registro maestro
Una vez identificados los duplicados, una regla de selección determina qué valores de los campos se mantienen en el registro de referencia. En el caso de los datos de dirección, la lógica de selección suele dar prioridad a la dirección verificada por CASS frente a la entrada sin procesar, al registro actualizado más recientemente en el caso de los datos de contacto y al registro más completo en el caso de los campos de dirección secundarios. El proceso completo de fusión y eliminación se explica en detalle en nuestra guía específica.
Limpieza de direcciones frente a verificación de direcciones: diferencias clave
Estos términos suelen utilizarse indistintamente, pero describen operaciones diferentes. Es importante comprender la distinción a la hora de definir el alcance de un proyecto de calidad de datos.
| Funcionamiento | Para qué sirve | Resultado | ¿Está implicado CASS? |
|---|---|---|---|
| Análisis sintáctico de direcciones | Divide una cadena de dirección en sus componentes | Tokens estructurados | No |
| Estandarización de direcciones | Normaliza las abreviaturas y el formato | Formato uniforme | No |
| Verificación de la dirección | Confirma que la dirección existe y que se puede realizar la entrega en ella | Resultado del DPV + ZIP+4 | Sí |
| Limpieza de direcciones | Todo lo anterior, además de la deduplicación | Registro maestro limpio y fusionado | Sí |
| Enriquecimiento de direcciones | Añade datos adicionales (provincia, CBSA, latitud/longitud) | Registro enriquecido | Opcional |
Un proceso completo de limpieza de direcciones lleva a cabo las cuatro operaciones de forma secuencial. Si se detiene en la verificación sin realizar la deduplicación, quedan registros duplicados en la base de datos. Si se detiene en la estandarización sin realizar la verificación, quedan direcciones no entregables en el resultado final.
Limpieza de direcciones internacionales: consideraciones adicionales
CASS solo se aplica a direcciones nacionales de EE. UU. La depuración de direcciones internacionales requiere un enfoque diferente para cada país o autoridad postal:
- Canadá: La certificación SERP (Programa de Evaluación y Reconocimiento de Software) abarca la validación de direcciones canadienses utilizando datos de Canada Post.
- Reino Unido: El PAF (Postcode Address File) de Royal Mail es la referencia oficial para la verificación de direcciones en el Reino Unido.
- Australia: El sistema AMAS (Address Matching Approval System) de Australia Post abarca las direcciones australianas
- UE: No existe una norma de certificación única; se utilizan los datos de cada autoridad postal nacional. Los formatos de las direcciones varían considerablemente: en las direcciones alemanas, el número de la casa aparece después del nombre de la calle; en las direcciones francesas, se utilizan los códigos Cedex para las entregas a empresas.
En el caso de los conjuntos de datos globales, la fase de análisis sintáctico debe tener en cuenta las variaciones en el formato de las direcciones según el país antes de que pueda llevarse a cabo la estandarización. Un registro con «Rue de Rivoli 75001 París» requiere una gramática de análisis sintáctico diferente a la de «1600 Pennsylvania Ave NW Washington DC 20500».
El proceso de creación del «disco de oro» para conjuntos de datos internacionales debe tener en cuenta estas diferencias de formato a la hora de definir las reglas de supervivencia: no se puede comparar un código postal del Reino Unido con un código ZIP de EE. UU. utilizando la misma lógica de validación.
Cómo integrar la depuración de direcciones en tu flujo de datos
La limpieza de direcciones puede llevarse a cabo en tres puntos del proceso de tratamiento de datos, cada uno con sus propias ventajas e inconvenientes:
- Punto de entrada (en tiempo real): valida y normaliza las direcciones a medida que se introducen en un formulario web o en la interfaz de usuario de un CRM. Detecta los errores antes de que lleguen a la base de datos. Añade una latencia de entre 50 y 200 ms por registro mediante una llamada a la API. Ideal para la captura de datos de cara al cliente.
- Procesamiento por lotes (programado): ejecuta el proceso completo de limpieza sobre una base de datos existente según una programación: semanal, mensual o antes del envío de una campaña. Gestiona grandes volúmenes sin limitaciones de latencia. Ideal para conjuntos de datos existentes con datos erróneos.
- Integración ETL/pipeline: Incorpora la limpieza de direcciones como un paso de transformación en una tarea ETL que se ejecuta cuando se importan datos desde fuentes externas —importaciones CSV, fuentes de datos de API o migraciones de bases de datos—. Ideal para la importación continua de datos procedentes de múltiples fuentes.
Match Data Pro es compatible con los tres modos. La API de búsqueda y comparación difusa en tiempo real se encarga de la verificación de direcciones en tiempo real en el momento de la introducción de datos. Las tareas por lotes se ejecutan sobre exportaciones completas de la base de datos utilizando reglas de limpieza configurables. Los conectores de importación/exportación son compatibles con Salesforce, HubSpot, bases de datos SQL y archivos planos, sin necesidad de código ETL personalizado.
Si tu organización está desarrollando una aplicación basada en IA o en modelos de lenguaje grande (LLM) a partir de datos de clientes, la limpieza de direcciones es un requisito previo. Los datos de direcciones erróneos afectan negativamente a la geocodificación, la asignación de territorios y los modelos de personalización, y estos problemas resultan difíciles de solucionar una vez que llegan al modelo entrenado.
Preguntas frecuentes
¿Qué es la depuración de datos de direcciones?
La limpieza de datos de direcciones es el proceso integral que consiste en desglosar cadenas de direcciones sin procesar en sus componentes, normalizarlas según el formato del Servicio Postal de Estados Unidos (USPS) o de la autoridad postal correspondiente, verificar su entregabilidad mediante CASS o una certificación equivalente, detectar registros duplicados mediante la comparación aproximada y fusionar los duplicados en un único registro maestro. El resultado es una base de datos de registros de direcciones limpios, entregables y sin duplicados.
¿Con qué frecuencia debería realizar una limpieza de los datos de direcciones?
Los datos de direcciones pierden precisión a un ritmo aproximado del 10-15 % anual debido a los cambios de domicilio de las personas, los traslados de empresas y las actualizaciones de los servicios postales. Para la mayoría de las organizaciones, lo mínimo es realizar una limpieza por lotes cada trimestre. Las bases de datos de CRM o de marketing con gran volumen de datos se benefician de una limpieza mensual, además de una validación en tiempo real en el momento de la introducción de los datos, para evitar que se añadan nuevos registros erróneos entre una ejecución por lotes y otra.
¿Qué es la certificación CASS y por qué es importante?
CASS (Coding Accuracy Support System) es el estándar del USPS para la precisión en la correspondencia de direcciones. El software certificado por CASS ha sido sometido a pruebas por parte del USPS, que ha confirmado que cumple los umbrales de precisión para la estandarización de direcciones y la validación de puntos de entrega. El uso de un motor certificado por CASS garantiza que las direcciones generadas se comparen con la base de datos oficial de puntos de entrega del USPS, lo que te proporciona una confirmación fiable de la entregabilidad, en lugar de una simple correspondencia basada en una suposición.
¿Puede la búsqueda aproximada detectar duplicados de direcciones que CASS no detecta?
Sí. CASS verifica que una dirección sea real y válida para la entrega, pero no compara los registros entre sí para detectar duplicados. Dos registros correspondientes al mismo edificio —uno con número de oficina y otro sin él— superarán ambos la verificación de CASS de forma independiente. La coincidencia aproximada compara las cadenas de direcciones estandarizadas de todos los registros y evalúa su similitud, señalando como posibles duplicados aquellos registros que superen un umbral configurado. La combinación de CASS y la coincidencia aproximada es necesaria para un proceso de limpieza completo.
¿Cómo gestiona Match Data Pro la depuración de direcciones a gran escala?
Match Data Pro procesa los trabajos de limpieza de direcciones en modo por lotes en paralelo con un número de subprocesos configurable, gestionando millones de registros por trabajo. La plataforma aplica el análisis sintáctico, la verificación CASS, la deduplicación difusa y la fusión basada en la supervivencia en un único flujo de trabajo automatizado. Los trabajos se pueden programar, activar a través de la API o ejecutar bajo demanda. Los resultados se devuelven como un archivo de exportación limpio o se escriben directamente en un CRM o una base de datos conectados a través de los conectores disponibles.
Empieza hoy mismo a depurar tus datos de direcciones
Los errores en las direcciones se acumulan de forma silenciosa y suponen un coste económico real en forma de correo devuelto, campañas fallidas y registros de clientes duplicados. Un proceso estructurado de limpieza detiene esa acumulación desde el origen.
Empieza tu prueba gratuita de Match Data Pro y realiza la limpieza de direcciones, la verificación CASS y la deduplicación de tus propios datos, sin contrato ni cuota de alta.
¿Quieres que te guiemos paso a paso por la plataforma? Reserva una demostración con nuestro equipo de datos o ponte en contacto con nosotros directamente en sales@matchdatapro.com.