
Cuando dos empresas se fusionan, sus bases de datos de clientes no se combinan automáticamente en un fichero maestro limpio. La deduplicación de clientes tras la fusión es el proceso de identificar y fusionar los registros duplicados en dos bases de datos operativas o de CRM independientes, con el fin de generar una lista de clientes única, fiable y sin duplicados, con la que ambas organizaciones puedan trabajar inmediatamente después del cierre de la operación. El solapamiento suele ser casi siempre mayor de lo que esperan los equipos de integración: los clientes compartidos, los socios que aparecen en ambos sistemas y los contactos captados en eventos del sector pueden suponer entre el 15 % y el 40 % del total de registros combinados. Sin un proceso estructurado de deduplicación, todos los sistemas posteriores —facturación, marketing, atención al cliente— operan con datos contradictorios.
Reserva una demostración para ver cómo Match Data Pro gestiona de principio a fin la deduplicación de clientes tras una fusión.
Por qué falla la deduplicación de clientes tras una fusión si no se cuenta con la herramienta adecuada
Las dos bases de datos de clientes casi nunca comparten una clave común. La base de datos A utiliza un número de cliente; la base de datos B utiliza el correo electrónico como identificador principal. Una clienta registrada como «Jennifer A. Williams» en un sistema aparece como «Jen Williams» en el otro, con la dirección «123 Oak St Ste 4» frente a «123 Oak Street, Suite 4». Una unión con coincidencia exacta no arroja ningún resultado para ese par.
La conciliación manual no es escalable. Un conjunto de datos combinado de 500 000 registros genera hasta 62 500 millones de pares de comparación. Incluso a un ritmo de un segundo por revisión, un equipo humano no puede procesar ese volumen en un plazo razonable tras el cierre. Los equipos que lo intentan acaban realizando muestreos, pasando por alto duplicados e introduciendo, de todos modos, datos erróneos en el sistema de destino.
La búsqueda aproximada resuelve este problema al evaluar simultáneamente el grado de similitud entre los campos de nombre, dirección, teléfono y correo electrónico, lo que permite detectar variantes que las uniones exactas pasan por alto por completo.
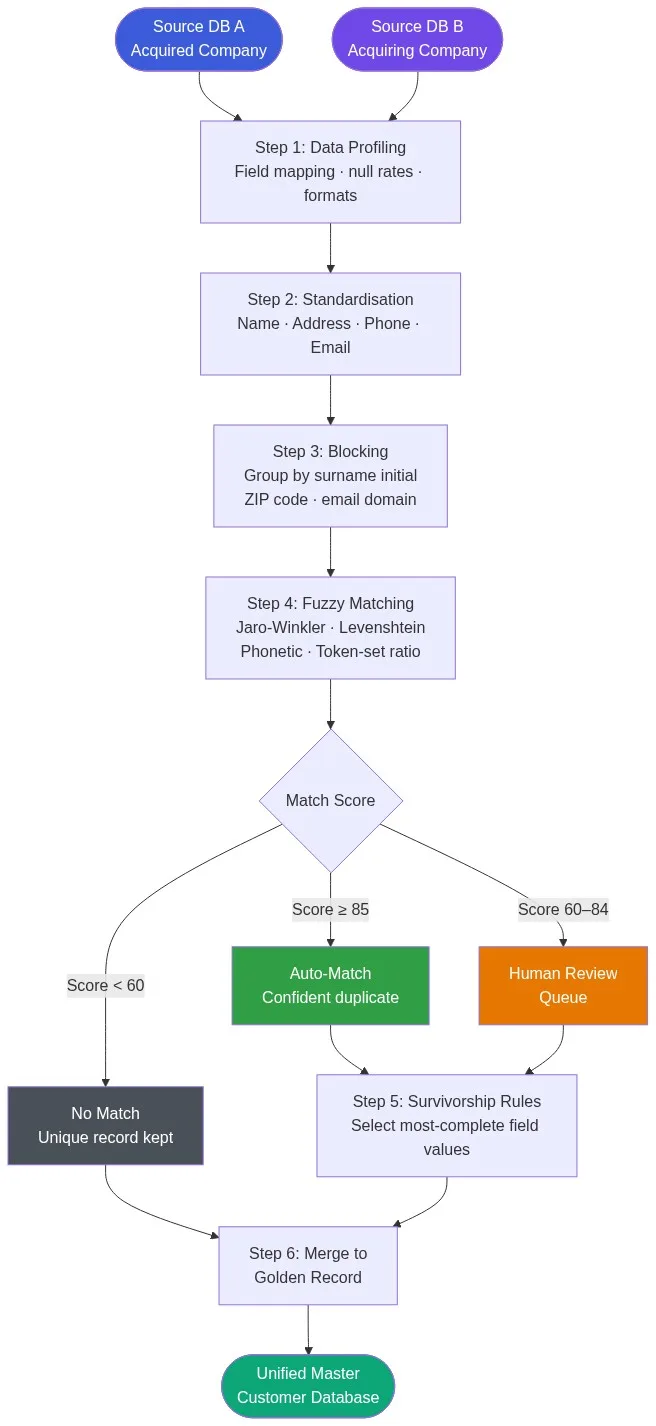
Paso 1: Analizar ambas bases de datos antes de escribir una sola regla de coincidencia
La elaboración de perfiles de datos es la base. Antes de iniciar la comparación, es necesario comprender cada fuente: índices de completitud de los campos, formatos de los nombres, formatos de las fechas, normas de formato de los números de teléfono, convenciones de las direcciones y qué campos están realmente rellenados y son lo suficientemente fiables como para utilizarlos en la comparación.
¿Qué superficies se perfilan?
- La base de datos A tiene un índice de completitud de direcciones de correo electrónico del 94 %; la base de datos B, del 61 %; por lo que la dirección de correo electrónico no puede ser la única clave de coincidencia.
- La base de datos B almacena los nombres completos en un único campo; la base de datos A tiene columnas separadas para el nombre y los apellidos, por lo que es necesario normalizar los datos antes de compararlos.
- Los números de teléfono de la base de datos A incluyen los códigos de país; la base de datos B solo almacena números locales de 10 dígitos, por lo que es necesario realizar un paso previo para eliminar los códigos de país y normalizarlos según la norma E.164.
- Los formatos de las direcciones varían: la base de datos A sigue las normas del USPS; la base de datos B contiene texto libre introducido por los comerciales.
Estos resultados determinan las reglas de mapeo de campos y de estandarización. Si se omite la creación de perfiles, las reglas de correspondencia se calibrarán en función de suposiciones, y no de distribuciones de datos reales.
Paso 2: Estandariza antes de emparejar
La precisión de la coincidencia depende directamente de la calidad de los datos de entrada. Dos registros que correspondan al mismo cliente obtendrán una puntuación baja si en uno aparece «St.» y en el otro «Street», o si en uno el número de teléfono es «(602) 555-0100» y en el otro «6025550100». La limpieza y la estandarización de los datos normalizan estas variaciones antes de que el motor de coincidencia realice la comparación.
Pasos clave de la normalización
- Análisis sintáctico de nombres: Dividir los campos de nombre completo en título, nombre, segundo nombre, apellido y sufijo. Eliminar los tratamiento de cortesía.
- Normalización de direcciones: Despliegar las abreviaturas (St por Street, Ave por Avenue, Ste por Suite). Aplicar la certificación CASS para verificar y normalizar los datos según la base de datos postal del USPS.
- Normalización de números de teléfono: Eliminar los caracteres de formato. Estandarizar a 10 dígitos o al formato E.164. Separar las extensiones en un campo distinto.
- Normalización de direcciones de correo electrónico: Convertir todos los valores a minúsculas. Eliminar los espacios al final. Marcar las direcciones de dominio desechables para que tengan un peso de coincidencia menor.
Tras la estandarización, los pares «Jen Williams / 123 Oak St Ste 4» y «Jennifer A. Williams / 123 Oak Street Suite 4» obtendrán puntuaciones de similitud a nivel de campo superiores a 0,85 tanto en el nombre como en la dirección, lo que se encuentra claramente dentro del umbral de coincidencia automática.
Paso 3: Bloquear registros para facilitar la búsqueda de coincidencias
Comparar cada registro de la base de datos A con cada registro de la base de datos B resulta computacionalmente inviable a gran escala. El bloqueo agrupa los registros en conjuntos de candidatos en los que es probable que haya coincidencias, lo que elimina la gran mayoría de los pares imposibles antes de que comience la puntuación.
Estrategias eficaces de bloqueo para la deduplicación de clientes
- Inicial del apellido + código postal: Agrupa los registros según la primera letra del apellido y el código postal de 5 dígitos. Muy selectivo para conjuntos de datos de gran tamaño.
- Dominio de correo electrónico: Los registros que comparten un dominio de correo electrónico (por ejemplo, @acmecorp.com) se consideran posibles coincidencias, independientemente de las variaciones en el nombre.
- Últimos 4 dígitos del teléfono: Los cuatro últimos dígitos de un número de teléfono normalizado constituyen una clave de bloqueo estable cuando los formatos de los nombres difieren.
- Código Soundex: agrupa los apellidos fonéticamente similares; distingue entre «Smith» y «Smyth» o entre «García» y «Garsia».
El uso de múltiples pases de filtrado —lo que se conoce como «filtrado en múltiples pases»— garantiza un alto nivel de recuperación. Un par de registros que haya pasado desapercibido en el filtro «código postal + apellido» puede ser detectado por el filtro «dominio de correo electrónico». El método de fusión y eliminación aplica esta lógica de múltiples pases de forma automática, lo que garantiza que no quede sin comparar ningún posible duplicado.
Paso 4: Ejecutar la búsqueda aproximada con puntuación ponderada
Dentro de cada bloque, cada par de candidatos recibe una puntuación de similitud compuesta. Match Data Pro evalúa varios algoritmos por campo y los combina para obtener un total ponderado.
Ejemplo: puntuación del par «Jen Williams»
| Campo | DB A Valor | Valor DB B | Algoritmo | Puntuación | Peso |
|---|---|---|---|---|---|
| Apellido | Williams | Williams | Exacto | 1.00 | 0.25 |
| Nombre | Jen | Jennifer | Jaro-Winkler | 0.88 | 0.20 |
| DIRECCIÓN | Calle Oak, 123, local 4 | Calle Oak, 123, oficina 4 | Relación entre conjuntos de tokens | 0.92 | 0.25 |
| Teléfono | 6025550100 | 6025550100 | Exacto (normalizado) | 1.00 | 0.20 |
| Correo electrónico | jwilliams@acme.com | jen.w@acme.com | Coincidencia de dominio | 0.50 | 0.10 |
| Compuesto | 0,91 — Coincidencia automática | ||||
Las puntuaciones superiores a 0,85 se emparejan automáticamente. Las puntuaciones comprendidas entre 0,60 y 0,84 se envían a una cola de revisión manual. Las puntuaciones inferiores a 0,60 se tratan como registros distintos. Estos umbrales son configurables; en el caso de los sectores regulados, se puede elevar el umbral de emparejamiento automático a 0,92 para reducir los falsos positivos.
Paso 5: Aplicar las reglas de supervivencia para crear el «Golden Record»
Una vez identificados los duplicados, debes decidir qué valores de los campos se mantendrán en el registro fusionado. Esto se conoce como «selección de valores», y requiere reglas bien definidas en lugar de una selección arbitraria. Las reglas de selección de valores en Match Data Pro se configuran por campo y por fuente.
Patrones habituales de supervivencia
- Últimos cambios: Utiliza la dirección modificada más recientemente, ya que los clientes se mudan. Aplícalo a los campos de dirección, teléfono y correo electrónico.
- Mayoría de victorias completas: si en un registro aparece un segundo nombre y en el otro no, se mantendrá el valor que figure.
- Prioridad de la fuente: designar un sistema como fuente de referencia para campos específicos. Si el CRM de la empresa adquirente contiene datos de facturación, esos números de cuenta tendrán prioridad.
- Concatenar: en el caso de campos con varios valores, como notas o etiquetas, fusiona todos los valores únicos en lugar de seleccionar uno solo.
El resultado del proceso de resolución de entidades es el «registro de oro»: un perfil único del cliente que combina los mejores datos disponibles de ambos sistemas de origen. La resolución de entidades de Senzing, integrada en Match Data Pro, gestiona casos complejos de resolución de entidades con múltiples fuentes, incluidos los grupos de entidades vinculados mediante grafos en los que un mismo cliente aparece en tres o más registros de origen.
Paso 6: Validar, cargar y supervisar
El conjunto de registros «Golden Record» fusionado debe superar la validación antes de cargarse en el CRM o el almacén de datos de destino. Realiza un análisis de datos tras la fusión para confirmar que: la tasa de duplicados está por debajo del umbral aceptable (normalmente, inferior al 0,5 %), la integridad de los campos no ha disminuido y no se ha perdido ningún registro durante el proceso de fusión.
La supervisión posterior a la carga es importante porque siguen llegando nuevos registros tras la puesta en marcha. La automatización de tareas en Match Data Pro ejecuta una deduplicación incremental según un calendario: compara los nuevos registros entrantes con el conjunto de registros de referencia y deriva los posibles duplicados para su revisión antes de que contaminen la base de datos fusionada. Para ver una comparación completa de las plataformas, consulta nuestra guía sobre el mejor software de deduplicación de datos.
¿Listo para empezar? Regístrate para obtener una prueba gratuita y ejecuta tu primera tarea de deduplicación tras la fusión en menos de 30 minutos, sin necesidad de contrato.
Preguntas frecuentes
¿Cuánto tiempo suele tardar, por lo general, la deduplicación de clientes tras una fusión?
El plazo depende del volumen de registros y de la calidad de los datos, pero un proceso estructurado de seis pasos —perfilado, estandarización, agrupación en bloques, emparejamiento, supervivencia y validación— suele completarse en un plazo de entre dos y cuatro semanas para conjuntos de datos combinados con menos de un millón de registros. Las plataformas automatizadas reducen el paso de emparejamiento en sí a unas pocas horas, por lo que la mayor parte del plazo se dedica al perfilado y a la configuración de reglas.
¿Qué porcentaje de registros suele ser duplicado cuando se fusionan dos bases de datos de clientes?
Los índices de solapamiento varían según el sector. Las empresas B2B que se fusionan dentro del mismo sector suelen presentar un solapamiento del 15 al 35 %. Las bases de datos de consumidores con un amplio solapamiento geográfico pueden superar el 40 %. Realizar un análisis de ambas bases de datos antes de llevar a cabo la comparación permite obtener una estimación fiable antes de decidirse por una estrategia de deduplicación.
¿Puede la búsqueda aproximada gestionar las variaciones internacionales de los nombres en un contexto posterior a una fusión?
Sí. Los algoritmos fonéticos (Metaphone, Beider-Morse) gestionan los nombres transcritos, mientras que Jaro-Winkler se encarga de las transposiciones a nivel de caracteres, habituales en los nombres asiáticos romanizados. Match Data Pro aplica varios algoritmos por campo y selecciona la puntuación más alta, lo que mejora la recuperación de variantes de nombres en diferentes convenciones lingüísticas sin aumentar el número de falsos positivos.
¿Qué es una norma de supervivencia y por qué es importante para los datos posteriores a la fusión?
Una regla de prevalencia determina qué valor de campo se conserva en el registro fusionado cuando dos registros coincidentes contienen valores diferentes. Sin reglas explícitas, las fusiones se rigen por criterios arbitrarios —normalmente, «prevalece el último en escribir»— que pueden alterar datos de alta calidad. Definir reglas por campo (la dirección más reciente, el nombre más completo, prioridad de la fuente para los números de cuenta) permite obtener un «registro de referencia» fiable.
¿Cómo gestiona Match Data Pro los registros que solo figuraban en una de las dos bases de datos?
Los registros que no tienen coincidencia en la otra base de datos —cuya puntuación está por debajo del umbral de no coincidencia— se consideran únicos y se transfieren al conjunto de registros de referencia sin modificaciones. No se descartan. El resultado es una base de datos fusionada que contiene todos los registros únicos de ambas fuentes, además de las versiones deduplicadas de los clientes comunes, con un registro de auditoría completo que muestra la fuente y la decisión de coincidencia para cada registro.