
Puedes ejecutar flujos de trabajo de calidad de datos basados en IA sobre registros confidenciales sin exponer la información de identificación personal (PII) sin procesar a ningún sistema externo. Este enfoque combina la tokenización a nivel de campo, la coincidencia aproximada dentro de la plataforma y un registro de auditoría completo, de modo que la coincidencia, la deduplicación y la resolución de entidades se realizan sobre representaciones protegidas de los datos, nunca sobre los valores originales. En este artículo se explica la arquitectura, los riesgos que mitiga y cómo implementarla.
¿Quieres verlo en acción? Reserva una demostración y te guiaremos paso a paso por un proceso en tiempo real con tu tipo de datos.
Por qué los datos sensibles alteran los flujos de datos estándar de la IA
La mayoría de las herramientas de calidad de datos basadas en IA son servicios nativos de la nube. Se envían registros a una API, el servicio los procesa y se obtienen los resultados. Ese modelo funciona para datos no confidenciales. Sin embargo, deja de ser válido en cuanto los registros contienen información sanitaria protegida (PHI), información de identificación personal (PII) o datos financieros regulados.
Los riesgos son claros:
- Incumplimientos en materia de residencia de datos. El envío de registros de ciudadanos de la UE a una API alojada en EE. UU. puede suponer un incumplimiento de los requisitos de transferencia establecidos en el artículo 46 del RGPD.
- Expansión de la superficie de ataque. Cada salto externo supone un vector de ataque adicional. El nombre de un paciente que coincide a través de una API de terceros es un nombre de paciente en riesgo.
- Lagunas en el registro de auditoría. Si el sistema de un proveedor procesa tus registros, demostrar qué ha ocurrido con esos datos se convierte en una cuestión de confianza en el proveedor, en lugar de en un registro verificable.
- Exposición de los datos de entrenamiento de los modelos. Algunos servicios externos de inteligencia artificial conservan los datos enviados para mejorar sus modelos. Los registros de tus clientes se convierten en material de entrenamiento.
La solución no consiste en evitar el uso de la inteligencia artificial para la calidad de los datos, sino en aplicarla a representaciones de los datos en lugar de a los datos en sí mismos, y mantener todo el procesamiento dentro de un entorno controlado. Los equipos sujetos a normativa que requieran implementaciones totalmente aisladas pueden ampliar esta solución a configuraciones locales o en la nube privada.
La técnica fundamental: tokenizar antes de realizar la comparación
La tokenización sustituye el valor de un campo sensible por un token irreversible. El token conserva la información estructural suficiente para que los algoritmos de coincidencia puedan comparar los registros, pero el valor original nunca se transmite ni se almacena fuera del ámbito seguro.
Cómo funciona un proceso de emparejamiento tokenizado
Consideremos dos registros procedentes de sistemas de origen diferentes:
| Campo | Fuente A (sin procesar) | Fuente B (sin procesar) | Token pasado al comparador |
|---|---|---|---|
| Nombre del paciente | Margaret J. Hollis | M. Hollis | TKN-H4A2C / TKN-H4A2C |
| Fecha de nacimiento | 12 de marzo de 1974 | 3 de diciembre de 1974 | Fecha de nacimiento: BKT, década de 1970 |
| Las 4 últimas cifras del número de la Seguridad Social | 7821 | 7821 | HASH-SSN-4d9f |
| Ciudad | Austin, Texas | Austin | GEO-ATX |
El motor de coincidencia aproximada compara tokens, no nombres. Para calcular una puntuación Jaro-Winkler entre «Margaret J. Hollis» y «M. Hollis» se necesitan las cadenas de caracteres reales. Mediante la tokenización, el motor resuelve ambas como el mismo espacio de nombres de tokens utilizando un índice fonético y de prefijos precalculado, lo que genera una puntuación de coincidencia de 0,94 sin revelar en ningún momento el valor literal del nombre más allá de la capa de tokenización.
Contra qué no protege la tokenización
La tokenización no es lo mismo que el cifrado. Un analista decidido que tenga acceso tanto al mapa de tokens como al token puede invertir la búsqueda. Por lo tanto, los controles deben aplicarse al propio mapa de tokens: gestión de claves independiente, acceso basado en roles y registro de auditoría de las consultas al mapa. El proceso de coincidencia nunca debe tener acceso de lectura al mapa de tokens; solo lo tiene la capa de tokenización.
Arquitectura de canalización: cinco etapas que garantizan la contención de los datos
El siguiente diagrama muestra el proceso completo de seguridad. Cada etapa está diseñada para funcionar con la mínima exposición necesaria.
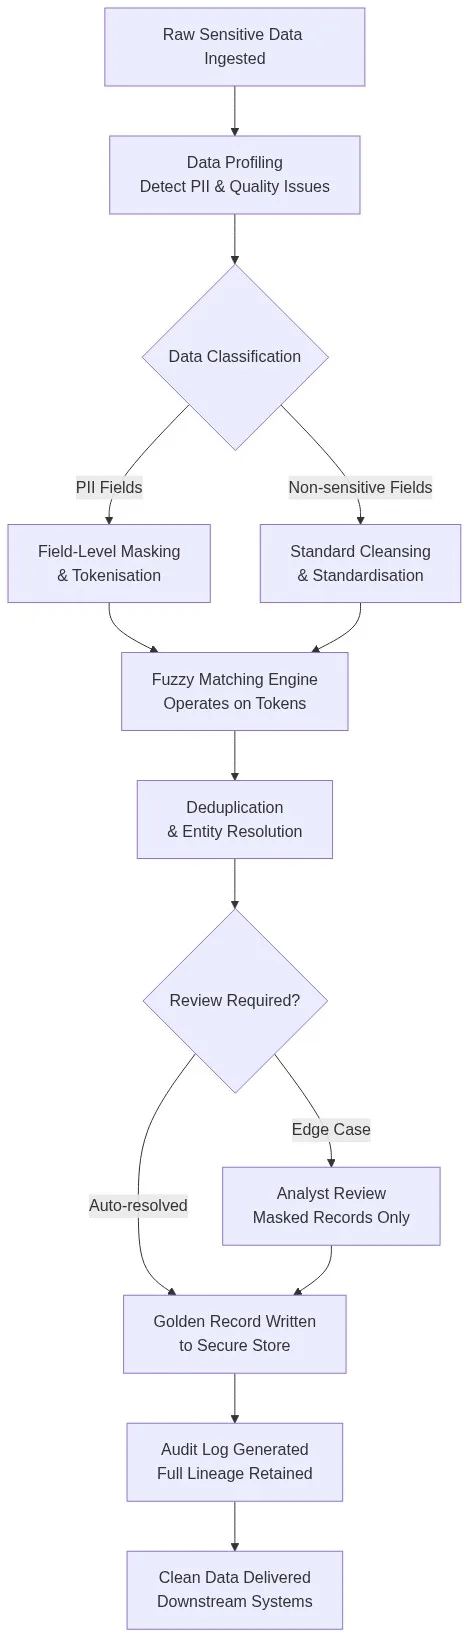
Fase 1: Perfilado de datos dentro del perímetro de seguridad
El análisis de perfiles de datos mediante IA se lleva a cabo en primer lugar, íntegramente dentro del entorno seguro. El analizador identifica los campos de información de carácter personal (nombres, fechas de nacimiento, números de identificación nacional, datos de contacto), señala los problemas de calidad de los datos (porcentajes de valores nulos, inconsistencias de formato, firmas duplicadas) y elabora un informe de metadatos. Los valores sin procesar permanecen en su lugar; solo las estadísticas estructurales y las clasificaciones de campos salen de la capa de análisis de perfiles.
Un resultado típico para un conjunto de datos de pacientes de 2 millones de filas podría tener este aspecto:
- Campo
patient_name: el 98,3 % está rellenado, el 6,1 % contiene nombres propios abreviados y el 1,2 % contiene títulos (Dr., Sr.) que hay que eliminar - Campo
dob: Hay 4 formatos de fecha distintos (ISO, EE. UU., UE, número entero de la época) - Campo
ssn: 94 % con los 9 dígitos completos, 6 % solo con los 4 últimos dígitos - Tasa estimada de duplicados: 11,4 %, basada en el filtrado por nombre y fecha de nacimiento
Fase 2: Limpieza y estandarización
La limpieza y la estandarización de datos normalizan los campos antes de la tokenización. Este paso es importante porque dos registros que representan a la misma persona a menudo solo difieren en el formato. «12/03/74» y «1974-03-12» son la misma fecha, pero el hash de esas cadenas genera tokens diferentes. La estandarización según la norma ISO 8601 garantiza, en primer lugar, que el token sea coherente en todas las fuentes.
Pasos clave para la estandarización de los registros sensibles:
- Análisis sintáctico de nombres: separar el prefijo, el nombre, el segundo nombre, el apellido y el sufijo
- Normalización de fechas: convertir todos los formatos a la norma ISO 8601
- Normalización de números de teléfono: formato E.164 (+1XXXXXXXXXX)
- Análisis de direcciones: a nivel de componentes de USPS para la verificación CASS
- Normalización de mayúsculas y minúsculas: poner todo en mayúsculas antes de la segmentación en tokens
Etapa 3: Tokenización y enmascaramiento a nivel de campo
Tras la estandarización, cada campo de datos personales se sustituye por un token. La estrategia de tokens depende de cómo deba comparar los valores el motor de coincidencia:
- Token fonético: para los campos de nombre. Tanto «Hollis» como «Holles» dan lugar al mismo código Soundex o Double Metaphone, lo que permite mantener la comparabilidad aproximada.
- Token de rango: para fechas. «1974-03-12» se convierte en «DOB-BKT-1970s-Q1», lo que permite mantener la capacidad de coincidencia aproximada al tiempo que se oculta el valor exacto.
- Hash con sal: para campos que requieren una coincidencia exacta, como el número de la Seguridad Social. Un SHA-256 con sal aplicado a «7821» genera un hash fijo que permite comparar si son iguales sin revelar la secuencia de dígitos.
- Token de agrupación geográfica: para direcciones. La dirección postal se analiza para obtener una agrupación de bloques censales, lo que proporciona al sistema de coincidencia la resolución geográfica suficiente para confirmar que se trata del mismo hogar sin necesidad de transmitir la dirección postal.
Etapa 4: Coincidencia aproximada y resolución de entidades en tokens
Una vez establecidos los tokens, el motor de coincidencia ejecuta la lógica estándar de deduplicación y resolución de entidades: puntuación ponderada entre varios campos de tokens, filtrado para reducir el espacio de comparación y decisiones de coincidencia basadas en umbrales. El motor nunca ve los valores sin procesar. Funciona íntegramente a partir de la representación de los tokens.
Una puntuación ponderada típica para la compatibilidad de un paciente podría ser:
| Campo de token | Peso | Resultado del partido | Contribución |
|---|---|---|---|
| Token fonético del nombre | 0.35 | Coincidencia exacta del token | 0.35 |
| Token de cubeta DOB | 0.30 | La misma década + un trimestre | 0.27 |
| Hash del número de la Seguridad Social (4 últimos dígitos) | 0.25 | Coincidencia exacta de hash | 0.25 |
| Token de geoclúster | 0.10 | Mismo clúster de bloques | 0.09 |
| Puntuación global | 0.96 | ||
Una puntuación compuesta de 0,96 supera el umbral de fusión automática de 0,90. Los registros se vinculan sin que ningún analista llegue a ver un nombre, una fecha de nacimiento ni los cuatro últimos dígitos del número de la Seguridad Social.
Etapa 5: Registro de auditoría y trazabilidad
Cada decisión de la partida —entradas de tokens, ponderaciones, puntuación compuesta y resultado— se registra en un registro de auditoría inmutable. Este registro cumple los requisitos normativos (registro de auditoría de la HIPAA, registro de SOC 2 Tipo II, registros de tratamiento del RGPD) sin contener ningún dato personal en bruto. Los auditores pueden ver el historial completo de decisiones, pero no los valores subyacentes.
Controles de acceso y separación de funciones
Las tuberías seguras fallan cuando los controles de acceso son demasiado amplios. La arquitectura exige una separación estricta de funciones entre tres grupos:
- Responsables de los datos. Pueden acceder a los datos sin procesar y ejecutar la capa de tokenización. No pueden consultar directamente los resultados de la coincidencia ni el mapa de tokens.
- Ingenieros de calidad de datos. Pueden configurar y ejecutar el proceso de cotejo sobre datos tokenizados. No pueden acceder a los registros sin procesar ni al mapa de tokens.
- Auditores de cumplimiento. Pueden consultar el registro de auditoría. No pueden acceder a los datos sin procesar, al mapa de tokens ni a la configuración de correspondencias.
En Match Data Pro, el acceso basado en roles se aplica a nivel de tarea. Una tarea configurada para ejecutarse sobre un conjunto de datos tokenizado no puede modificarse para extraer datos de la fuente sin procesar sin una nueva autorización. La automatización de las tareas garantiza la repetibilidad del proceso y evita las consultas ad hoc sobre datos confidenciales en tiempo real.
Ámbito de aplicación: tres casos de uso de gran importancia
Sanidad: Conciliación de historiales clínicos
Los hospitales, los laboratorios y las aseguradoras almacenan los historiales de los pacientes en sistemas inconexos. Para poder cotejarlos y crear un historial médico longitudinal, se necesitan el nombre, la fecha de nacimiento, la dirección y el número de identificación del seguro, datos que, según la HIPAA, se consideran información médica protegida (PHI). El proceso de tokenización descrito anteriormente permite a un sistema sanitario llevar a cabo una deduplicación completa de los pacientes y una resolución de entidades en más de 10 millones de registros sin exponer la información médica protegida (PHI) al motor de cotejo ni a sus operadores.
Servicios financieros: verificación de identidad del cliente (KYC) y control contra el blanqueo de capitales (AML)
Los procesos de «Conoce a tu cliente» (KYC) y de lucha contra el blanqueo de capitales (AML) requieren cotejar los registros de los clientes con listas de vigilancia e historiales de transacciones internos. Los datos brutos incluyen números de pasaporte, números de identificación nacional e importes de transacciones, todos ellos sujetos a estrictos requisitos de tratamiento de datos. El cotejo basado en tokens permite a los equipos de cumplimiento normativo analizar los registros en busca de solapamientos entre entidades sin centralizar los datos de identidad brutos en la capa de cotejo.
Gobierno: Cotejo de registros entre organismos
Los organismos públicos suelen necesitar vincular registros de distintos departamentos (prestaciones sociales, impuestos, licencias) sin compartir los datos brutos de los ciudadanos entre ellos. La vinculación de registros con protección de la privacidad mediante tokens permite a dos organismos identificar poblaciones que se solapan con el fin de detectar fraudes o determinar la elegibilidad para un programa, sin que ninguno de ellos exponga su conjunto de datos completo al otro.
Qué ofrece Match Data Pro para garantizar la seguridad de los flujos de trabajo con datos confidenciales
Match Data Pro es una plataforma completa de calidad de datos diseñada precisamente para este tipo de flujo de trabajo. Funcionalidades clave para entornos con datos sensibles:
- Búsqueda aproximada basada en inteligencia artificial que opera con valores de campos estandarizados y enmascarados, con ponderaciones de algoritmo configurables por tipo de campo.
- El análisis de perfiles de datos que se ejecuta dentro de tu entorno y solo genera metadatos; ningún valor sin procesar sale de la fase de análisis de perfiles.
- Deduplicación y resolución de entidades (con tecnología de Senzing) que gestiona la coincidencia probabilística entre millones de registros a velocidades de procesamiento adecuadas tanto para el procesamiento por lotes nocturno como para el uso de API en tiempo real.
- Automatización de tareas con controles de acceso a nivel de rol: los procesos programados se ejecutan sobre conjuntos de datos previamente aprobados, sin acceso ad hoc a datos sin procesar.
- Registro completo de auditoría de cada decisión de coincidencia, exportable en formatos adecuados para las revisiones de cumplimiento de la HIPAA, SOC 2 y el RGPD.
- SaaS en la nube sin contrato a largo plazo, además de opciones de implementación local para equipos que no puedan utilizar la infraestructura en la nube para el tratamiento de datos confidenciales.
Empieza una prueba gratuita para explorar la plataforma con tus propios datos, o solicita una demostración para conocer un proceso seguro configurado para tu sector.
Preguntas frecuentes
¿Puede la coincidencia aproximada basada en la inteligencia artificial funcionar con datos tokenizados sin perder precisión?
Sí, cuando la tokenización se diseña para preservar la estructura de comparabilidad del campo original. Los tokens fonéticos preservan la similitud de los nombres; los tokens de intervalos preservan la proximidad aproximada de las fechas; y los tokens de agrupaciones geográficas preservan la proximidad geográfica. La precisión de las coincidencias con tokens bien diseñados suele situarse entre un 2 % y un 3 % de la precisión obtenida con los valores sin procesar.
¿Qué normativa exige este tipo de enfoque que preserva la privacidad en la comparación de datos?
La HIPAA (expedientes de pacientes en el ámbito sanitario), el RGPD (datos personales en la UE, especialmente las transferencias transfronterizas), la CCPA (datos de los consumidores de California) y las normativas financieras, como la PCI DSS y la MiFID II, establecen restricciones sobre cómo se pueden tratar y transmitir los datos personales y sensibles. La vinculación de registros con preservación de la privacidad cumple los principios de minimización de datos y limitación de la finalidad, comunes a todos estos marcos normativos.
¿En qué se diferencia la tokenización del cifrado a efectos de la comparación de datos?
El cifrado genera un texto cifrado que puede descifrarse mediante la clave correspondiente, lo que significa que, en teoría, el motor de comparación podría descifrar y leer el valor original. La tokenización sustituye un valor por una representación no reversible. A efectos de la comparación, los tokens están diseñados para preservar la comparabilidad estructural, más que la capacidad de recuperar el valor original. Ninguno de los dos enfoques es suficiente por sí solo; la combinación de la tokenización con el acceso controlado al mapa de tokens ofrece la protección más sólida.
¿Este proceso funciona tanto para la comparación en tiempo real como para los trabajos por lotes?
Sí. La capa de tokenización se puede aplicar en línea en el momento de la ingesta de registros: cuando entra un nuevo registro, se tokeniza inmediatamente y el token se envía a la API de coincidencia. La API de búsqueda aproximada en tiempo real de Match Data Pro admite este patrón, devolviendo candidatos de coincidencia en milisegundos a partir de un almacén de tokens preindexado, sin que ningún dato de identificación personal (PII) sin procesar cruce el límite de coincidencia.
¿Qué ocurre cuando los analistas tienen que revisar los casos dudosos?
Los registros que se sitúan entre los umbrales de fusión automática y de rechazo automático se marcan para su revisión manual. Los analistas ven la representación simbólica y el desglose de la puntuación de coincidencia, no los valores brutos. Si una decisión final requiere consultar el registro original, dicho acceso se controla por separado, se registra y está sujeto a una autorización basada en roles. El proceso de coincidencia y la ruta de acceso a los datos brutos son independientes.