
La correspondencia entre el sistema de origen y el de destino define exactamente cómo se transforma cada campo del sistema de origen en un campo del sistema de destino. Si se hace mal, el proceso generará datos dañados, desalineados o incompletos a gran escala. Si se hace bien, se transferirán datos limpios, con el tipo de datos correcto, sin duplicados y listos para su análisis desde el primer día.
Cada migración, integración y carga en el almacén de datos comienza con un documento de mapeo. Pero el mapeo por sí solo no basta. Si no se analiza primero el origen y no se limpian los datos antes de su traslado, incluso una especificación de mapeo perfecta dará lugar a un destino defectuoso. Este artículo aborda las mejores prácticas que permiten mantener sincronizadas tanto la capa de mapeo como la de calidad de los datos.
Reserva una demostración para descubrir cómo Match Data Pro automatiza la capa de calidad de datos que sustenta tus especificaciones de mapeo.
Qué abarca realmente la correspondencia entre el idioma de origen y el de destino
Un documento de mapeo de origen a destino es una especificación estructurada que recoge cuatro elementos para cada campo: el nombre y el tipo del campo de origen, el nombre y el tipo del campo de destino, la lógica de transformación y cualquier regla de negocio o restricción que rija el mapeo. Se trata del contrato entre el equipo de ingeniería de datos y el sistema que va a utilizar los datos resultantes.
Una fila de asignación mínima tiene este aspecto:
| Campo de origen | Tipo de fuente | Campo de destino | Tipo de objetivo | Transformación |
|---|---|---|---|---|
| NOMBRE_CLIENTE | VARCHAR(50) | nombre | TEXTO | TRIM, MAYÚSCULAS ADECUADAS |
| ACCT_ZIP | CHAR(5) | código_postal | VARCHAR(10) | Añadir el código ZIP+4 mediante la búsqueda en CASS |
| ORD_DT | INT (AAAAMMDD) | fecha_pedido | FECHA | Formato según la norma ISO 8601 (AAAA-MM-DD) |
| ID_CLIENTE | CHAR(12) | id_cliente | UUID | Hash a UUID v4 |
Los errores de asignación más habituales son las discrepancias de tipo (cargar una fecha de tipo VARCHAR en una columna de tipo DATE), los errores de truncamiento (un nombre de 100 caracteres en un campo de destino de tipo VARCHAR(80)) y los valores nulos silenciosos (un campo de origen que está vacío en un 40 %, pero que se asigna a una columna de destino NOT NULL).
Analiza la fuente antes de escribir ni una sola asignación
Prescindir del perfilado de fuentes es la principal causa de que haya que volver a trabajar en la asignación. El perfilado de datos mediante IA revela los datos a nivel de campo que necesita tu especificación de asignación: longitud máxima real, tasa de valores nulos, cardinalidad, distribución de valores y patrones de formato. Sin esos datos, cada fila de la asignación es una suposición.
Lo que revela el análisis de perfiles antes de la cartografía
Realiza un análisis de perfil del material de origen sin procesar antes del taller de cartografía. Aspectos que suelen observarse y que influyen en las decisiones de cartografía:
- Valores nulos inesperados. El campo «customer_email» presenta un 38 % de valores nulos. El esquema de destino lo marca como NOT NULL. La asignación falla durante la carga si no hay un valor por defecto o una regla de exclusión.
- Heterogeneidad de formatos. Un campo de teléfono contiene (555) 123-4567, 555.123.4567 y +15551234567 en la misma columna. Es necesario estandarizar los datos antes de asignarlos a un destino E.164.
- Duplicados ocultos. Una tabla de proveedores con 12 000 filas contiene 2 100 duplicados entre los campos VEND_NAME y VEND_ADDR. La carga sin deduplicación aumenta el volumen de datos de destino en un 17 %.
- Desviación de tipo. Un campo numérico de ingresos almacena valores como «$1.200,00» como VARCHAR. Una conversión directa a DECIMAL falla en el 8 % de las filas.
La creación de perfiles de datos debería generar un informe de calidad a nivel de campo que se incorpore directamente a la columna de transformación de tu documento de mapeo.
Las siete prácticas recomendadas para una correspondencia precisa entre el texto de origen y el de destino
1. Mapea los metadatos, no solo los campos
Cada fila de la tabla de correspondencias debe incluir el responsable del negocio, la fecha de la última actualización y si la correspondencia es definitiva o provisional. Los documentos de correspondencias se desajustan cuando los cambios se realizan verbalmente y nunca se registran. Trata el documento de especificaciones como un elemento con versiones en el control de versiones.
2. Estandariza antes de crear el mapa
La estandarización de datos normaliza los formatos, las unidades y los conjuntos de valores en la fuente antes de que se ejecute la asignación. Asignar un valor no estándar a un destino que espera un código estándar (por ejemplo, «Estados Unidos» a «EE. UU.») sin una tabla de consulta provoca errores de carga. Define la lógica de transformación en el documento de asignación y, a continuación, aplícala en el proceso de carga.
3. Eliminar duplicados en el origen, no en el destino
Cargar los duplicados en un destino y deduplicarlos posteriormente supone un esfuerzo de ingeniería entre dos y tres veces mayor. La deduplicación de datos mediante la coincidencia aproximada detecta los casi duplicados que la lógica de coincidencia exacta pasa por alto. Un proveedor denominado «Acme Corp.» y «ACME Corporation» son la misma entidad. Una puntuación aproximada de Jaro-Winkler de 0,91 en el nombre, junto con la coincidencia del código postal, confirma la relación antes de que se traslade el registro.
4. Aplicar la resolución de entidades en todos los sistemas de origen
Cuando la migración se realiza a partir de varias fuentes (CRM, ERP, exportaciones de archivos planos), la misma entidad aparece en cada una de ellas con claves diferentes. La resolución de entidades vincula esos registros antes de la carga en el destino, de modo que este contenga un único registro canónico por entidad, en lugar de tres copias conflictivas. La resolución de entidades de Senzing, disponible en Match Data Pro, gestiona este proceso sin necesidad de reglas definidas manualmente.
5. Verificar las direcciones antes de asignar los campos postales
Los campos postales son los que con mayor frecuencia se asignan incorrectamente en las migraciones de CRM y ERP. Un campo de dirección de origen que mezcla calle, ciudad, estado y código postal en una sola cadena no puede asignarse correctamente a un esquema de destino analizado sin antes realizar un análisis sintáctico y una verificación CASS. La limpieza de datos de direcciones analiza la cadena, la valida con la base de datos del USPS y devuelve una dirección estructurada y entregable con el ZIP+4 añadido. Asigna ese resultado estructurado, no la cadena sin procesar.
6. Incorporar una capa de validación en la especificación de mapeo
Cada mapeo debe incluir una prueba de aceptación: el número de filas esperado, la tasa de valores nulos aceptable para cada campo y la distribución de valores permitida para los campos codificados. Ejecuta estas pruebas tras cada ciclo de carga. Si una tabla de clientes de destino tiene un 5 % más de filas que la tabla de origen, esto indica que en la etapa de deduplicación se han pasado por alto algunos registros o que se están duplicando filas huérfanas procedentes de una unión.
7. Automatizar las ejecuciones iterativas mediante la programación de tareas
Una especificación de migración puntual se convierte en una especificación de integración recurrente en el momento en que la empresa solicita cargas delta. La automatización de tareas en una plataforma de calidad de datos te permite programar todo el proceso (perfilado, limpieza, deduplicación, resolución de entidades, carga y validación) con una periodicidad definida. Los cambios en las correspondencias se propagan a través de la configuración del proceso, no mediante scripts SQL individuales.
Donde la calidad de los datos se cruza con la cartografía
La asignación de origen a destino no es solo un ejercicio de esquema. Cada celda de transformación de la especificación de asignación implica una operación de calidad de datos. Cambiar el nombre de un campo es algo trivial. Sin embargo, convertirlo, estandarizarlo, eliminar duplicados y verificarlo no lo es.
El siguiente diagrama muestra el proceso completo que subyace a una especificación de mapeo cuando se integra la calidad de los datos:
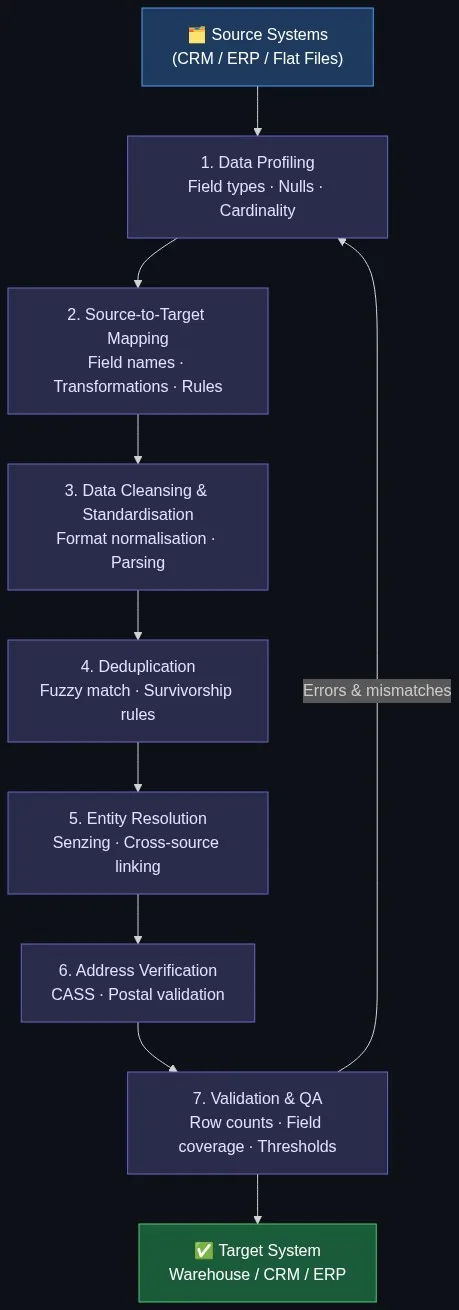
Match Data Pro implementa cada etapa de este proceso como una tarea configurable. Se importa la fuente a través de un conector (CSV, base de datos, Salesforce, Excel), se ejecuta el perfilado mediante IA, se aplican reglas de limpieza, se lleva a cabo la deduplicación difusa, se resuelven las entidades con Senzing, se verifican las direcciones con CASS y se exporta el resultado limpio al destino. El documento de mapeo determina la configuración de la transformación; el proceso garantiza la calidad de los datos.
Los equipos que integran la calidad de los datos en la asignación de campos registran entre un 35 % y un 55 % menos de errores de carga en las migraciones de primera pasada, según los resultados comunicados en proyectos de migración de datos empresariales. Esta reducción se debe a que se detectan los errores de formato, las infracciones de valores nulos y el exceso de duplicados antes de que el sistema de destino reciba siquiera un registro.
Errores habituales en la creación de mapas y cómo solucionarlos
Asignación antes de la creación de perfiles
Redactar especificaciones de mapeo a partir de la documentación del esquema, en lugar de a partir de los datos de origen observados, da lugar a especificaciones que fallan en cuanto a índices de valores nulos, desviaciones de tipo e incumplimientos de longitud. Realiza siempre primero un perfilado. El resultado del perfilado se convierte en la lógica de transformación. Solución: ejecuta un perfilado automatizado de los datos en cada tabla de origen antes del taller de mapeo.
No tener en cuenta el linaje de los datos
Cuando un campo de destino se deriva de tres campos de origen (nombre, segundo nombre y apellido para formar el nombre completo), el linaje debe documentarse en la especificación de mapeo. Los equipos que omiten la documentación del linaje no pueden rastrear los problemas de calidad de los datos hasta su origen. Solución: añadir una columna «derivación de origen» a cada fila de mapeo.
Omitir la deduplicación entre sistemas
Las migraciones con múltiples fuentes suelen cargar el mismo cliente del CRM y del ERP como dos registros distintos en el sistema de destino. A raíz de ello, el sistema de destino envía comunicaciones duplicadas o calcula métricas de ingresos incorrectas. Solución: aplicar una coincidencia aproximada a todas las claves de origen antes de la carga en el sistema de destino.
Considerar el mapa como un documento único
Los requisitos empresariales cambian. Aparecen nuevos campos. Se actualizan los sistemas de origen. Una especificación de mapeo que no está sujeta a control de versiones pierde su precisión en cuestión de semanas. Solución: almacena la especificación de mapeo en Git, vinculada a la configuración del pipeline. Los cambios en la especificación activan una actualización del pipeline, en lugar de una reescritura manual del script.
Cómo Match Data Pro facilita los flujos de trabajo de asignación de origen a destino
Match Data Pro es una plataforma SaaS en la nube que automatiza la capa de calidad de datos entre la fuente y el destino. No sustituye a tu documento de mapeo. Se encarga de aplicar las reglas de transformación y calidad que define tu documento de mapeo.
Capacidades clave relevantes para la cartografía de tuberías:
- Perfilado de datos mediante IA: analiza las tablas de origen y proporciona métricas de calidad a nivel de campo antes de que comience la asignación.
- Limpieza y estandarización de datos: aplica la normalización de formatos, el análisis sintáctico y la aplicación de conjuntos de valores tal y como se definen en la columna de transformación de mapeo.
- Deduplicación difusa: detecta registros casi duplicados en las tablas de origen antes de la carga en el destino, utilizando algoritmos configurables de Levenshtein, Jaro-Winkler y fonéticos.
- Resolución de entidades (Senzing): vincula registros de varios sistemas de origen en una única entidad canónica antes de asignarlos a la clave de destino.
- Verificación de direcciones CASS: analiza, valida y normaliza los campos postales para que se ajusten perfectamente a los esquemas estructurados de destino.
- Automatización de tareas: programa todo el proceso de forma diaria, semanal o en función de eventos, sin necesidad de intervención manual.
- Conectores de importación/exportación: Se conectan a archivos CSV, Excel, bases de datos SQL, Salesforce y otros sistemas de origen y destino habituales.
Sin contrato a largo plazo. Empieza una prueba gratuita y ejecuta un proceso de mapeo de origen a destino con tus propios datos en menos de una hora.
Preguntas frecuentes
¿Qué es la asignación de origen a destino en la ingeniería de datos?
La correspondencia entre el sistema de origen y el de destino es un documento de especificaciones que define cómo se asigna cada campo del sistema de origen a un campo del sistema de destino, incluyendo los nombres de los campos, los tipos de datos, la lógica de transformación y las reglas de negocio. Actúa como contrato entre el equipo de ingeniería de datos y el sistema posterior, garantizando que los datos se transfieran de forma correcta y coherente.
¿Por qué debe realizarse la creación de perfiles de datos antes de la asignación de origen a destino?
El análisis del perfil de la fuente revela en primer lugar las tasas de valores nulos reales, la deriva de tipos, la heterogeneidad de formatos y la cardinalidad, aspectos que la documentación del esquema no muestra. Estos hallazgos afectan directamente a la lógica de transformación. Sin este análisis, las especificaciones de mapeo se basan en suposiciones que fallan en el momento de la carga, lo que provoca un trabajo adicional que cuesta entre 2 y 4 veces más esfuerzo que realizar correctamente el análisis del perfil desde el principio.
¿Cómo encaja la deduplicación en la asignación de origen a destino?
La deduplicación debe realizarse sobre los datos de origen antes de la carga en el sistema de destino, no después. La coincidencia aproximada identifica registros casi duplicados (diferencias ortográficas, apodos, dígitos invertidos) que la lógica de coincidencia exacta no detecta. La eliminación de duplicados en el origen evita que se inflen los recuentos de filas, que se produzcan registros contradictorios y que se generen errores en los informes posteriores del sistema de destino.
¿Qué es la resolución de entidades y por qué es importante para la cartografía?
La resolución de entidades vincula los registros que representan a la misma entidad del mundo real en distintos sistemas de origen, incluso cuando tienen identificadores, valores de campo o formatos diferentes. En el contexto de la asignación, garantiza que solo se introduzca en el sistema de destino un registro canónico por cada entidad, en lugar de tres copias contradictorias procedentes del CRM, el ERP y una exportación de archivo plano.
¿De qué manera mejora la verificación de direcciones la precisión de la correspondencia entre la fuente y el destino?
Los campos de dirección se encuentran entre los que presentan una estructura más inconsistente en los sistemas de origen. La verificación de direcciones certificada por CASS analiza cadenas de direcciones no estructuradas, las valida con la base de datos postal del USPS y devuelve una dirección limpia, estructurada y entregable, con el código ZIP+4 añadido. Este resultado estructurado se ajusta perfectamente a un esquema de destino analizado, lo que elimina los errores de tipo y los fallos de carga provocados por cadenas de direcciones sin procesar.