
La estandarización de datos es el proceso de transformar los valores brutos de los campos en un formato, una estructura y un vocabulario coherentes antes de que se lleve a cabo cualquier proceso de cotejo o análisis. Si se realiza correctamente, reduce las tasas de error en los cotejos posteriores entre un 40 % y un 60 % y elimina los conflictos de datos ocultos que distorsionan los análisis, los procesos de CRM y los informes de ERP. Las siete prácticas recomendadas que se exponen a continuación abarcan todas las capas de la estandarización —desde la normalización de mayúsculas y minúsculas y el formateo de números de teléfono hasta la verificación postal y la aplicación de esquemas— y muestran cómo automatizarlas a gran escala.
¿Estás listo para estandarizar tus datos sin tener que escribir scripts manualmente? Empieza una prueba gratuita de Match Data Pro y ejecuta tu primera tarea de estandarización en cuestión de minutos.
Por qué es importante la estandarización de los datos antes de realizar comparaciones o análisis
Veamos un ejemplo sencillo. Un sistema almacena los datos de una empresa como IBM Corp. Otro lo almacena como International Business Machines. Un tercero lo almacena como I.B.M.. Las tres representan la misma entidad. Sin estandarización, todas las coincidencias posteriores fallan porque las cadenas no son comparables. El mismo problema se da con las fechas (01/06/2024 vs 2024-06-01), números de teléfono ((602) 555-0100 vs 6025550100), y direcciones (123 N Main St Ste 4 vs 123 North Main Street Suite 4).
Las consecuencias van más allá de los datos no coincidentes. Los datos no estandarizados dan lugar a recuentos duplicados inflados, a una atribución incorrecta de los ingresos y a una cadena de origen de los datos defectuosa en las herramientas de gobernanza. Un estudio del sector realizado en 2023 reveló que las organizaciones que carecen de un proceso formal de estandarización dedican, de media, un 35 % más de tiempo a la corrección manual de datos cada trimestre que aquellas que cuentan con un proceso automatizado.
La estandarización no es lo mismo que la limpieza. La limpieza elimina los valores erróneos. La estandarización transforma los valores correctos, pero incoherentes, en un formato común. Ambas son necesarias, pero se trata de operaciones diferentes. El proceso comienza con la elaboración de perfiles de datos: se revisa cada campo para detectar las variaciones en los patrones que hay que resolver antes de escribir una sola regla.
Buena práctica n.º 1: primero el perfil, luego la estandarización
La estandarización ciega genera nuevos problemas. Si aplicas una regla de mayúsculas iniciales a un campo de nombre sin tener en cuenta el contexto, conviertes McBride a Mcbride y O'BRIEN a O'brien. El análisis de perfiles revela los patrones reales de tus datos antes de que establezcas las reglas.
Una pasada de perfilado debería medir:
- Tasa nula por campo
- Recuento de valores distintos y distribución de frecuencias «top-N»
- Cobertura del patrón (qué porcentaje de valores coinciden con la expresión regular esperada)
- Puntuaciones de exhaustividad y coherencia a nivel de campo
El proceso de limpieza de datos de Match Data Pro, basado en inteligencia artificial, comienza con una fase de perfilado automatizado que extrae estas métricas de entre millones de filas en cuestión de minutos, generando un informe de calidad campo por campo antes de que se ejecute cualquier transformación.
Buena práctica n.º 2: estandarizar por tipo de campo, no por conjunto de datos
Cada tipo de campo tiene su propia lógica de estandarización. Si se aplica una regla genérica de recorte de cadenas a todo el esquema, se pasa por alto la mayor parte de las variaciones. La tabla siguiente muestra la transformación correcta para cada tipo de campo habitual.
| Tipo de campo | Variación habitual | Formulario estándar |
|---|---|---|
| Nombre de la persona | JON SMITH / Jon Smith / Jonathan Smith | Mayúsculas en los títulos, expansión de los apodos |
| Nombre de empresa | IBM Corp / I.B.M. / International Business Machines | Mayúsculas, búsqueda de abreviaturas |
| Número de teléfono | (602) 555-0100 / 6025550100 / +1-602-555-0100 | Formato E.164: +16025550100 |
| Fecha | 01/06/2024 / 2024-06-01 / 1 de junio de 2024 | ISO 8601: 1 de junio de 2024 |
| DIRECCIÓN | 123 N Main St, local 4 / 123 North Main Street, local 4 | Formulario postal verificado por CASS de USPS |
| Código de país | EE. UU. / Estados Unidos / EE. UU. / América | ISO 3166-1 alfa-2: EE. UU. |
| Moneda | 1.200 $ / 1.200 USD / 1.200,00 USD | ISO 4217 + decimal: 1200,00 USD |
En el caso de los campos de texto libre, como el cargo o la descripción de un producto, el proceso de estandarización es más complejo. Requiere la tokenización, la eliminación de palabras vacías y la consulta de listas de referencia. Consulta la guía completa sobre la limpieza de datos de texto para obtener más detalles sobre la aplicación de estas técnicas.
Buena práctica n.º 3: estandarizar las direcciones con una autoridad postal
Los campos de dirección son el tipo de campo con mayor entropía en la mayoría de las bases de datos operativas. Solo las abreviaturas suman más de 200 variantes oficiales del USPS: St, Street, Str; Ave, Avenue, Av; Blvd, Boulevard. Añadir variantes del sufijo de la unidad (Apt, Apartment, Unit, #), variación del prefijo direccional (N, North, No.), así como la ausencia del código ZIP+4, y una misma dirección física puede aparecer en miles de formas diferentes.
La normalización basada en reglas no puede abarcar este ámbito. El enfoque correcto es la verificación postal certificada por CASS, que valida cada dirección cotejándola con la base de datos del Sistema de Apoyo a la Precisión en la Codificación (CASS) del USPS, devuelve un formato estandarizado de la línea de entrega y añade el código ZIP+4. No se trata de una transformación meramente estética, sino que modifica la capacidad física de entrega del correo y la precisión del análisis geográfico.
Match Data Pro incluye la verificación de direcciones CASS integrada como parte del proceso de estandarización. Funciona en paralelo con el motor de correspondencia, de modo que las direcciones se verifican y normalizan antes de calcular las puntuaciones de deduplicación.
Antes y después: estandarización de direcciones
| Datos sin procesar | Producción estandarizada |
|---|---|
| 123 Main St., local 4, Phoenix, AZ 85001 | 123 N Main St, local 4, Phoenix, AZ 85001-1234 |
| Calle Main Norte, 123, oficina 4, Phoenix, Arizona | 123 N Main St, local 4, Phoenix, AZ 85001-1234 |
| 123 N. Main Street, apartamento n.º 4, Phoenix, AZ | 123 N Main St, local 4, Phoenix, AZ 85001-1234 |
Las tres filas se convierten en el mismo formato estandarizado, lo que significa que el motor de deduplicación ya puede emparejarlas correctamente.
Buena práctica n.º 4: crea una biblioteca de referencia, no solo un conjunto de normas
Las reglas se encargan de las variaciones previsibles. Las bibliotecas de referencia se encargan de los casos menos frecuentes. Una regla puede convertir todos los números de teléfono al formato E.164. Solo una biblioteca de referencia puede resolver IBM, Big Blue, International Business Machines Corporationy I.B.M. Inc. al mismo nombre canónico de la empresa.
Bibliotecas de referencia que hay que crear y mantener:
- Tabla de nombres alternativos de empresas: nombre legal, nombre comercial, abreviatura, nombre anterior, código bursátil
- Tabla de sinónimos de nombres: Bill = William, Bob = Robert, Liz = Elizabeth
- Correspondencias entre códigos sectoriales: de SIC a NAICS, y de códigos internos a códigos estándar
- Tabla de alias de productos: variantes de SKU, diferencias de denominación según la región, códigos de productos antiguos
- Referencia geográfica: abreviaturas de estados, correspondencias de códigos de país, búsquedas de códigos postales por ciudad
Estas bibliotecas alimentan directamente los algoritmos de coincidencia difusa que evalúan la similitud de los registros. Un registro normalizado con respecto a una biblioteca de referencia obtendrá entre 30 y 50 puntos más en una coincidencia difusa que el mismo registro en su formato sin procesar, lo que reduce significativamente los falsos negativos.
Buena práctica n.º 5: garantizar la coherencia de los esquemas en todos los sistemas de origen
En los entornos multisistema se produce una deriva de esquemas. Un sistema CRM almacena las fechas como MM/DD/YYYY. El ERP utiliza YYYY-MM-DD. La plataforma de marketing exporta las fechas como marcas de tiempo Unix. Ninguna de ellas coincide hasta que se aplica un esquema común en el momento de la ingesta.
La aplicación del esquema abarca cuatro niveles:
- Conversión de tipos: asegúrate de que cada campo se reciba con el tipo de datos declarado (cadena, entero, decimal, fecha)
- Normalización de formatos: transformar los formatos específicos de cada fuente a una forma canónica antes de la carga
- Cartografía de campo: asignar los nombres de las columnas de origen a un diccionario de datos compartido (p. ej.,
cust_nmyClientNameambos se corresponden concustomer_name) - Tratamiento de los valores nulos: define si un valor nulo significa «desconocido», «no aplicable» o «ausente», y aplica esa convención de forma coherente
Los conectores de importación y exportación de Match Data Pro asignan los campos de origen a un esquema común en el momento de la ingesta, de modo que los datos de todos los sistemas entran en el proceso con la misma estructura. Esto elimina la necesidad de reasignar manualmente las columnas, lo que supone una gran inversión de horas de trabajo de los ingenieros en scripts ETL puntuales.
Buena práctica n.º 6: vincular la estandarización con la deduplicación y la resolución de entidades
La estandarización sin deduplicación deja los registros duplicados tal y como están. La deduplicación sin estandarización compara los registros con cadenas que no son comparables y pasa por alto coincidencias reales. Ambas operaciones deben ejecutarse de forma secuencial, y el paso de estandarización debe completarse antes de que se aplique cualquier umbral de coincidencia.
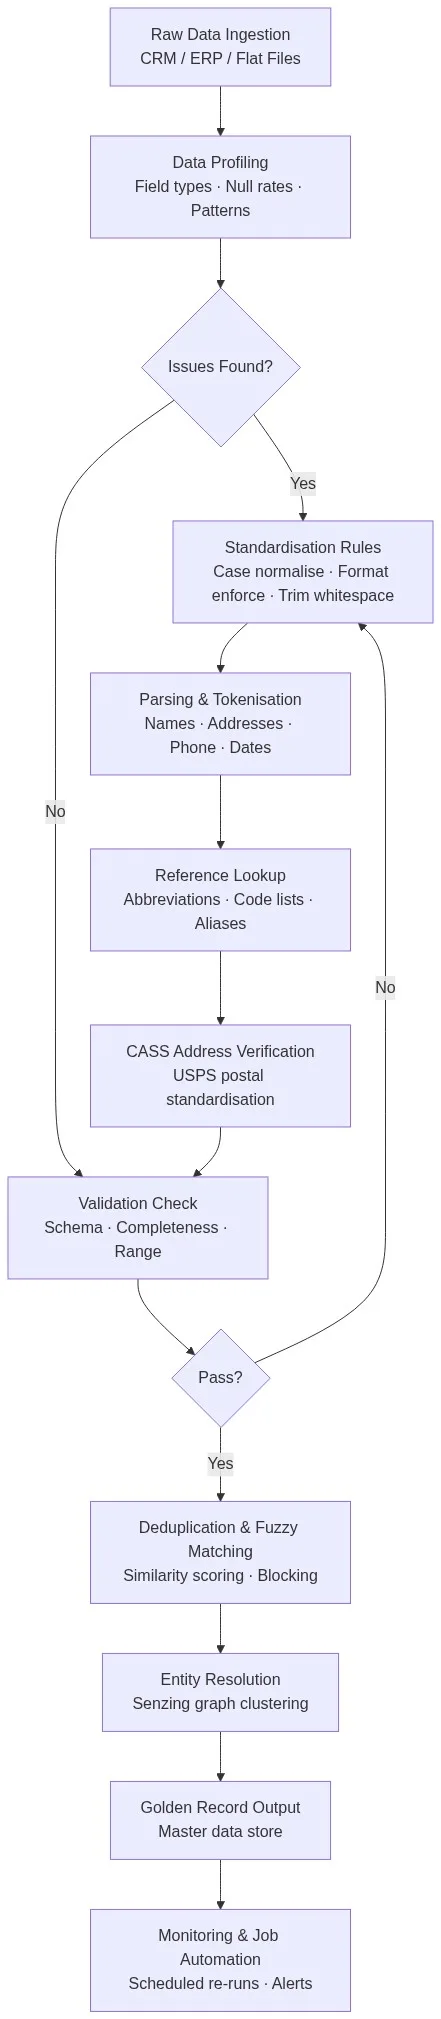
El orden correcto de las etapas es:
- Analizar cada conjunto de datos de origen
- Aplicar reglas de estandarización de tipos de campo y consultas a tablas de referencia
- Ejecutar la verificación de direcciones de CASS
- Aplicar el bloqueo para reducir el espacio de comparación
- Comparación de registros de puntuaciones con un software de deduplicación mediante algoritmos difusos ponderados
- Aplicar la resolución de entidades para agrupar registros relacionados de distintas fuentes
- Generar registros dorados utilizando reglas de supervivencia
El siguiente diagrama muestra cómo discurre este proceso, desde la ingesta de datos sin procesar hasta el registro de referencia definitivo.
Buena práctica n.º 7: automatizar y supervisar, no ejecutar una sola vez
La estandarización de los datos se va deteriorando. Cada hora llegan nuevos registros procedentes de sistemas fuente que no siguen tus convenciones. Un proyecto puntual de estandarización genera datos limpios que quedan obsoletos en 30 días. La única solución duradera es la estandarización continua y automatizada.
Requisitos de automatización para un proceso de estandarización de la producción:
- Tareas programadas: ejecutar la estandarización cada noche o en cada ciclo de importación, no de forma manual
- Procesamiento incremental: procesa únicamente los registros nuevos o modificados, y no el conjunto de datos completo, para controlar el tiempo de ejecución a gran escala.
- Control de calidad: realiza un seguimiento de los índices de superación y las puntuaciones de coincidencia de patrones para cada campo en cada ejecución; avisa cuando los índices caigan por debajo del umbral.
- Control de versiones de las reglas: registrar cada cambio en las reglas con una marca de tiempo y ejemplos «antes» y «después», de modo que se puedan diagnosticar las regresiones.
El motor de automatización de tareas de Match Data Pro programa las ejecuciones de estandarización, deduplicación y verificación de direcciones con una periodicidad configurable. Registra los resultados de cada ejecución y muestra métricas de tendencias de calidad para que puedas comprobar si los datos mejoran o empeoran con el tiempo.
¿Quieres ver cómo funciona el proceso con tus propios datos? Reserva una demostración personalizada con el equipo de Match Data Pro. O empieza una prueba gratuita: sin contrato ni compromiso.
Preguntas frecuentes
¿Qué es la estandarización de datos y por qué es importante?
La estandarización de datos transforma los valores de los campos en un formato, una estructura y un vocabulario coherentes, de modo que los registros de diferentes sistemas puedan compararse, emparejarse y fusionarse con precisión. Sin ella, un mismo cliente, empresa o dirección puede aparecer en docenas de formatos de cadena incompatibles, lo que provoca que los emparejamientos fallen, que persistan los duplicados y que los análisis muestren totales incorrectos.
¿Cuál es la diferencia entre la estandarización de datos y la limpieza de datos?
La limpieza elimina o corrige los valores erróneos —valores nulos, números fuera de rango, fechas imposibles—. La estandarización transforma los valores correctos pero incoherentes en un formato común, convirtiendo 01/06/2024 y June 1, 2024 a 2024-06-01, por ejemplo. Ambos son necesarios, pero resuelven problemas distintos y se ejecutan como etapas independientes del proceso.
¿Cuánto tiempo se tarda en estandarizar un conjunto de datos de gran tamaño?
Con una plataforma automatizada, una primera ejecución de estandarización que abarca entre 1 y 5 millones de registros suele completarse en menos de dos horas. La fase que más tiempo requiere es la de elaboración de perfiles y diseño de reglas, que suele durar entre dos y cinco días para una nueva fuente de datos. Las ejecuciones incrementales posteriores procesan únicamente los registros modificados y duran unos minutos. La estandarización manual del mismo volumen lleva semanas y produce resultados inconsistentes.
¿Debo normalizar los datos antes o después de la deduplicación?
Estandariza siempre los datos antes de la deduplicación. Los algoritmos de coincidencia aproximada evalúan la similitud entre cadenas de caracteres, por lo que las entradas no estandarizadas —como diferentes formatos de fecha, formatos de número de teléfono o abreviaturas de direcciones— generan puntuaciones de similitud artificialmente bajas y hacen que se pasen por alto duplicados reales. La estandarización iguala las condiciones para que el motor de coincidencia compare elementos similares entre sí.
¿Se puede automatizar por completo la estandarización de datos?
Sí, en la mayoría de los registros. La estandarización basada en reglas, combinada con búsquedas en bibliotecas de referencia y la verificación de direcciones mediante CASS, gestiona de forma automática entre el 90 % y el 95 % de los registros. El 5 %-10 % restante suele corresponder a valores ambiguos que requieren una revisión humana o correcciones sugeridas por la inteligencia artificial. Plataformas como Match Data Pro desvían esos casos excepcionales a una cola de revisión, mientras que procesan el resto de forma automática.