
La coincidencia difusa permite encontrar registros que hacen referencia a la misma entidad del mundo real, incluso cuando los valores están escritos de forma diferente, invertidos, abreviados o presentan cualquier otro tipo de inconsistencia. A diferencia de la coincidencia exacta, que requiere que los caracteres coincidan uno a uno, la coincidencia difusa utiliza algoritmos de similitud para evaluar el grado de similitud entre dos cadenas y, a continuación, aplica un umbral configurable para decidir si dos registros coinciden. Para cualquier organización que gestione datos de CRM, ERP o de marketing a gran escala, la coincidencia aproximada no es opcional: es el motor que hace posible la deduplicación, la resolución de entidades y la consolidación de datos.
¿Estás listo para ver cómo funciona la coincidencia aproximada? Empieza una prueba gratuita de Match Data Pro y ejecuta tu primera tarea de coincidencia en cuestión de minutos.
Por qué la coincidencia exacta falla en los datos del mundo real
La mayoría de los conjuntos de datos empresariales contienen la misma entidad con docenas de representaciones ligeramente diferentes. Un cliente llamado «Robert Johnson» aparece como «Bob Johnson», «R. Johnson», «Johnson, Robert» y «Robrt Johson» en cuatro sistemas de origen. Una dirección introducida como «123 Main St Ste 4» en el CRM puede aparecer como «123 Main Street Suite 4» en el ERP. Una empresa llamada «Acme Corp.» en la base de datos de contratos aparece como «ACME Corporation» en el sistema de facturación.
La coincidencia exacta trata esas cuatro variantes de nombre como registros distintos. El resultado es un recuento inflado de clientes, una atribución fragmentada de los ingresos, un gasto duplicado en marketing y una visión de 360 grados incompleta. Según un estudio de IBM sobre la calidad de los datos, una calidad deficiente de los datos supone a las organizaciones un coste medio de 12,9 millones de dólares al año. La coincidencia aproximada es la capa correctiva que salva la brecha entre cómo se introducen los datos y cómo realmente deben consultarse y fusionarse.
El problema fundamental: variabilidad sin una clave compartida
La coincidencia exacta funciona cuando todos los sistemas utilizan una clave única compartida —un ID de cliente, un número de identificación fiscal o un UUID—. La mayoría de las integraciones en la práctica no cuentan con ello. Los datos proceden de adquisiciones, introducciones manuales, enriquecimiento de terceros y migraciones de sistemas heredados. Cada fuente aplica sus propias convenciones de formato. La coincidencia aproximada resuelve el problema de la coincidencia sin clave midiendo la similitud entre cadenas en lugar de exigir la igualdad.
Los seis algoritmos básicos de coincidencia difusa
No hay ningún algoritmo que gestione todos los tipos de datos con la misma eficacia. Los sistemas de coincidencia difusa en entorno de producción combinan varios algoritmos, ponderan sus resultados y calculan una puntuación global. A continuación se explica cómo funcionan los seis algoritmos más importantes y cuándo se debe utilizar cada uno de ellos.
| Algoritmo | Lo mejor para | Fuerza | Debilidad | Ejemplo de puntuación |
|---|---|---|---|---|
| Jaro-Winkler | Nombres de personas | Prefijos comunes de recompensas | Errores en las abreviaturas | «Jon» frente a «John» = 0,93 |
| Levenshtein (distancia de edición) | Cadenas cortas, identificadores | Cuenta con precisión el número mínimo de modificaciones | Lento en las secuencias largas | «colour» frente a «color» = 1 corrección |
| Soundex / Metaphone | Variantes fonéticas del nombre | Recoge «Smith» / «Smyth» | Sin puntuación, resultado binario | «Fischer» = «Fisher» |
| Índice de clasificación de fichas | Direcciones, nombres de empresas | Comparación de tokens independiente del orden | Ignora la semántica de los campos | «Acme Corp Ltd» frente a «Ltd Acme Corp» = 100 |
| Similitud de N-gramas | Textos más largos, descripciones | Gestiona bien la inserción y la eliminación | Depende de la longitud de la cadena | Bigram: «data» frente a «date» = 0,67 |
| Similitud coseno (TF-IDF) | Campos de texto libre | Ponderación por frecuencia de los tokens | Requiere la configuración de la tokenización | Descripciones de productos, notas |
Jaro-Winkler para nombres de personas
Jaro-Winkler añade una bonificación por prefijo a la puntuación base de Jaro, lo que lo hace ideal para nombres en los que las primeras letras son fiables. «Robert» frente a «Roberto» obtiene una puntuación de 0,94. «Katherine» frente a «Kathryn» obtiene una puntuación de 0,91. Esto lo convierte en la opción estándar para los campos de nombre y apellidos en los procesos de deduplicación de CRM. Para obtener más información sobre la deduplicación específica de CRM, consulta nuestra guía sobre deduplicación de CRM y creación de registros de referencia.
Distancia de Levenshtein para identificadores y cadenas cortas
Levenshtein calcula el número mínimo de modificaciones de un solo carácter (inserciones, eliminaciones y sustituciones) necesarias para transformar una cadena en otra. Es ideal para códigos de productos, códigos postales y números de referencia, en los que las transposiciones y los errores tipográficos son el principal tipo de error. «B2B-9014» frente a «B2B-9041» presenta una distancia de 2: los dígitos invertidos «14» / «41». Un umbral de distancia ≤ 2 detecta la mayoría de los errores de introducción de datos en los códigos numéricos.
Algoritmos fonéticos para nombres que suenan parecido
Soundex y Metaphone codifican las cadenas de caracteres en representaciones fonéticas y comparan dichas representaciones. De este modo se tienen en cuenta las variaciones ortográficas propias de cada cultura: «Müller» y «Mueller», «Singh» y «Sing», «Fischer» y «Fisher» se asignan todas a la misma clave fonética. Los algoritmos fonéticos producen un resultado binario (misma clave fonética o no), por lo que resultan más útiles como prefiltro o como uno de los factores en una puntuación compuesta ponderada.
El proceso de coincidencia aproximada: de los registros sin procesar al «registro de referencia»
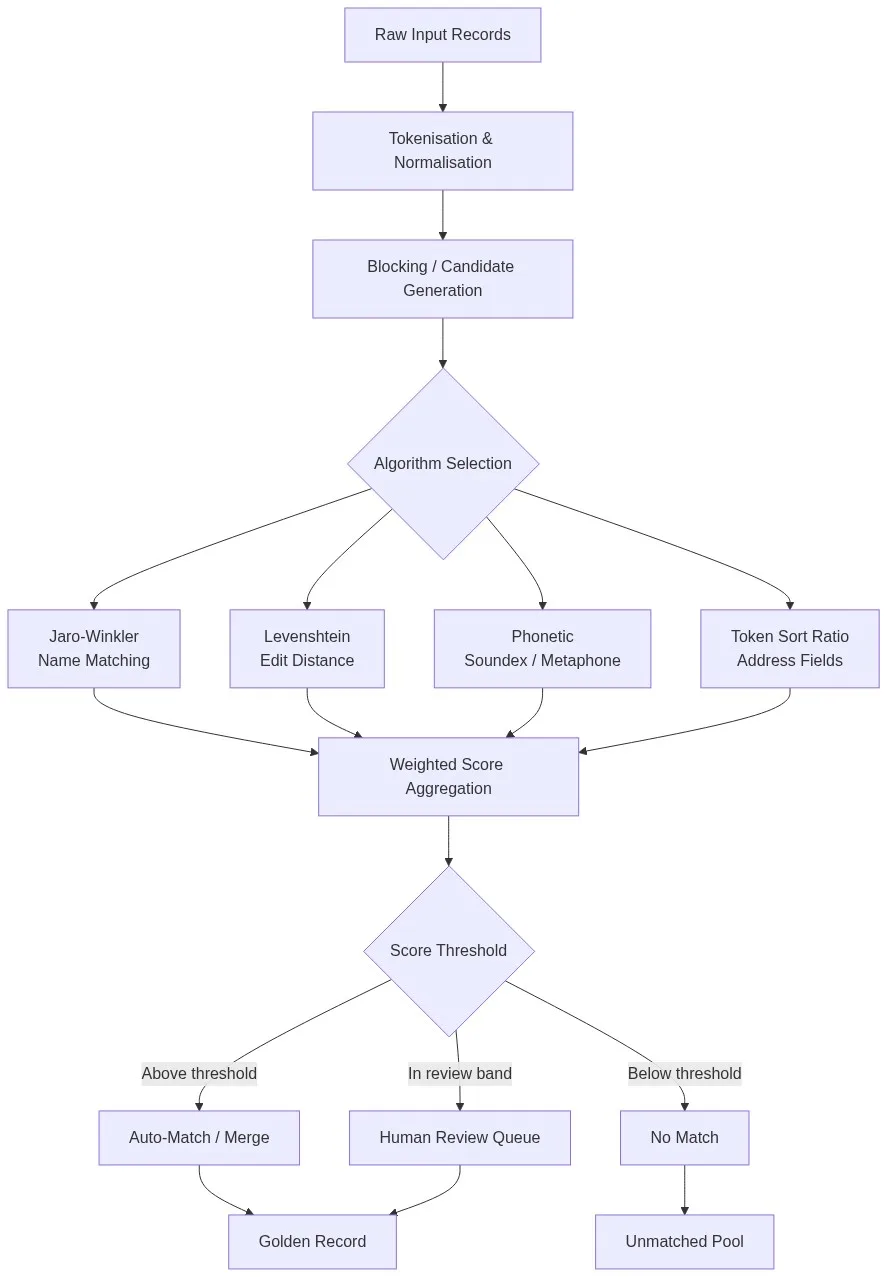
Una tarea de coincidencia difusa en producción no se limita a comparar cada registro con todos los demás. A gran escala, eso supone una complejidad de O(n²), lo cual es computacionalmente inviable para conjuntos de datos con millones de filas. El proceso divide el problema en cinco etapas secuenciales.
Fase 1: Normalización y estandarización
Antes de ejecutar cualquier algoritmo, se normalizan todos los campos. Esto implica convertir las letras a mayúsculas o minúsculas, eliminar los signos de puntuación, desarrollar las abreviaturas («St» a «Street», «Corp» a «Corporation») y estandarizar los formatos de fecha y número de teléfono. La normalización por sí sola resuelve una parte significativa de las discrepancias aparentes antes de que comience la puntuación. Para obtener un desglose completo de esta etapa, lee nuestro artículo sobre las mejores prácticas en materia de estandarización de datos.
Fase 2 — Filtrado (generación de candidatos)
El bloqueo divide el conjunto de datos en grupos en función de una clave compartida —las tres primeras letras de un apellido, el prefijo de un código postal o un código Soundex— y solo compara registros dentro del mismo grupo. Esto reduce el número de comparaciones de O(n²) a O(n log n) sin mermar de forma significativa la recuperación, siempre que la clave de bloqueo se elija con cuidado. Es habitual utilizar conjuntamente varias claves de bloqueo que se solapan para mejorar la recuperación.
Fase 3: puntuación basada en múltiples algoritmos
Cada par de candidatos se puntúa en varios campos mediante algoritmos adecuados para cada uno de ellos. Una configuración típica para un registro de contacto podría tener el siguiente aspecto:
- Nombre: Jaro-Winkler, peso 0,20
- Apellido: Jaro-Winkler + Metaphone, peso 0,30
- Nombre de la empresa: Token Sort Ratio, peso 0,20
- Dirección de correo electrónico: distancia exacta + de Levenshtein ≤ 1, ponderación 0,20
- Número de teléfono: solo los dígitos exactos, peso 0,10
Las puntuaciones ponderadas se suman para obtener una puntuación de coincidencia global comprendida entre 0 y 100. Una puntuación de 92 en un registro de contacto indica una coincidencia casi segura. Una puntuación de 61 es ambigua y se envía a una cola de revisión manual.
Fase 4 — Decisión sobre el umbral
Normalmente se configuran tres bandas:
- Coincidencia automática (fusión automática): puntuación ≥ 90
- Banda de revisión (se requiere una decisión humana): Puntuación de 70 a 89
- No match: Score < 70
El ajuste del umbral es un proceso iterativo. Si el umbral de coincidencia automática se establece en un valor demasiado bajo, se producen fusiones erróneas. Si es demasiado alto, la cola de revisión se satura con coincidencias evidentes. La mayoría de los sistemas de producción realizan una calibración inicial con una muestra etiquetada antes de aplicar los umbrales al conjunto de datos completo.
Etapa 5: Supervivencia y creación del «Disco de Oro»
Una vez confirmado un grupo de coincidencias, las reglas de selección determinan qué valores de los campos se conservan en el registro de referencia fusionado. Entre las reglas más habituales se incluyen: dar prioridad al valor actualizado más recientemente, dar prioridad al sistema de origen con la puntuación de fiabilidad de datos más alta o dar prioridad al valor no nulo más largo. A continuación, el registro de referencia se guarda en el destino de salida: un CRM, un almacén de datos o un sistema de gestión de datos maestros (MDM).
Casos extremos habituales y cómo abordarlos
Los casos extremos son aquellos en los que la mayoría de las implementaciones de coincidencia difusa fallan en la práctica. A continuación se enumeran los más habituales y las estrategias correctas para abordarlos.
Apodos y variantes del nombre legal
«Bill» y «William», «Bob» y «Robert», «Liz» y «Elizabeth»: Jaro-Winkler otorga una puntuación baja a estos pares porque las cadenas comparten pocos caracteres. La solución correcta consiste en una tabla de referencia de apodos que asocie los diminutivos comunes a sus formas canónicas antes de que se ejecute el algoritmo. Sin ella, «William Smith» y «Bill Smith», que tienen la misma dirección, no se emparejarán automáticamente a pesar de ser la misma persona.
Dígitos intercambiados en números de teléfono e identificaciones
Un número de teléfono introducido como «555-1234» frente a «555-1243» tiene una distancia de Levenshtein de 2; sin embargo, es casi seguro que se trate de un error de introducción de datos que hace referencia al mismo número. Elimina primero todos los caracteres de formato y, a continuación, aplica la distancia de Levenshtein solo a los dígitos con un umbral de distancia de 1 o 2. Para identificadores más largos, considera utilizar tanto la distancia de Levenshtein como la de Jaro-Winkler y quedarte con la puntuación más alta.
Sufijos de unidades y componentes de direcciones
«123 Main St Ste 4», «123 Main Street Suite 4» y «123 Main Street #4» se refieren todas a la misma ubicación. La estandarización de direcciones mediante la certificación CASS analiza cada componente —número de calle, nombre de la calle, sufijo, indicador de unidad— antes de realizar la correspondencia. Las herramientas de verificación de direcciones y preparación de datos de Match Data Pro gestionan el análisis de direcciones certificadas por el CASS del USPS como parte del proceso de cotejo, eliminando las variaciones en el sufijo de la unidad antes de que se ejecuten los algoritmos de similitud.
Nombres internacionales y caracteres Unicode
«José García» frente a «Jose Garcia»: los caracteres acentuados que un sistema elimina provocan un error por poco, en el que la coincidencia exacta falla por completo. La normalización Unicode (descomposición NFD seguida de transliteración ASCII) debería ejecutarse antes que cualquier algoritmo. Tanto «Müller» como «Mueller» se normalizan como «Muller» antes de que se ejecute Jaro-Winkler, lo que restaura la puntuación alta esperada.
Coincidencia aproximada frente a resolución de entidades: dónde termina una y empieza la otra
La coincidencia difusa compara pares de registros y genera una puntuación de similitud. La resolución de entidades lleva ese resultado un paso más allá: agrupa los pares de registros coincidentes en clústeres, resuelve los vínculos transitivos (si A coincide con B y B coincide con C, entonces A, B y C son la misma entidad) y mantiene una identidad de entidad persistente a lo largo de las cargas de datos continuas. La resolución de entidades es el proceso a nivel de sistema; la coincidencia difusa es el motor de puntuación que lo integra.
Match Data Pro integra la resolución de entidades, basada en la tecnología de Senzing, directamente en su proceso de comparación. Senzing se encarga del cierre transitivo y de la asignación persistente de identificadores de entidad, mientras que los algoritmos difusos configurables de Match Data Pro se encargan de la puntuación a nivel de campo. Juntos abordan tanto el problema de la puntuación por pares como el del grafo de entidades. Para casos en los que se trabaje con conjuntos de datos de múltiples fuentes, consulta nuestra guía sobre software de deduplicación para la integración de datos de múltiples fuentes.
Elección de umbrales: un enfoque práctico de calibración
La selección del umbral es la decisión de configuración más importante en cualquier implementación de coincidencia difusa. A continuación se describe un proceso de calibración repetible que funciona para la mayoría de los conjuntos de datos B2B:
- Paso 1: Extrae una muestra aleatoria de entre 500 y 1.000 pares de registros que abarquen todo el rango de puntuaciones.
- Paso 2: Pide a expertos en la materia que clasifiquen cada par como «Coincide», «No coincide» o «Incerto».
- Paso 3: Traza las curvas de precisión y recuperación para los distintos umbrales de puntuación. Identifica la puntuación a partir de la cual empiezan a aparecer las fusiones falsas (umbral superior) y la puntuación por debajo de la cual dejan de aparecer las coincidencias verdaderas (umbral inferior).
- Paso 4: Configura la coincidencia automática en el umbral superior. Establece el rango de revisión entre el umbral superior y el inferior. Configura la no coincidencia por debajo del umbral inferior.
- Paso 5: Vuelve a calibrar tras cada incorporación importante de una fuente de datos o cada cambio significativo en el esquema.
El objetivo no es eliminar la cola de revisión, sino garantizar que esta contenga únicamente casos realmente ambiguos, y no coincidencias evidentes ni casos en los que es obvio que no hay coincidencia. El motor de sugerencias de coincidencias basado en IA de Match Data Pro analiza tus pares etiquetados y recomienda ajustes en los umbrales de forma automática, lo que reduce el tiempo de calibración de días a horas. También puedes descubrir cómo encaja esto en el contexto más amplio de nuestro moderno flujo de trabajo de limpieza de datos.
Preguntas frecuentes
¿Qué es la coincidencia aproximada en términos sencillos?
La coincidencia aproximada es una técnica que compara dos cadenas de caracteres y genera una puntuación de similitud, en lugar de un resultado binario de «coincide» o «no coincide». Permite encontrar registros que hacen referencia a la misma entidad del mundo real, incluso cuando los datos tienen un formato inconsistente, contienen errores ortográficos, están abreviados o se han introducido de forma diferente en los distintos sistemas de origen. Es el motor central que sustenta la deduplicación, la resolución de entidades y la consolidación de datos.
¿Cuál es la diferencia entre la coincidencia aproximada y la coincidencia exacta?
La coincidencia exacta requiere que dos cadenas sean idénticas carácter por carácter. La coincidencia aproximada mide el grado de similitud entre dos cadenas en una escala del 0 al 100 y permite configurar un umbral por encima del cual se considera que dos registros coinciden. La coincidencia exacta es rápida, pero poco flexible. La coincidencia aproximada tiene en cuenta la variabilidad de los datos del mundo real —errores ortográficos, abreviaturas, variantes de nombres— a cambio de un mayor tiempo de procesamiento y la configuración de un umbral.
¿Qué algoritmo de búsqueda aproximada debería utilizar para los nombres de personas?
Jaro-Winkler es la opción estándar para los nombres de personas, ya que premia la coincidencia de prefijos, que suelen ser la parte más fiable de un nombre. Combínalo con un algoritmo fonético (Soundex o Metaphone) para los apellidos, a fin de detectar variantes que suenan de forma similar. Además, aplica una tabla de búsqueda de apodos antes de la puntuación para gestionar las diferencias entre el nombre legal y el nombre común, como «William» y «Bill».
¿Qué umbral de puntuación debo utilizar para la correspondencia automática de registros?
No hay una respuesta universal: los umbrales dependen de la calidad de tus datos, del ámbito y de tu tolerancia al riesgo de fusiones erróneas. Un punto de partida habitual es la coincidencia automática a partir de 90, la revisión de los valores entre 70 y 89, y la no coincidencia por debajo de 70. Calibre el sistema etiquetando una muestra aleatoria de entre 500 y 1.000 pares y trazando curvas de precisión y recuperación a lo largo del rango de umbrales. Vuelva a calibrar el sistema cuando añada nuevas fuentes de datos.
¿En qué se diferencia la coincidencia aproximada de la resolución de entidades?
La coincidencia difusa evalúa el grado de similitud entre pares de registros. La resolución de entidades utiliza esas puntuaciones para agrupar los registros en clústeres que representan la misma entidad del mundo real, resolviendo los vínculos transitivos y manteniendo una identidad de entidad persistente a lo largo de las cargas de datos. La coincidencia difusa es el motor de puntuación a nivel de campo; la resolución de entidades es el sistema que gestiona el grafo de entidades resultante. La mayoría de las plataformas de calidad de datos en producción utilizan ambas tecnologías de forma conjunta.
Si desea profundizar en el tema de la resolución de entidades, consulte nuestro artículo sobre algoritmos y flujos de trabajo de correspondencia de entidades y, para casos de uso específicos del sector sanitario, nuestra guía sobre la resolución de entidades en el ámbito sanitario.
Empieza a utilizar la búsqueda aproximada con tus datos
Match Data Pro ofrece a los ingenieros de datos y a los equipos de operaciones un motor de coincidencia aproximada configurable —Jaro-Winkler, Levenshtein, Soundex, Token Sort y otros— con sugerencias de coincidencia basadas en IA, una cola de revisión ajustable y la resolución de entidades de Senzing integrada. Se puede implementar como SaaS o en las propias instalaciones, sin necesidad de contrato a largo plazo.
- Empieza una prueba gratuita — ejecuta tu primer trabajo de búsqueda aproximada en cuestión de minutos, sin necesidad de tarjeta de crédito.
- Reserva una demostración — observa en directo cómo se ejecuta una tarea de coincidencia aproximada con tu propia muestra de datos.
- Habla con el equipo: sales@matchdatapro.com