
El mejor software de resolución de entidades para 2026 combina la coincidencia probabilística basada en grafos, algoritmos difusos configurables y un proceso completo de selección de registros válidos, todo ello implementable en cuestión de días, no de meses. Las plataformas que ofrecen estas prestaciones ayudan a los equipos de datos a vincular registros fragmentados procedentes de CRM, ERP y fuentes de terceros en un «registro de referencia» verificado, con índices de precisión superiores al 95 %. Match Data Pro, que utiliza el motor de resolución de entidades de Senzing, está diseñado precisamente para esta tarea.
¿No sabes qué plataforma se adapta mejor a tus necesidades? Reserva una demostración y comprueba cómo funciona la resolución de entidades con tus propios datos en menos de 30 minutos.
Qué hace realmente el software de resolución de entidades
La resolución de entidades es el proceso de determinar si dos o más registros se refieren a la misma entidad del mundo real —un cliente, una empresa, un paciente o un proveedor— en conjuntos de datos que no comparten ninguna clave primaria común. El software debe gestionar los errores ortográficos en los nombres, las variantes de las direcciones, los dígitos invertidos y los campos que faltan sin intervención humana en cada par.
Una plataforma de nivel de producción lo hace mediante un proceso por etapas:
- Análisis de perfiles: comprueba todos los campos en busca de valores nulos, errores de formato y anomalías en la distribución antes de que se ejecute cualquier proceso de emparejamiento.
- Estandarización: unifica los nombres, los formatos de los números de teléfono, los formatos de fecha y las estructuras de las direcciones para que los algoritmos de puntuación funcionen con datos coherentes.
- Agrupación: agrupa pares de candidatos en función de los datos comunes (código postal, inicial del apellido, código del sector) para reducir las comparaciones de complejidad O(n²) a un subconjunto manejable.
- Puntuación difusa: aplica los algoritmos de Levenshtein, Jaro-Winkler, fonético y basado en tokens para cada campo y, a continuación, combina las puntuaciones utilizando ponderaciones configurables.
- Resolución de entidades: un motor de grafos agrupa los pares coincidentes en grupos de entidades, resolviendo los enlaces transitivos (A = B, B = C → A = B = C)
- Supervivencia: las reglas seleccionan el mejor valor para cada campo de entre todos los registros que contribuyen a crear el «registro de referencia».
El motor de resolución de entidades de Match Data Pro ejecuta las seis etapas en un flujo de trabajo automatizado sin necesidad de intervenciones manuales entre los distintos pasos.
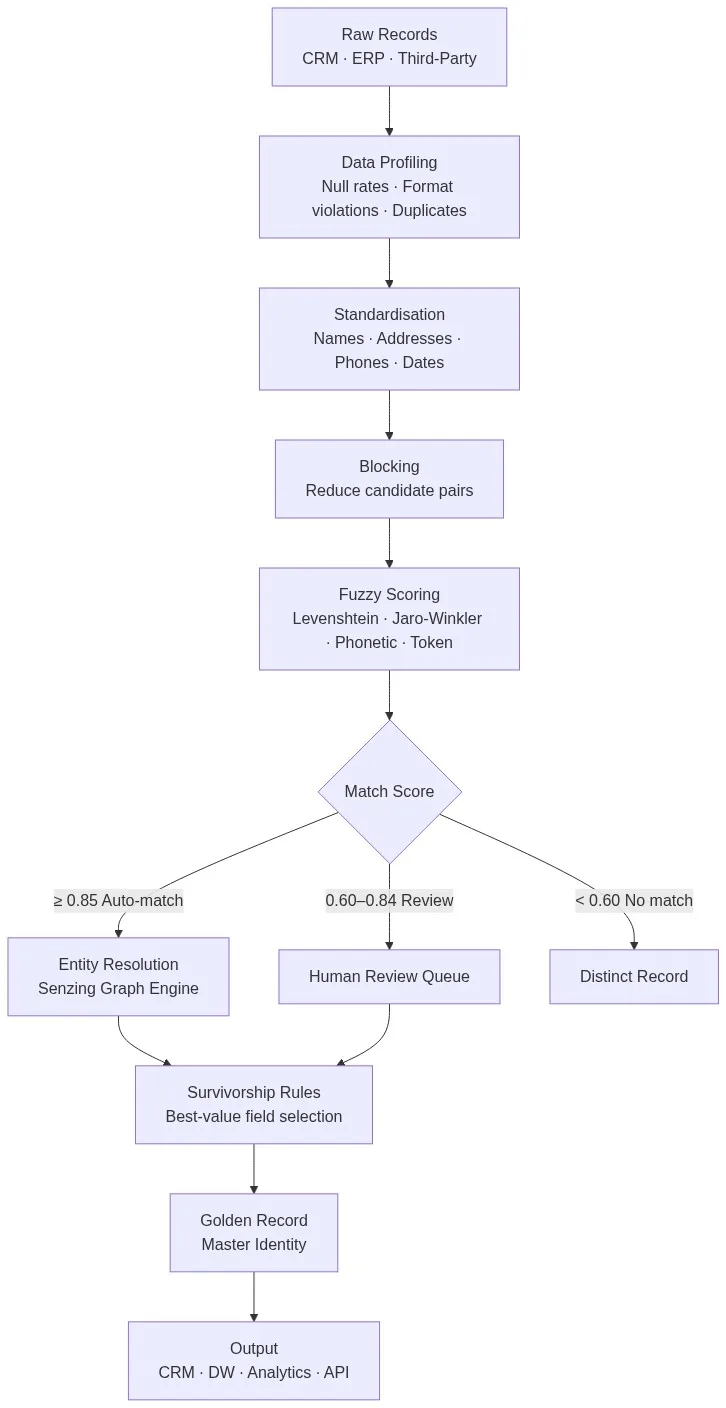
Seis características que diferencian a las plataformas de nivel profesional de las herramientas básicas
1. Emparejamiento probabilístico basado en grafos
Las herramientas básicas comparan pares de registros de forma aislada. Los motores basados en grafos rastrean las relaciones entre los pares. Si el registro A coincide con el registro B, y el registro B coincide con el registro C, el motor de grafos agrupa a A, B y C en el mismo clúster de entidades, incluso si A y C no comparten ninguna señal de coincidencia directa. La integración de Match Data Pro con Senzing utiliza este enfoque. Está preentrenada con patrones globales de nombres y direcciones, por lo que los equipos se ahorran meses de creación manual de reglas.
2. Sistema de puntuación difusa configurable con múltiples algoritmos
No existe un único algoritmo que sirva para todos los tipos de campos. Los nombres requieren una coincidencia según el método Jaro-Winkler o una coincidencia fonética. Las direcciones requieren primero una comparación basada en tokens y una normalización CASS. Los números de teléfono requieren una normalización basada únicamente en dígitos antes de aplicar la puntuación de Levenshtein. Una plataforma que imponga un único algoritmo para todos los campos generará falsos positivos en las direcciones y no detectará coincidencias en los nombres.
El motor de coincidencia aproximada de Match Data Pro permite a los equipos asignar diferentes algoritmos y ponderaciones por campo y, a continuación, ajustar los umbrales mediante una distribución visual de puntuaciones, sin necesidad de escribir código.
3. Verificación de direcciones certificada por CASS
Los datos de direcciones son la fuente más habitual de falsas discrepancias. «123 Main St» y «123 Main Street, Suite 4B» se refieren a la misma ubicación, pero la comparación de cadenas les otorga una puntuación baja. La verificación de direcciones CASS normaliza y valida cada dirección con la base de datos postal del USPS antes de que comience la búsqueda de coincidencias, corrigiendo abreviaturas, añadiendo el ZIP+4 y eliminando el ruido a nivel de unidad. Este paso por sí solo puede aumentar la tasa de recuperación de coincidencias entre 8 y 15 puntos porcentuales en conjuntos de datos con gran cantidad de direcciones.
4. Perfilado de datos de IA antes de cada ejecución
Los equipos que prescinden del perfilado de datos pasan días depurando errores de coincidencia provocados por problemas en los datos de origen. Una buena plataforma de resolución de entidades ejecuta automáticamente el perfilado de datos mediante IA en el momento de la ingesta: señala las tasas de valores nulos que superan el umbral, detecta formatos de fecha inesperados e identifica columnas con alta cardinalidad que provocarán errores de coincidencia bloqueantes. Match Data Pro perfila cada conjunto de datos en el momento de la importación y muestra una ficha de evaluación de calidad antes de que comience el proceso de coincidencia.
5. Reglas de supervivencia y generación del «Golden Record»
La correspondencia es solo la mitad del problema. Una vez identificados los grupos, los equipos deben decidir qué valor de campo se mantiene en el registro maestro. Las reglas de supervivencia codifican esa lógica: utilizar el valor actualizado más recientemente, dar preferencia a la fuente con la puntuación de exhaustividad más alta o aplicar una lógica personalizada para campos específicos. El motor de supervivencia y de «registro de referencia» de Match Data Pro es compatible con estos tres enfoques mediante una interfaz de configuración sin código.
6. API en tiempo real para la comparación continua
La comparación por lotes limpia los datos históricos. Sin embargo, cada día se introducen nuevos registros en los sistemas. Una plataforma de resolución de entidades en producción necesita una API de comparación en tiempo real que evalúe los registros entrantes comparándolos con el grafo de entidades existente en el momento de su entrada, evitando así que se acumulen duplicados. Match Data Pro ofrece una API de búsqueda aproximada en tiempo real que devuelve candidatos coincidentes con puntuaciones e identificadores de clústeres de entidades en milisegundos.
Cómo evaluar el software de resolución de entidades: un marco de decisión
Paso 1: Define tus objetivos de precisión y recuperación en la búsqueda
Empieza por las cifras. ¿Qué tasa de falsos positivos es aceptable? Un flujo de trabajo de KYC puede no tolerar ningún falso positivo. Una tarea de deduplicación de datos de marketing puede aceptar un 2 %. Define los objetivos tanto de precisión (coincidencias correctas / total de coincidencias) como de recuperación (coincidencias correctas / total de coincidencias verdaderas) antes de evaluar a cualquier proveedor. Sin estos datos, todas las demostraciones parecerán impresionantes.
Paso 2: Realiza pruebas con tus propios datos
Las comparativas de proveedores se realizan con conjuntos de datos limpios y seleccionados. Tus datos presentan peculiaridades específicas: abreviaturas del sector, formatos de direcciones internacionales o esquemas de codificación heredados. Insiste en que se realice una prueba de concepto con una muestra de entre 10 000 y 50 000 registros procedentes de tu entorno real. Match Data Pro ofrece una prueba gratuita en la que los equipos pueden cargar datos reales y ejecutar un proceso completo de comparación sin necesidad de adquirir una licencia.
Paso 3: Evaluar la idoneidad de la implementación
Las plataformas SaaS en la nube se implementan en cuestión de horas y no requieren gestión de infraestructura. Match Data Pro funciona como un servicio SaaS en la nube sin contrato a largo plazo, lo que significa que los equipos pueden poner en marcha una prueba piloto en producción en cuestión de días, en lugar de trimestres. Los equipos que tengan requisitos de residencia de datos deben evaluar si el proveedor ofrece opciones de nube privada o de instalación local.
Paso 4: Comprobar la escala y el rendimiento
La resolución de entidades en 10.000 registros es un problema distinto al de la resolución de entidades en 100 millones de registros. Pide a los proveedores que te faciliten pruebas de rendimiento documentadas con el número de registros que te interesa. La estrategia de bloqueo es de vital importancia a gran escala: una pasada de bloqueo mal configurada puede hacer que un motor, que de otro modo sería capaz, resulte inaceptablemente lento.
Paso 5: Verificar la auditoría y la explicabilidad
Las autoridades reguladoras y los equipos de gobernanza interna necesitan comprender por qué se han emparejado o no dos registros. Busque desgloses de la puntuación de coincidencia a nivel de campo, las ponderaciones de los algoritmos utilizadas por campo y un registro de auditoría completo de cada decisión de emparejamiento. El motor de resolución de entidades y vinculación de datos de Match Data Pro registra cada decisión de puntuación, lo que facilita las revisiones de cumplimiento normativo.
Errores habituales en la resolución de entidades y cómo evitarlos
Error 1: Emparejamiento con datos no estandarizados
Realizar coincidencias aproximadas en campos sin procesar y no normalizados es la causa principal de una baja precisión en las coincidencias. «IBM Corporation», «I.B.M.» e «International Business Machines» obtendrán una puntuación inferior al umbral en los algoritmos de comparación de cadenas, a menos que se lleve a cabo primero la normalización del nombre de la empresa. Normaliza siempre los datos antes de calcular la puntuación.
Error 2: Puntuación basada en un único algoritmo
Una plataforma que utilice únicamente la distancia de Levenshtein asignará a «Jon» frente a «John» una puntuación de 0,75 (una modificación de un carácter) —por debajo de la mayoría de los umbrales de coincidencia—, aunque, según el contexto, ambos nombres se refieran claramente a la misma persona. Los enfoques que combinan varios algoritmos —como la similitud fonética, los diccionarios de apodos y las señales contextuales— resuelven este tipo de error.
Error 3: Saltarse el bloqueo
Sin el bloqueo, un conjunto de datos de un millón de registros genera 500.000 millones de pares candidatos. Ni siquiera un motor de puntuación rápido puede procesar esta cantidad en un plazo de tiempo razonable. El bloqueo reduce los pares candidatos en más del 99 % al comparar únicamente los registros que comparten al menos un token: la inicial del apellido, el código postal o el código del sector. Omitir o configurar incorrectamente el bloqueo es la causa principal de que las tareas de resolución de entidades nunca se completen.
Error n.º 4: Falta de una estrategia de supervivencia
Los equipos que se centran únicamente en la correspondencia y descuidan la lógica de supervivencia acaban obteniendo grupos de entidades que no aportan resultados útiles. Sin reglas de supervivencia, no existe un «registro de referencia», sino solo una lista de pares emparejados. Define la lógica de supervivencia antes de la primera ejecución en producción.
Preguntas frecuentes
¿Qué es un software de resolución de entidades y para qué sirve?
El software de resolución de entidades identifica los registros de distintos conjuntos de datos que hacen referencia a la misma entidad del mundo real y los vincula en un registro de referencia verificado. Utiliza algoritmos de coincidencia aproximada, estrategias de bloqueo y agrupamiento basado en grafos para resolver identidades sin una clave primaria compartida. Las plataformas de nivel de producción también gestionan la «supervivencia», es decir, seleccionan los mejores valores de campo de entre todos los registros que contribuyen.
¿En qué se diferencia la resolución de entidades de la simple eliminación de duplicados?
La deduplicación elimina los registros duplicados exactos o casi exactos dentro de un mismo conjunto de datos. La resolución de entidades va más allá: vincula registros de múltiples fuentes, gestiona relaciones transitivas complejas (A coincide con B, B coincide con C; por lo tanto, A y C son la misma entidad) y genera un grafo de identidades agrupadas, en lugar de limitarse a una simple lista deduplicada. La mayoría de los casos de uso empresariales requieren ambas cosas.
¿Qué índices de precisión puedo esperar de un software de resolución de entidades?
Los procesos de resolución de entidades bien configurados suelen alcanzar una precisión del 93-97 % y un recuerdo del 88-95 % en datos empresariales. La precisión depende en gran medida de la calidad de los datos antes de que comience la comparación, de la configuración de los filtros, de la selección del algoritmo y de si se ha aplicado la verificación de direcciones CASS. Una prueba de concepto con tus propios datos es la única forma fiable de establecer unas expectativas realistas.
¿Cuánto tiempo se tarda en implementar una plataforma de resolución de entidades?
Las plataformas SaaS en la nube, como Match Data Pro, pueden implementarse y ejecutar una primera tarea de comparación en tan solo un día. La fase que más tiempo lleva es la configuración: definir las claves de bloqueo, las ponderaciones de los algoritmos y las reglas de supervivencia para tus datos específicos. La mayoría de los equipos completan la configuración inicial en una o dos semanas. La puesta en marcha completa en producción, incluida la integración con los sistemas posteriores, suele llevar entre dos y seis semanas.
¿Cuándo conviene utilizar la resolución de entidades en tiempo real y cuándo el procesamiento por lotes?
Utiliza la resolución de entidades en tiempo real en el momento de la ingesta de registros: cuando se crean nuevos clientes en un CRM, cuando se importan registros de proveedores desde el departamento de compras o cuando llegan datos de pacientes desde un sistema externo. Utiliza el procesamiento por lotes para la limpieza histórica de los conjuntos de datos existentes. La mayoría de los entornos de producción necesitan ambas cosas: una ejecución por lotes para limpiar los datos históricos y una API en tiempo real para evitar que se acumulen nuevos duplicados.