
La resolución de entidades y la vinculación de datos son los métodos que utilizan los equipos de datos modernos para conectar registros que describen la misma entidad del mundo real en dos o más bases de datos, sin una clave primaria compartida. El proceso utiliza puntuación difusa, agrupación en bloques y almacenes de identidades basados en grafos para vincular registros de clientes, proveedores o pacientes que llegan con nombres, direcciones o identificadores diferentes. Sin ello, cada sistema aislado mantiene su propia visión incompleta de cada entidad, y los análisis, el cumplimiento normativo y las operaciones se ven afectados negativamente.
¿Estás listo para relacionar los datos de tus bases de datos? Empieza una prueba gratuita de Match Data Pro y ejecuta tu primera tarea de resolución de entidades en cuestión de minutos, sin necesidad de contrato.
Por qué las bases de datos aisladas generan identidades fragmentadas
La mayoría de las organizaciones acumulan datos en al menos entre cuatro y seis sistemas distintos: un CRM para los contactos con los clientes, un ERP para las transacciones, una plataforma de automatización de marketing para las respuestas a las campañas, un sistema de gestión de incidencias de atención al cliente y, a menudo, una o más fuentes de datos de terceros. Cada sistema asigna su propio identificador interno. Cada uno captura los campos en su propio formato. Un cliente llamado «Robert J. Smith» en el CRM aparece como «Bob Smith» en el sistema de asistencia y como «R. Smith», con la dirección 42 Oak St, en el ERP.
Esta fragmentación tiene consecuencias cuantificables:
- Los equipos de análisis cuentan al mismo cliente dos o tres veces, lo que inflama las cifras de número de clientes.
- Los comerciales se ponen en contacto con el mismo cliente potencial desde dos colas simultáneamente.
- Los equipos de cumplimiento normativo no pueden ofrecer una visión global de la exposición de los clientes en todas las líneas de productos.
- Los proyectos de migración contienen el triple de registros de los que necesita el sistema de destino.
El análisis de perfiles de datos suele revelar que entre el 10 % y el 30 % de los registros de un sistema CRM consolidado son duplicados o fragmentos de un registro que existe en otro sistema. La resolución de entidades agrupa esos fragmentos en una única identidad de referencia.
¿En qué se diferencia la resolución de entidades de la vinculación de datos?
Ambos términos se solapan, pero describen ámbitos ligeramente diferentes:
- La resolución de entidades identifica todos los registros —ya sea dentro de un mismo conjunto de datos o en varios— que hacen referencia a la misma entidad del mundo real y los agrupa en un clúster. A continuación, el clúster se sintetiza en un registro de referencia.
- La vinculación de datos conecta registros de dos conjuntos de datos distintos mediante un enlace persistente, sin que ello implique necesariamente fusionarlos. Los registros de origen permanecen separados; una tabla de referencias cruzadas los asocia a un identificador de entidad común.
En la práctica, la mayoría de los equipos de datos necesitan ambas cosas. Un equipo sanitario vincula los historiales de los pacientes entre los sistemas de historias clínicas electrónicas (HCE), farmacia y laboratorio (vinculación de datos) y, a continuación, resuelve los duplicados dentro de cada sistema de origen (resolución de entidades) antes del análisis. La resolución de entidades de Match Data Pro, basada en la tecnología de Senzing, gestiona ambas operaciones en un único proceso.
El elemento común: puntuación de similitud
Tanto la resolución de entidades como la vinculación de datos se basan en la comparación de valores de campos que, aunque no sean idénticos, describen lo mismo. Entre los algoritmos que permiten realizar esta comparación se encuentran:
- Distancia de Levenshtein: calcula el número mínimo de modificaciones de caracteres entre dos cadenas. La comparación entre «Smyth» y «Smith» da un resultado de 0,80.
- Jaro-Winkler: da mayor peso a la concordancia del prefijo, lo cual resulta útil para los nombres propios. «Jonathan» frente a «Jon» obtiene una puntuación de 0,87.
- Codificación fonética: NYSIIS o Double Metaphone, útil para nombres que suenan igual pero se escriben de forma diferente. «Garcia» y «Garsia» generan el mismo código fonético.
- Coincidencia basada en tokens: divide los campos en tokens antes de la puntuación, lo que permite tratar correctamente casos como «Oak Street» frente a «St. Oak».
No existe ningún algoritmo que funcione para todos los tipos de campos. Un modelo de puntuación ponderada basado en múltiples algoritmos combina varias puntuaciones para obtener un índice de confianza de coincidencia global que resulta más sólido que cualquier métrica individual.
El proceso de resolución de entidades y vinculación de datos en seis etapas
El siguiente diagrama muestra el proceso completo, desde los registros de origen sin procesar hasta la salida de un «registro de referencia» vinculado.
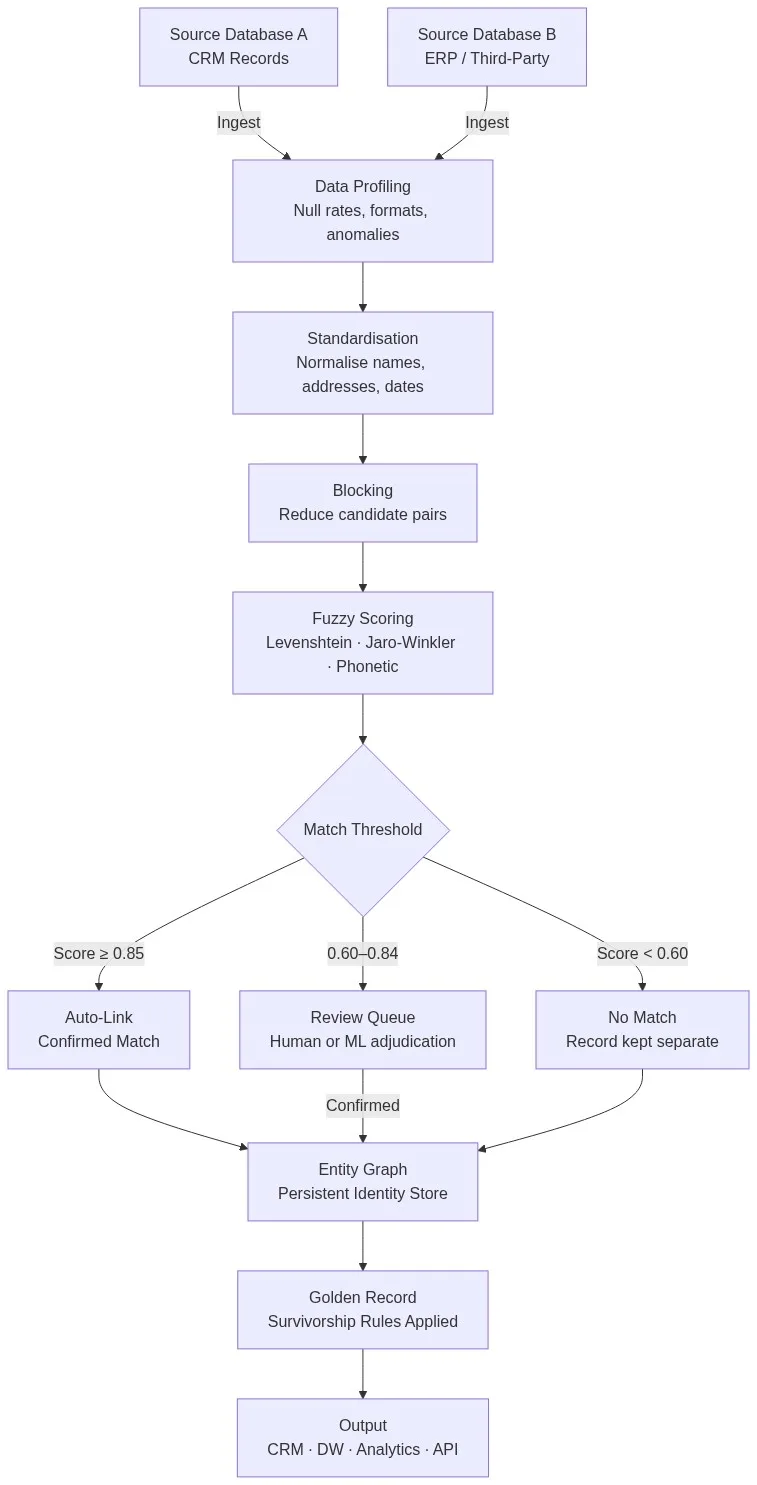
Fase 1: Perfilado de datos
Antes de vincular nada, es necesario comprender qué es lo que tienes. El análisis de perfiles de datos basado en IA examina todos los campos de cada conjunto de datos de origen e informa sobre las tasas de valores nulos, las distribuciones de formatos, los rangos de valores y las anomalías. Un análisis de un CRM típico con 500 000 registros podría revelar que el 22 % de los campos de teléfono están en blanco, que el 14 % de los nombres de empresas contienen sufijos legales («LLC», «Inc.», «Corp.») en formatos inconsistentes y que el 8 % de los códigos postales son cadenas de cinco dígitos almacenadas como números enteros sin los ceros iniciales. Cada uno de estos casos supone un riesgo de coincidencia que el análisis de perfiles pone de manifiesto antes de que provoque falsos negativos en etapas posteriores.
Fase 2: Normalización
La estandarización de datos normaliza los valores de los campos para que los algoritmos de coincidencia comparen elementos similares entre sí. Entre las transformaciones más habituales se incluyen:
- Desarrollo de abreviaturas: «St.» por «Street», «Blvd.» por «Boulevard».
- Eliminación de los sufijos legales de los nombres de las empresas: «Acme Inc.» pasa a ser «Acme».
- Normalización de formatos de números de teléfono: «(800) 555-1234», «800.555.1234» y «8005551234» se convierten todos al formato E.164.
- Convertir los nombres a mayúsculas y eliminar los espacios en blanco en los campos de nombre.
Saltarse esta etapa es la causa más habitual de falsos negativos. Dos registros que describen a la misma empresa —«Acme Corp.» en un sistema y «ACME CORPORATION» en otro— obtendrán una puntuación inferior a cualquier umbral razonable si no se lleva a cabo una normalización previa.
Etapa 3: Bloqueo
Comparar cada registro con todos los demás resulta inviable desde el punto de vista computacional a gran escala. Un conjunto de datos de un millón de registros genera 500 000 millones de pares posibles. El «blocking» reduce esta cifra agrupando los registros en «buckets» mediante una clave compartida —los tres primeros caracteres del apellido, el código postal de cinco dígitos o el dominio extraído de la dirección de correo electrónico— y comparando únicamente los registros dentro del mismo «bucket». Una estrategia de «blocking» bien diseñada reduce los pares posibles en un 99,9 %, al tiempo que conserva más del 98 % de las coincidencias reales.
Etapa 4: Puntuación difusa
Cada par de candidatos dentro de un bloque recibe una puntuación de similitud compuesta. El motor de coincidencia difusa de Match Data Pro, basado en inteligencia artificial, aplica ponderaciones algorítmicas configurables según el tipo de campo y devuelve una única puntuación de confianza comprendida entre 0 y 1. Consideremos estos dos registros:
| Campo | Registro A (CRM) | Registro B (ERP) | Puntuación |
|---|---|---|---|
| Nombre | Robert | Bob | 0.72 |
| Apellido | Smith | Smyth | 0.80 |
| Empresa | Acme Corp. | Acme | 0.91 |
| Código postal | 94105 | 94105 | 1.00 |
| Correo electrónico | rsmith@acme.com | bob.smith@acme.com | 0.78 |
| Compuesto | 0.84 |
Una puntuación compuesta de 0,84 se encuentra en la zona de revisión para la mayoría de las configuraciones. Si se eleva el umbral de enlace automático a 0,90, este par pasa a la cola de revisión; si se reduce a 0,80, se establece el enlace automático. El umbral adecuado depende del coste de los falsos positivos frente al de los falsos negativos en tu caso concreto.
Etapa 5: Gráfico de entidades y supervivencia
Las coincidencias confirmadas se registran en un grafo de entidades —un almacén de identidades persistente que asocia cada ID de registro de origen a un ID de entidad canónico—. La integración de Match Data Pro con Senzing construye este grafo de forma incremental: a medida que llegan nuevos registros, se evalúan en relación con las entidades existentes y, o bien se vinculan a una de ellas, o bien se registran como nuevas. El grafo se mantiene entre ejecuciones del proceso, por lo que nunca se vuelven a evaluar los pares que ya han sido clasificados.
Las reglas de prevalencia determinan entonces qué valor de campo «prevalece» en el registro de referencia. Entre las reglas más comunes se encuentran la de «escritura más reciente», la de «registro más completo» o la de «prioridad del sistema de origen». Un registro de empresa con una dirección completa procedente del ERP prevalece sobre la dirección parcial del CRM, ya que el ERP presenta un mayor grado de completitud en los campos. El motor de prevalencia configurable de Match Data Pro aplica estas reglas campo por campo.
Etapa 6: Producción y distribución
Los registros dorados y la tabla de referencias cruzadas entre entidades y fuentes se transfieren a los sistemas posteriores a través de la API REST, la exportación de archivos o un conector directo a la base de datos. Los conectores de importación y exportación de Match Data Pro son compatibles con CSV, JSON, bases de datos SQL, Salesforce, HubSpot y los formatos habituales de los almacenes de datos. La API de búsqueda aproximada en tiempo real también permite a las aplicaciones posteriores consultar el grafo de entidades en tiempo real, lo que resulta útil para evitar nuevos duplicados en el punto de entrada.
Casos habituales de vinculación de datos por sector
Ventas B2B y RevOps
Una empresa típica de SaaS B2B utiliza Salesforce para la gestión de relaciones con los clientes (CRM), HubSpot para el marketing, Zendesk para la atención al cliente y un almacén de datos para el análisis. La misma cuenta aparece en los cuatro sistemas con nombres de empresa y grafías de los contactos ligeramente diferentes. Sin la resolución de entidades, la atribución de ingresos a nivel de cuenta resulta imposible y se producen conflictos en la asignación de territorios. Con un grafo de entidades vinculado, todos los sistemas comparten un identificador de cuenta canónico y una lista de contactos depurada.
Servicios financieros
Los bancos y las gestoras de activos deben vincular los registros de los clientes entre los sistemas de banca minorista, corretaje y seguros para obtener una visión consolidada del cliente con fines de verificación de identidad (KYC) y de control contra el blanqueo de capitales (AML). Un cliente que tenga tanto una cuenta corriente como una cuenta de inversión aparece en dos sistemas centrales con formatos de dirección ligeramente diferentes. La resolución de entidades los vincula bajo un único identificador de entidad, lo que permite un cálculo preciso de la exposición y la comprobación de listas de vigilancia. Obtén más información en nuestra guía sobre la resolución de entidades en los servicios financieros.
Sanidad
La correspondencia de pacientes entre los sistemas de historias clínicas electrónicas (HCE), de laboratorio, de farmacia y de reclamaciones es una cuestión de seguridad del paciente, no solo un problema de calidad de los datos. Un paciente cuyo nombre figure como «María Elena Gutiérrez» en la HCE y como «M. E. Gutiérrez-López» en el sistema de laboratorio podría recibir prescripciones duplicadas o, lo que es peor, que sus resultados se atribuyan a una historia clínica equivocada. La resolución de entidades en el ámbito sanitario debe tener en cuenta los apellidos con guion, las transposiciones en la fecha de nacimiento (14-03-1987 frente a 14-03-1987) y los cambios de dirección desde la última visita. Consulta nuestra guía detallada sobre la resolución de entidades en el ámbito sanitario.
Decisiones clave sobre la configuración
Estrategia de umbral
La mayoría de los procesos de producción utilizan un modelo de umbral de tres zonas:
- Zona de vinculación automática (≥ 0,85): los registros se vinculan sin revisión humana.
- Zona de revisión (0,60–0,84): los pares se ponen en cola para que los revise un gestor de datos o un clasificador de aprendizaje automático.
- Zona sin enlace (por debajo de 0,60): los registros se mantienen separados.
El límite entre las zonas varía en función del ámbito. Un equipo sanitario puede establecer el umbral de enlace automático en 0,92 para minimizar los falsos positivos. Una tarea de deduplicación de marketing puede aceptar un valor de 0,80, ya que el coste de no realizar una fusión es menor que el de un falso positivo.
Bloqueo de la selección de teclas
Las claves de bloqueo deben ser tanto selectivas (grupos reducidos) como robustas (consistentes a pesar de los problemas de calidad de los datos). Utilizar el nombre de una empresa tal cual como clave de bloqueo falla si un sistema almacena «Acme» y otro «Acme Corp.». Una clave más adecuada son los cinco primeros caracteres del nombre estandarizado de la empresa combinados con el código postal de cinco dígitos. Match Data Pro admite claves de bloqueo compuestas y múltiples pasadas de bloqueo superpuestas para maximizar la recuperación.
Actualización incremental frente a actualización completa
La actualización completa vuelve a evaluar cada par de registros desde cero en cada ejecución del proceso. Este método es preciso, pero resulta costoso a gran escala. El procesamiento incremental evalúa únicamente los registros nuevos o modificados en relación con el grafo de entidades existente. El motor de automatización de tareas de Match Data Pro es compatible con ambos modos; las ejecuciones incrementales suelen completarse en menos de cinco minutos para conjuntos de datos de menos de 10 millones de registros cuando el grafo de entidades ya está rellenado.
Cómo gestiona Match Data Pro la resolución de entidades y la vinculación de datos
Match Data Pro es una plataforma SaaS en la nube que combina todas las etapas del proceso de resolución de entidades y vinculación de datos en un único entorno. No hay contrato ni infraestructura que aprovisionar. Solo tienes que cargar o conectar tus conjuntos de datos de origen, configurar las correspondencias de campos y las ponderaciones de los algoritmos, establecer tus umbrales y ejecutar el proceso. El motor de resolución de entidades de Senzing se encarga de la construcción de grafos y de las actualizaciones incrementales. El módulo de perfilado mediante IA señala los problemas de calidad de los datos antes de que se ejecute la tarea de coincidencia. La verificación de direcciones CASS estandariza y valida todas las direcciones postales antes de que lleguen a la fase de puntuación.
Para los equipos que desarrollan flujos de trabajo basados en eventos o en tiempo real, la API de búsqueda difusa en tiempo real permite que cualquier aplicación consulte el grafo de entidades y compruebe si un registro entrante coincide con una entidad existente antes de que se guarde, lo que evita los duplicados desde el origen en lugar de tener que eliminarlos posteriormente.
Reserva una demostración de 30 minutos para ver en directo cómo funciona la resolución de entidades con datos de ejemplo de tu sector, o regístrate para obtener una prueba gratuita y conecta tu primer conjunto de datos hoy mismo.
Preguntas frecuentes
¿Cuál es la diferencia entre la resolución de entidades y la vinculación de registros?
La vinculación de registros conecta registros de dos conjuntos de datos mediante una tabla de referencias cruzadas, dejando intactos los registros originales. La resolución de entidades va más allá: agrupa todos los registros que hacen referencia a la misma entidad del mundo real —tanto dentro de un mismo conjunto de datos como entre distintos conjuntos— y los fusiona en un único «registro de referencia». La mayoría de los procesos empresariales necesitan ambos, y en la práctica estos dos términos suelen utilizarse indistintamente.
¿Cuántos sistemas de origen puede gestionar la resolución de entidades a la vez?
No existe un límite estricto en cuanto al número de sistemas de origen. Los registros de cada sistema se analizan y estandarizan de forma independiente antes de incorporarse al proceso compartido de puntuación. Match Data Pro admite la importación simultánea desde archivos CSV, bases de datos SQL, API REST y conectores CRM. El grafo de entidades agrupa las coincidencias de todas las fuentes en un único almacén de identidades, independientemente del número de sistemas que lo alimenten.
¿Qué umbral de coincidencia debo utilizar para la resolución de entidades?
Un valor inicial de 0,85 para la vinculación automática y de 0,60 para la zona de revisión suele ser adecuado para la mayoría de los casos de deduplicación de uso general. En los casos de uso regulados —como la identificación de pacientes en el ámbito sanitario o el «KYC» (conozca a su cliente) en el sector financiero— suele aumentarse el umbral de vinculación automática a 0,90 o más. Ajuste los umbrales revisando entre 200 y 300 pares evaluados manualmente a partir de sus datos específicos y midiendo la precisión y la recuperación en cada umbral candidato.
¿La resolución de entidades puede gestionar nombres y direcciones internacionales?
Sí. Los codificadores fonéticos, como Double Metaphone, gestionan nombres transcritos en lenguas que utilizan el alfabeto latino. Los algoritmos basados en tokens resultan eficaces para los campos de dirección en los que el orden de los componentes varía según el país. En cuanto a la validación postal, la verificación de direcciones CASS de Match Data Pro cubre las direcciones de EE. UU., y la función de coincidencia aproximada de direcciones de la plataforma gestiona formatos internacionales utilizando ponderaciones de campos configurables para estructuras de direcciones específicas de cada país.
¿Cuánto tiempo tarda en ejecutarse una tarea de resolución de entidades?
La duración depende del tamaño del conjunto de datos, la estrategia de bloqueo y el número de sistemas de origen. Una tarea de actualización completa de 1 millón de registros con dos sistemas de origen suele completarse en un plazo de entre 20 y 45 minutos en la infraestructura en la nube de Match Data Pro. Las ejecuciones incrementales sobre un grafo de entidades existente —en las que solo se procesan los registros nuevos o modificados— suelen completarse en un plazo de entre 2 y 8 minutos para conjuntos de datos de menos de 5 millones de registros.