
El software de resolución de entidades empresariales vincula registros fragmentados de sistemas aislados entre sí para crear un registro maestro verificado y sin duplicados, sin necesidad de una clave primaria compartida. La plataforma adecuada combina la coincidencia aproximada configurable, la resolución de identidades basada en grafos, las reglas de supervivencia automatizadas y un registro de auditoría completo. Esta guía abarca todas las capacidades que diferencian al software empresarial de nivel de producción de las herramientas que solo funcionan con conjuntos de datos pequeños y limpios.
Si estás en plena fase de evaluación, reserva una demostración de 30 minutos para ver cómo gestiona Match Data Pro tu modelo de datos específico.
Por qué la resolución de entidades resulta complicada a escala empresarial
El reto no consiste en encontrar duplicados evidentes, sino en identificar la misma entidad en distintos sistemas que la describen de forma diferente —sin un identificador común, con nombres de campos incoherentes y tras años de variaciones en la introducción de datos—.
Imagina esta situación real:
- Ficha de CRM: Acme Corp., 123 Main St, Chicago IL 60601, acme@acme.com
- Ficha del ERP: ACME Corporation, 123 Main Street, Chicago, Illinois, ar@acmecorp.com
- Ficha comercial: Acme, 123 Main St, local 4, Chicago (Illinois), acme-marketing@acme.com
Una unión de coincidencia exacta no arroja ningún resultado. Una consulta básica con el operador «LIKE» devuelve falsos positivos. Solo un proceso de puntuación difusa en varios campos —en el que se puntúan por separado el nombre de la empresa, la dirección y el correo electrónico, y se combinan las puntuaciones ponderadas— identifica con certeza que se trata de la misma entidad.
Si ampliamos esto a 10 millones de registros repartidos en seis sistemas de origen, el problema se vuelve muy exigente desde el punto de vista computacional. Una comparación ingenua de todos los pares entre 10 millones de registros requiere 50 billones de comparaciones. Las plataformas de coincidencia difusa de nivel de producción resuelven esto mediante estrategias de agrupación que reducen el espacio de comparación en un 99 % antes de que comience la puntuación.
Las seis capacidades que definen el software de resolución de entidades empresariales
1. Coincidencia difusa con múltiples algoritmos
No hay ningún algoritmo que gestione con precisión todos los tipos de campo. Las plataformas empresariales aplican un algoritmo diferente para cada campo:
- Nombres de empresas: Jaro-Winkler + el ratio de clasificación de tokens gestiona las abreviaturas y el reordenamiento de palabras («IBM Corp» frente a «International Business Machines»)
- Nombres propios: la codificación fonética (Metaphone 3) gestiona las variantes ortográficas («Jon» frente a «John», «Smyth» frente a «Smith»)
- Direcciones: El proceso de coincidencia de campos analizados tras la estandarización de direcciones gestiona las diferencias entre «St» y «Street», los sufijos de unidades y los códigos postales invertidos.
- Correos electrónicos: la coincidencia exacta en el dominio y la coincidencia aproximada en la parte local permiten detectar errores tipográficos (john.smth@acme.com frente a john.smith@acme.com)
- Números de teléfono: la comparación de dígitos normalizados tras eliminar el formato tiene en cuenta las variantes del prefijo «+1» y las extensiones.
Cada campo genera una puntuación de 0 a 1. Una puntuación compuesta ponderada determina el nivel de confianza final de la coincidencia. Match Data Pro te permite configurar la selección de algoritmos, las ponderaciones de los campos y los umbrales para cada proyecto, sin necesidad de programar.
2. Bloqueo e indexación para la escalabilidad
Agrupación de registros en grupos de candidatos antes de la comparación. Solo se comparan entre sí los registros que comparten una clave de agrupación —los tres primeros caracteres del nombre de la empresa, el código postal o el prefijo telefónico—. Una estrategia de agrupación bien configurada reduce el volumen de comparaciones de O(n²) a O(n log n).
Match Data Pro admite múltiples pasadas de filtrado. Un registro al que le falte una clave de filtrado (nombre de la empresa mal escrito) puede seguir coincidiendo tras una segunda pasada basada en el código postal y el número de teléfono. Este enfoque de múltiples pasadas alcanza tasas de recuperación superiores al 97 % en conjuntos de datos empresariales típicos.
3. Resolución de identidades basada en grafos
La comparación simple por pares permite identificar pares duplicados. La resolución de entidades basada en grafos identifica clústeres, es decir, grupos de registros que se refieren todos a la misma entidad del mundo real, incluso cuando ningún par concreto coincide directamente.
Ejemplo: El registro A coincide con el registro B (puntuación de 0,88). El registro B coincide con el registro C (puntuación de 0,82). El registro A y el registro C solo obtienen una puntuación de 0,61 entre sí. La resolución gráfica identifica a A, B y C como un único clúster y genera un único registro de referencia.
Match Data Pro integra el motor de resolución de entidades de Senzing para la agrupación basada en grafos. Senzing utiliza un modelo probabilístico preentrenado —sin reglas definidas manualmente— y realiza la resolución en tiempo real incluso con conjuntos de datos que contienen cientos de millones de registros.
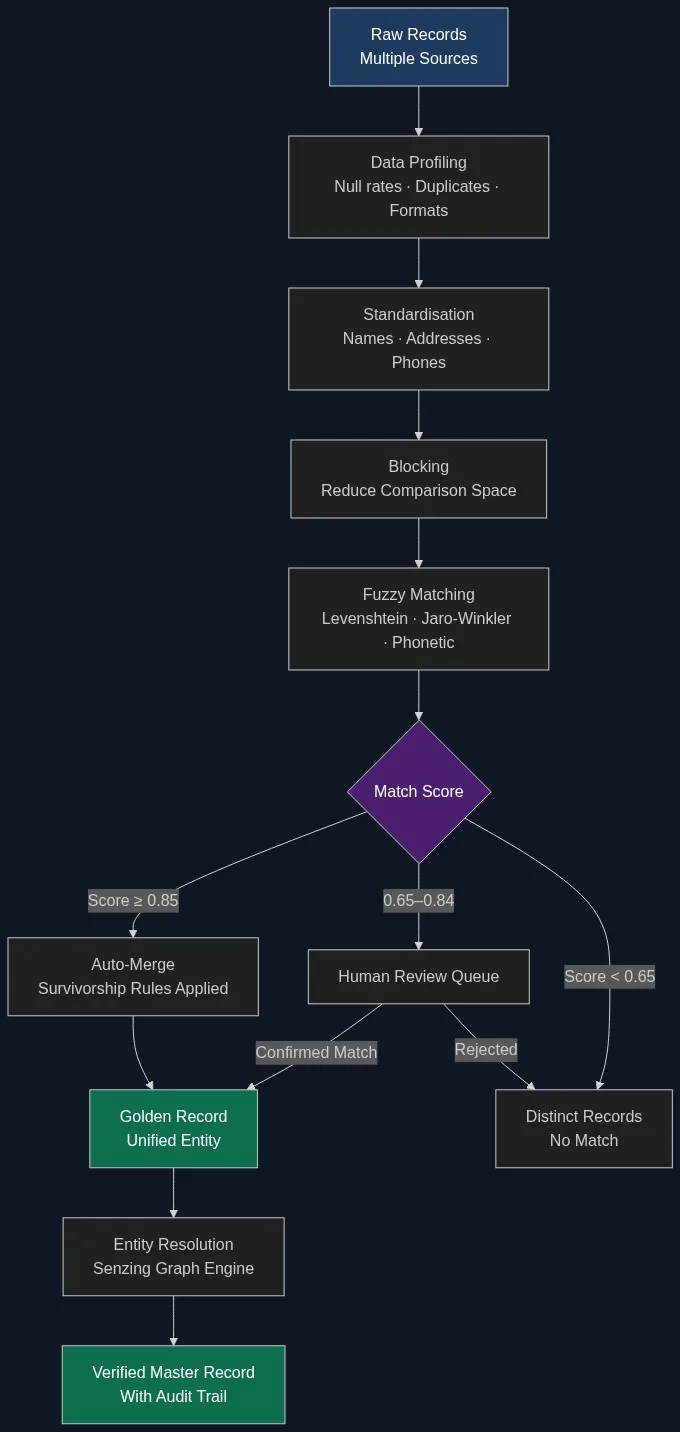
4. Reglas de supervivencia configurables
Tras identificar un grupo de coincidencias, la plataforma debe decidir qué valor de campo se mantiene en el registro de referencia. La lógica de selección resuelve los conflictos campo por campo.
Estrategias habituales de supervivencia:
- Más reciente: Utiliza el valor del campo del registro con la marca de tiempo de modificación más reciente
- El más completo: da prioridad al campo que tenga más caracteres o menos valores nulos
- Prioridad de las fuentes: la dirección del ERP prevalece sobre la del CRM; el correo electrónico del CRM prevalece sobre el de la lista de marketing
- Más frecuente: utiliza el valor que aparece en la mayoría de los registros coincidentes
Match Data Pro aplica las reglas de supervivencia a nivel de campo, no a nivel de registro, por lo que pueden aplicarse reglas diferentes a distintas columnas en una misma operación de fusión. Consulta la guía completa sobre las reglas de supervivencia y la creación del registro de referencia.
5. Registro de auditoría y explicabilidad
Cada decisión de coincidencia —por qué se han vinculado dos registros, qué algoritmo ha generado la puntuación, qué umbral se ha aplicado— debe quedar registrada y ser susceptible de revisión. Esto no es opcional en los sectores regulados. Además, es esencial para corregir los falsos positivos que afectan a los sistemas posteriores.
Match Data Pro registra el historial completo de decisiones para cada par de partidos: puntuaciones por campo, puntuación global, umbral aplicado, resultado de la selección y operador que revisó los pares dudosos. El registro de auditoría se puede exportar a CSV o conectarse a través de una API a plataformas de gobernanza de datos.
Los equipos que gestionan procesos de resolución de entidades mediante agentes necesitan, sobre todo, que estas sean explicables: cuando un agente automatizado resuelve miles de registros por minuto, los revisores humanos deben poder auditar cualquier decisión a posteriori.
6. Automatización de tareas escalable y conectores
La resolución de entidades empresariales no es un proyecto puntual. Cada día llegan nuevos registros. Los datos de las adquisiciones deben procesarse de forma periódica. Las sincronizaciones del CRM generan nuevos duplicados cada semana.
Compatibilidad con plataformas de producción:
- Tareas por lotes programadas (diarias, semanales o activadas por la llegada de archivos)
- Comparación de API en tiempo real para la deduplicación en el punto de entrada
- Conectores de importación para Salesforce, HubSpot, bases de datos SQL, archivos planos y almacenamiento en la nube
- Exportar conectores para reenviar los registros de referencia a los sistemas de origen
La capa de automatización de tareas de Match Data Pro se encarga de las cuatro cosas. Basta con configurar una tarea una sola vez —datos de entrada, reglas de correspondencia, lógica de selección y destino de salida— y esta se ejecuta según lo programado sin necesidad de intervención manual. En combinación con la API de búsqueda difusa en tiempo real, los equipos pueden bloquear los duplicados en el momento de la entrada y, al mismo tiempo, limpiar por lotes los registros históricos.
Criterios de evaluación: qué hay que comprobar antes de comprar
Una demostración del proveedor con un conjunto de datos limpio no constituye una prueba de concepto. Antes de comprometerte, realiza una evaluación estructurada con tus propios datos.
Precisión y recuperación en tu conjunto de datos
La precisión mide cuántos pares coincidentes son correctos. La recuperación mide cuántas coincidencias reales ha encontrado el sistema. Objetivos de la empresa: precisión superior al 95 % y recuperación superior al 90 %. Realiza la prueba con una muestra etiquetada de entre 5.000 y 10.000 pares de registros procedentes de tus propios datos, no de los datos de demostración del proveedor.
Configurabilidad de los umbrales
Se necesitan umbrales distintos para la fusión automática (alta confianza), la revisión manual (casos dudosos) y el rechazo automático (baja confianza). Si la plataforma solo ofrece un único umbral global, o bien fusionará demasiados datos o bien generará una cola de revisión demasiado larga. Match Data Pro permite configurar tres umbrales distintos por proyecto.
Velocidad de procesamiento a gran escala
Pide datos de referencia sobre conjuntos de datos de un tamaño comparable al tuyo. Una plataforma que procesa un millón de registros en cuatro horas no puede soportar ejecuciones incrementales diarias en una base de datos de 50 millones de registros. Match Data Pro procesa 10 millones de registros en menos de dos horas en una infraestructura estándar en la nube.
Integración de la elaboración de perfiles de datos
El proceso de emparejamiento comienza antes del emparejamiento propiamente dicho. El análisis de perfiles de datos mediante IA identifica las tasas de valores nulos, las inconsistencias de formato y las distribuciones de valores antes de que se lleven a cabo los procesos de estandarización. Los equipos que se saltan el análisis de perfiles observan sistemáticamente una reducción del 15-25 % en la tasa de recuperación, ya que los campos no estandarizados generan puntuaciones de similitud artificialmente bajas.
Cómo Match Data Pro ofrece resolución de entidades para empresas
Match Data Pro es una plataforma SaaS en la nube sin contrato a largo plazo. El proceso completo abarca la elaboración de perfiles de datos, la limpieza, la estandarización, la coincidencia aproximada basada en inteligencia artificial, la resolución de entidades con tecnología de Senzing, la selección de registros y la creación de registros de referencia, la verificación de direcciones mediante CASS y la automatización de tareas, todo ello en una única plataforma configurable.
La puesta en marcha es inmediata. Conecta tus fuentes de datos mediante conectores de importación, configura tus reglas de coincidencia y umbrales, realiza un proceso de perfilado y ejecuta tu primera tarea. La mayoría de los equipos completan su primera ejecución de resolución de entidades en un plazo de 48 horas tras registrarse.
Para los equipos que están valorando las opciones de «desarrollar o adquirir», los aspectos económicos están claros: un desarrollo a medida cuesta entre 500.000 y 1,5 millones de dólares a lo largo de tres años y tarda entre 6 y 18 meses en resolver el primer registro. Match Data Pro resuelve los registros en cuestión de horas.
El motor de vinculación de registros gestiona casos en los que no hay ningún identificador común, realizando la coincidencia únicamente a partir de puntuaciones difusas combinadas de los campos de nombre, dirección, teléfono y correo electrónico. Esto permite la resolución de entidades entre sistemas, incluso cuando los sistemas heredados asignaban sus propios identificadores internos sin solapamiento alguno.
Empieza una prueba gratuita: members.matchdatapro.com/en/register — sin contrato, sin cuota de alta, acceso completo a la plataforma.
Preguntas frecuentes
¿Qué es el software de resolución de entidades empresariales?
El software de resolución de entidades empresariales identifica los registros de múltiples sistemas que hacen referencia a la misma entidad del mundo real —una persona, una empresa o una ubicación— y los fusiona en un registro maestro verificado. Utiliza la coincidencia aproximada, la puntuación probabilística, la agrupación en grafos y las reglas de supervivencia para gestionar las inconsistencias de los datos a gran escala sin necesidad de revisar manualmente cada par.
¿En qué se diferencia la resolución de entidades de la deduplicación?
La deduplicación elimina los registros duplicados dentro de un mismo conjunto de datos. La resolución de entidades vincula registros de varios conjuntos de datos que pueden no compartir ningún identificador, unificando así grupos de registros procedentes de diferentes sistemas de origen en una única entidad. La mayoría de los flujos de trabajo empresariales necesitan ambas cosas: deduplicación dentro de cada fuente y, a continuación, resolución de entidades entre las distintas fuentes.
¿Qué umbral de coincidencia debo utilizar para la fusión automática?
La mayoría de los equipos empresariales establecen umbrales de fusión automática entre 0,85 y 0,92, en función de la calidad de los campos y la tolerancia al riesgo. Los registros con una puntuación de entre 0,65 y 0,84 pasan a una cola de revisión manual. Por lo general, los valores inferiores a 0,65 se consideran «sin coincidencia». Calibra los umbrales revisando una muestra etiquetada de tus propios datos; los valores predeterminados de los proveedores rara vez se ajustan sin modificaciones.
¿Puede el software de resolución de entidades gestionar datos internacionales?
Sí, las plataformas de nivel de producción gestionan variantes de nombres internacionales, conjuntos de caracteres no latinos, formatos de direcciones internacionales y estructuras de números de teléfono específicas de cada país. Match Data Pro admite la estandarización de direcciones internacionales y aplica algoritmos de búsqueda aproximada que tienen en cuenta la configuración regional para nombres en los conjuntos de caracteres latinos, cirílicos y CJK.
¿Cuánto tiempo se tarda en configurar la resolución de entidades en un nuevo conjunto de datos?
Con una plataforma SaaS en la nube como Match Data Pro, la configuración inicial lleva entre 24 y 48 horas: conecta tu fuente de datos, ejecuta un análisis de perfiles para evaluar la calidad de los campos, configura las reglas de correspondencia y los umbrales, y ejecuta tu primera tarea. El ajuste de los umbrales en función de los resultados iniciales suele llevar entre 1 y 2 días más.