
El mejor software de coincidencia aproximada para equipos de datos combina algoritmos configurables, puntuación ponderada en varios campos y deduplicación automatizada en una única plataforma. Match Data Pro ofrece todo esto en una implementación SaaS en la nube, sin contrato a largo plazo y con una prueba gratuita disponible en members.matchdatapro.com. Esta guía explica qué aspectos hay que evaluar, qué funcionalidades son las más importantes y cómo llevar a cabo una prueba de concepto antes de comprometerse.
¿Estás listo para verlo en acción? Empieza una prueba gratuita y carga tus propios datos en cuestión de minutos.
Qué hace realmente un software de búsqueda aproximada
El software de coincidencia aproximada identifica los registros que se refieren a la misma entidad del mundo real, incluso cuando los datos se escriben de forma diferente, se abrevian o se introducen de manera inconsistente. Un cliente registrado como «Jon Smith» en un sistema y como «Jonathan R. Smith» en otro no comparte ninguna clave común. La coincidencia exacta no arroja ningún resultado. La coincidencia aproximada evalúa el grado de similitud y muestra el par para fusionarlo o vincularlo.
La tarea principal consiste en calcular la puntuación de similitud en varios campos de forma simultánea. La plataforma asigna una ponderación a cada campo de forma independiente —el nombre podría tener una ponderación de 0,40, la empresa de 0,25, la dirección de 0,20 y el teléfono de 0,15— y, a continuación, suma las puntuaciones ponderadas para obtener una puntuación de coincidencia global comprendida entre 0 y 1. Los registros que superan un umbral configurado se fusionan automáticamente. Los registros que se encuentran en un rango de revisión pasan a una cola de revisión manual. Los registros que están por debajo del límite inferior no se emparejan.
Por qué las herramientas basadas en un único algoritmo se quedan cortas
No hay ningún algoritmo que gestione bien todos los tipos de datos. La distancia de edición de Levenshtein funciona para cadenas cortas con errores ortográficos —«Smyth» frente a «Smith» da una puntuación de 0,83—. Sin embargo, falla en el caso de nombres de empresas con palabras invertidas: «Global Tech Corp» frente a «Corp Global Tech» da una puntuación de 0,44, aunque los registros sean idénticos. Los algoritmos basados en tokens gestionan ese caso correctamente. Una herramienta de coincidencia aproximada lista para producción utiliza varios algoritmos por campo y selecciona el que ofrece el mejor resultado en función del tipo de campo.
Descubre más sobre cómo se comportan los distintos algoritmos en nuestra guía sobre el funcionamiento de los algoritmos de coincidencia aproximada y cuándo utilizar cada uno de ellos.
Las siete funciones que diferencian las herramientas empresariales de las utilidades básicas
Evaluar el software de coincidencia difusa basándose únicamente en las listas de características pasa por alto los aspectos de ingeniería que marcan la diferencia a gran escala. Estas siete capacidades determinan si una plataforma es capaz de gestionar datos empresariales del mundo real o si se colapsa ante ellos.
1. Puntuación de campo mediante múltiples algoritmos
La plataforma debe aplicar automáticamente diferentes algoritmos a los distintos campos. Los nombres requieren el método Jaro-Winkler o Double Metaphone. Las direcciones requieren la superposición de tokens más la verificación CASS. Los números de teléfono requieren la normalización numérica más la comparación exacta. Si se aplica un único algoritmo a todos los campos, se producen demasiados falsos positivos en los campos de nombre y demasiados falsos negativos en los campos de dirección.
2. Bloqueo configurable
El bloqueo reduce el espacio de pares candidatos antes de que comience la puntuación. Sin bloqueo, comparar un millón de registros con otro millón de registros generaría un billón de comparaciones, lo cual es computacionalmente imposible. El bloqueo agrupa los registros en función de un atributo común (los tres primeros caracteres del apellido, el código postal o el código sectorial), de modo que el motor solo puntúa los pares plausibles. La estrategia de bloqueo controla directamente la recuperación: si es demasiado agresiva, se pierden coincidencias; si es demasiado laxa, la tarea nunca termina.
3. Configuración de umbrales con una banda de revisión
Las buenas plataformas ofrecen tres parámetros de umbral: fusión automática por encima de X, revisión humana entre X e Y, y rechazo por debajo de Y. Los equipos establecen estos valores en función de su tolerancia a los falsos positivos frente a los falsos negativos. Un equipo de servicios financieros que no tolera ninguna fusión errónea establece un umbral alto para la fusión automática y deriva más pares a revisión. Un equipo de marketing que busca optimizar la cobertura establece un umbral más bajo y acepta una limpieza manual ocasional. Los umbrales estáticos sin margen de revisión son señal de una plataforma inmadura.
4. Normas de supervivencia y generación del «registro de oro»
La comparación sin fusión es incompleta. Una vez identificados los duplicados, la plataforma debe aplicar reglas de supervivencia para decidir qué valores de campo se mantienen en el registro de referencia fusionado. Reglas habituales: prevalece el valor más reciente, prevalece el más completo, prevalece la fuente más fiable. El motor de supervivencia y de registros de referencia de Match Data Pro admite estos tres tipos de reglas, la configuración por campo y el marcado de conflictos para su revisión manual.
5. Acceso a la API para la comparación en tiempo real
La deduplicación por lotes limpia los conjuntos de datos existentes. Sin embargo, cada día llegan nuevos registros. Una plataforma que no cuente con una API de comparación en tiempo real implica que cada nueva entrada en el CRM elude la lógica de deduplicación hasta la siguiente ejecución por lotes. La API REST de Match Data Pro acepta un único registro como solicitud POST, lo compara con el conjunto de datos existente y devuelve los candidatos a coincidencia con sus puntuaciones en milisegundos. Esto permite la deduplicación en el punto de entrada en los formularios del CRM, los procesos de importación y los flujos de webhooks.
6. Elaboración de perfiles de datos antes de la comparación
La aplicación de la coincidencia aproximada a datos sin perfilar genera resultados poco fiables. Si el 30 % de un campo de nombre contiene nombres de empresas —un error habitual en la introducción de datos en los sistemas CRM—, el motor de coincidencia generará falsos positivos a gran escala. La perfilación de datos mediante IA analiza cada campo en busca de valores nulos, errores de formato, distribuciones de valores y entradas sospechosas antes de que se ejecute la tarea de coincidencia. Los resultados de la perfilación influyen directamente en la selección del algoritmo y en la calibración de los umbrales.
7. Automatización y programación de tareas
Los datos empresariales no son estáticos. Cada día llegan nuevos registros procedentes del CRM, el ERP, fuentes de enriquecimiento de terceros y archivos de importación. La coincidencia aproximada debe ejecutarse según una programación: cada noche, cada semana o activada por eventos de ingesta. Las plataformas que carecen de automatización de tareas requieren que un ingeniero de datos active manualmente cada ejecución. La capa de automatización de tareas de Match Data Pro programa cualquier flujo de trabajo de coincidencia, envía alertas al completarse o fallar, y mantiene un historial completo de ejecuciones para la auditoría de gobernanza.
Proceso de coincidencia aproximada: cómo funciona de principio a fin
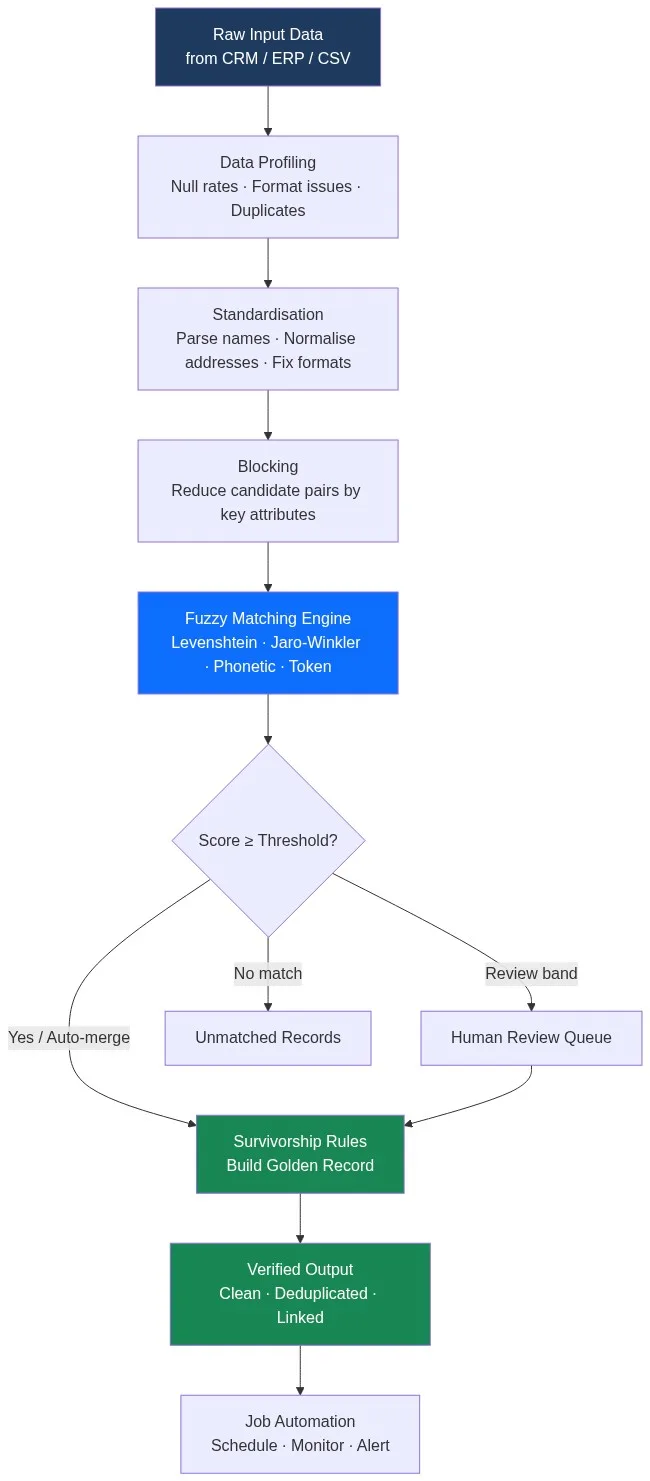
El siguiente diagrama muestra el proceso completo de coincidencia difusa, desde los datos de entrada sin procesar hasta los resultados verificados y deduplicados, pasando por la programación automática.
Casos de uso de la búsqueda aproximada por equipo
Equipos de CRM y RevOps
El caso de uso más habitual: registros de clientes duplicados en las plataformas de CRM, automatización de marketing y atención al cliente. Un equipo de RevOps de una empresa de SaaS del segmento medio suele encontrar una tasa de duplicados del 8 al 15 % en Salesforce tras dos años de crecimiento. La deduplicación del CRM mediante la coincidencia aproximada en los campos de nombre, correo electrónico, empresa y teléfono consolida la base de datos, mejora la precisión en la asignación de territorios y elimina los recuentos inflados del pipeline de los informes de ventas.
Ingenieros de datos y equipos de integración
La integración tras una fusión, las migraciones de ERP y la ingesta de datos en un «data lake» requieren la vinculación de registros entre conjuntos de datos que no comparten ningún identificador común. Un ingeniero de datos que cargue tres bases de datos de clientes en un almacén unificado debe detectar que «Acme Corp» en el sistema A, «ACME Corporation» en el sistema B y «Acme» en el sistema C son la misma entidad. La vinculación de registros sin un identificador compartido requiere una puntuación difusa basada simultáneamente en los atributos de nombre, dirección y empresa.
Equipos de servicios financieros y de cumplimiento normativo
La verificación de identidad (KYC), el control contra el blanqueo de capitales (AML) y la comparación con listas de sanciones dependen, en su totalidad, de la precisión en la coincidencia de nombres. Una contraparte registrada como «Mohammed Al-Rashid» debe coincidir con «Mohamed Alrashid» en una lista de vigilancia. La sustitución de caracteres, las variantes de transliteración y la ausencia de signos diacríticos requieren algoritmos fonéticos y una comparación basada en tokens, además de la distancia de edición estándar. La resolución de entidades en los servicios financieros aplica estas técnicas con un registro de auditoría completo para la presentación de informes reglamentarios.
Equipos de TI del sector sanitario
La correspondencia de pacientes entre los sistemas de historias clínicas electrónicas (HCE), farmacia, laboratorio y reclamaciones tiene consecuencias clínicas directas. Una correspondencia omitida implica que el profesional sanitario vea un historial incompleto. Una correspondencia errónea fusiona los historiales de dos pacientes. El proceso de correspondencia debe equilibrar cuidadosamente la precisión y la recuperación, y cada decisión de correspondencia debe quedar registrada. La resolución de entidades en el ámbito sanitario mediante Match Data Pro utiliza el motor probabilístico basado en grafos de Senzing para la vinculación de pacientes con calidad clínica.
Cómo llevar a cabo una prueba de concepto
Una prueba de concepto con tus propios datos es el único método fiable para evaluar un software de coincidencia aproximada. Sigue este procedimiento de cuatro pasos:
Paso 1: Extrae una muestra representativa. Selecciona entre 50 000 y 100 000 registros de tu conjunto de datos de producción. Incluye registros que sepas que son duplicados (positivos de referencia) y registros que sepas que no lo son (negativos de referencia). Un mínimo de 500 pares conocidos en cada categoría proporciona medidas de precisión y recuperación estadísticamente significativas.
Paso 2: Realiza primero el análisis de perfiles. Sube la muestra, ejecuta el análisis de perfiles de datos y revisa el informe de calidad de los campos. De este modo se identifica qué campos son lo suficientemente fiables como para utilizarlos como atributos de coincidencia y cuáles deben estandarizarse antes de la puntuación. Si se omite este paso, los resultados de la prueba de concepto (POC) pueden ser engañosos.
Paso 3: Configura los umbrales de forma iterativa. Empieza con las ponderaciones y los umbrales predeterminados. Revisa los pares puntuados. Ajusta las ponderaciones de los campos y los umbrales en función de los patrones de falsos positivos y falsos negativos que observes. Lo habitual es realizar entre tres y cinco iteraciones antes de alcanzar una configuración estable con una precisión y un recuerdo superiores al 90 % en tu conjunto de referencia.
Paso 4: Mide, no te limites a inspeccionar. Calcula la precisión (¿de los pares fusionados automáticamente, qué porcentaje eran coincidencias correctas?) y la recuperación (¿de todas las coincidencias verdaderas conocidas, qué porcentaje encontró el motor?). Una configuración lista para producción debería alcanzar, como mínimo, un 92 % de precisión y un 88 % de recuperación en una muestra representativa.
Reserva una demostración guiada y nuestro equipo te guiará paso a paso por una prueba de concepto con tus datos.
La plataforma Match Data Pro
Match Data Pro es una plataforma SaaS de calidad de datos en la nube que abarca todo el proceso: perfilado de datos mediante IA, limpieza y estandarización de datos, comparación difusa, deduplicación, resolución de entidades a través de Senzing, verificación de direcciones CASS, conectores de importación/exportación y automatización de tareas. Se puede acceder a todas las funciones a través de la interfaz de usuario, de la API REST o de tareas programadas; no hay que gestionar ninguna infraestructura ni se requiere ningún contrato a largo plazo.
El motor de coincidencia aproximada de la plataforma es compatible con la distancia de edición de Levenshtein, Jaro-Winkler, Double Metaphone, Soundex y algoritmos basados en tokens. Cada campo de una regla de coincidencia puede utilizar un algoritmo diferente con una configuración independiente de ponderación y umbral. La cola de revisión muestra los pares dudosos con un desglose de puntuaciones por campo, de modo que los revisores comprendan exactamente por qué el motor ha marcado cada par.
Los equipos que están valorando pasar de una deduplicación manual basada en hojas de cálculo o de una comparación basada en procesos ETL heredados suelen completar su primera ejecución limpia en el plazo de un día laborable desde el momento de registrarse. Regístrate ahora y empieza una prueba gratuita; no es necesario facilitar datos de tarjeta de crédito.
Preguntas frecuentes
¿Para qué se utiliza el software de búsqueda aproximada?
El software de coincidencia aproximada identifica registros que se refieren a la misma entidad del mundo real a pesar de las variaciones ortográficas, las abreviaturas o los errores en la introducción de datos. Entre los casos de uso más habituales se incluyen la deduplicación de datos en sistemas CRM, la consolidación de bases de datos tras una fusión, la comparación de historiales de pacientes en el sector sanitario, la verificación de nombres para el cumplimiento de las normas KYC y AML en los servicios financieros, y la vinculación de registros en la migración de datos de sistemas ERP. Se utiliza en cualquier situación en la que sea necesario vincular dos conjuntos de datos sin un identificador único compartido.
¿Qué grado de precisión tiene el software de búsqueda aproximada?
La precisión depende en gran medida de la calidad de los datos y de la configuración. Una coincidencia difusa bien configurada sobre datos limpios y estandarizados suele alcanzar una precisión del 92-96 % y un recuerdo del 88-94 %. En el caso de datos sin procesar y no estandarizados, la precisión puede descender hasta el 70-80 % si no se lleva a cabo un perfilado y una estandarización como paso previo al procesamiento. Realizar un perfilado de los datos antes de la coincidencia y ajustar los umbrales de forma iterativa sobre una muestra de referencia es la vía más rápida para obtener una precisión fiable.
¿Qué algoritmos utilizan las herramientas empresariales de coincidencia difusa?
Las herramientas empresariales de coincidencia difusa utilizan una combinación de algoritmos que se aplican según el tipo de campo. La distancia de edición de Levenshtein gestiona cadenas cortas con errores ortográficos. El algoritmo de Jaro-Winkler está optimizado para campos de nombres en los que son habituales las transposiciones. Double Metaphone y Soundex comparan nombres fonéticamente similares. Los algoritmos basados en tokens gestionan las variaciones en el orden de las palabras en los nombres de empresas y las direcciones. Las plataformas de producción combinan todo ello con ponderaciones de campos configurables para generar una puntuación de coincidencia compuesta.
¿Puede un software de coincidencia aproximada gestionar la deduplicación en tiempo real?
Sí, las plataformas que ofrecen una API REST pueden realizar la deduplicación en tiempo real en el momento de la introducción de datos. Un formulario de CRM envía un nuevo registro de contacto a la API, que lo compara con el conjunto de datos existente y devuelve posibles coincidencias antes de que se guarde el registro. De este modo, se evita que se introduzcan nuevos duplicados en el sistema, en lugar de eliminarlos posteriormente mediante una ejecución por lotes. La API de búsqueda aproximada en tiempo real de Match Data Pro es compatible con este modelo.
¿Cuánto tiempo lleva implementar la búsqueda aproximada?
Con una plataforma SaaS en la nube y un conjunto de datos preparado, una primera ejecución de emparejamiento suele tardar entre uno y tres días laborables desde el registro hasta la obtención de los resultados. Esto incluye la carga de datos, la creación de perfiles, la configuración del algoritmo, el ajuste de los umbrales y la revisión de los resultados puntuados. Las implementaciones de mayor envergadura, con emparejamientos complejos de registros procedentes de múltiples fuentes y reglas de supervivencia personalizadas, tardan entre dos y cuatro semanas. Las implementaciones locales tardan más debido al aprovisionamiento de la infraestructura.