
Es posible hacer coincidir registros de varios sistemas sin necesidad de un identificador común mediante un proceso de cinco etapas: definir el perfil de cada fuente, estandarizar los campos, generar pares de candidatos mediante el método de «blocking», puntuarlos con un motor ponderado que utiliza varios algoritmos y aplicar reglas de supervivencia para obtener un único registro de referencia. No se requiere un identificador universal de cliente. El proceso funciona tanto si se dispone de dos sistemas de origen como de veinte.
¿Estás listo para verlo en acción? Empieza tu prueba gratuita de Match Data Pro y conecta tus dos primeros sistemas de origen en cuestión de minutos.
Por qué la ausencia de un identificador común es el problema fundamental
La mayoría de las organizaciones tienen datos almacenados en al menos tres lugares: un CRM, un ERP y una plataforma de automatización de marketing. Cada sistema asigna su propio identificador interno a cada registro de cliente, contacto o proveedor. El identificador CRM 10045 corresponde a la misma persona que el identificador ERP VND-882 y el registro de marketing MKT-CX-2201. Sin embargo, los datos sin procesar no lo indican en ningún momento.
El resultado: los informes posteriores contabilizan dos veces los ingresos, los equipos de ventas llaman tres veces al mismo cliente potencial y los equipos de cumplimiento normativo no pueden elaborar un informe de acceso de datos sin errores. Según un estudio de Gartner, la mala calidad de los datos supone a las organizaciones un coste medio de 12,9 millones de dólares al año. La duplicación entre sistemas es uno de los principales factores que contribuyen a ello.
La solución habitual —asignar manualmente un identificador universal— no funciona a gran escala. Cuando un sistema tiene 400 000 registros y otro 600 000, no es viable realizar la cotejo manualmente. Se necesita un proceso de cotejo que se base en el contenido de los propios registros: nombre, dirección, teléfono, correo electrónico y cualquier combinación de esos campos.
Fase 1: Analiza cada fuente antes de establecer ninguna correspondencia
No empieces a realizar la comparación con datos sin procesar. Primero, aplica un análisis de perfil de datos mediante IA a cada sistema de origen. Este análisis revela las tasas de valores nulos, las inconsistencias de formato y las distribuciones de valores antes de que afecten negativamente a tus puntuaciones de coincidencia.
Una sesión típica de análisis de rendimiento pondrá de manifiesto problemas como estos:
| Campo | Sistema A (CRM) | Sistema B (ERP) | Problema |
|---|---|---|---|
| Teléfono | +1 (602) 555-0198 | 6025550198 | Incompatibilidad de formato: ambas son válidas |
| Nombre de empresa | Acme Corp. | ACME CORPORATION | Divergencia entre mayúsculas y minúsculas y abreviaturas |
| DIRECCIÓN | 123 W Main St | Calle Main Oeste, 123, local 4 | Incoherencia entre la abreviatura y el sufijo de la unidad |
| Nombre | Bob | Robert | Apodo frente a nombre oficial |
Cada de las discrepancias anteriores obtendría una puntuación de 0 en una comparación ingenua basada en la coincidencia exacta. Tras realizar el análisis de perfiles, sabrás exactamente qué pasos de estandarización son necesarios antes de que comience la puntuación.
Fase 2: Estandarizar los campos en todas las fuentes
La estandarización adapta cada campo a un formato canónico antes de la comparación. Aquí es donde fracasan la mayoría de los intentos de emparejamiento desarrollados internamente: se saltan la estandarización y luego se preguntan por qué los índices de coincidencia son bajos.
Estandarización de nombres
Aplica estas transformaciones antes de puntuar los nombres:
- Escribir todos los valores en mayúsculas o minúsculas de forma coherente
- Despliega las abreviaturas más comunes: Corp. → Corporación, St. → Calle
- Eliminar signos de puntuación: puntos, comas y signos «&»
- Normalizar las variantes de los apodos: Bob → Robert, Liz → Elizabeth (mediante una tabla de correspondencias)
- Analizar los sufijos de las empresas como tokens independientes: LLC, Inc., Ltd.
Estandarización de los teléfonos
Elimina todos los caracteres de formato y reduce el número a 10 dígitos para llamadas nacionales (o al formato E.164 para llamadas internacionales). +1 (602) 555-0198 y 6025550198 se convierten en 6025550198 — son idénticos. Ahora es posible obtener una coincidencia exacta en el número de teléfono sin necesidad de una puntuación aproximada.
Estandarización de direcciones
Realiza una verificación de direcciones certificada por CASS en todos los registros postales. El análisis CASS descompone cada dirección en número de calle, nombre de la calle, dirección (o orientación), tipo de unidad, número de unidad, ciudad, estado y ZIP+4. De este modo, podrás comparar los componentes analizados en lugar de cadenas de texto sin procesar. «123 W Main St» y «123 West Main Street, Ste 4» comparten el número de calle 123, el nombre de la calle MAIN y la dirección WEST: una coincidencia parcial muy sólida, incluso sin que las cadenas de caracteres sean idénticas.
El motor de limpieza y estandarización de datos de Match Data Pro aplica todas estas transformaciones como un paso configurable previo a la comparación, procesando millones de registros sin necesidad de scripts personalizados.
Etapa 3: Bloqueo — Reducir el espacio de candidatos sin omitir coincidencias
No es posible comparar cada registro del sistema A con cada registro del sistema B. Con 400 000 registros en A y 600 000 en B, una unión cruzada simple genera 240 000 millones de pares. Esto resulta inviable desde el punto de vista computacional.
El bloqueo (también denominado «indexación» o «agrupación en compartimentos») reduce el número de pares candidatos a un conjunto manejable, comparando únicamente los registros que comparten al menos una clave de bloqueo. Entre las estrategias de bloqueo más habituales se incluyen:
- Dominio de correo electrónico exacto: comparar únicamente los registros del mismo @dominio
- Clave fonética Soundex o NYSIIS: agrupa los registros cuyos nombres suenan de forma similar (detecta JOHNSON / JONSON / JOHNSTON)
- Prefijo del código postal: comparar únicamente los registros que tengan el mismo prefijo de tres dígitos del código postal
- Los tres primeros caracteres del nombre de la empresa: reducen el número de candidatos en aproximadamente un 97 %, al tiempo que captan la mayoría de las variantes abreviadas.
- Prefijo telefónico: agrupar por código de área + los tres primeros dígitos
Utiliza varias pasadas de bloqueo (bloqueo multipaso) y toma la unión de los candidatos de cada pasada. De este modo, se garantiza que un registro que se haya pasado por alto en una clave de bloqueo sea detectado por otra. Una estrategia de bloqueo bien diseñada reduce los pares de candidatos en un 99,5 % o más, al tiempo que pasa por alto menos del 1 % de las coincidencias reales.
Fase 4: Puntuación mediante múltiples algoritmos en distintos ámbitos
Cada par de candidatos recibe ahora una puntuación de coincidencia global calculada a partir de las puntuaciones de similitud de cada campo. El motor de puntuación multialgorítmico de Match Data Pro aplica diferentes algoritmos a los distintos tipos de campos, ya que ningún algoritmo funciona igual de bien con los nombres, las direcciones y los campos de texto libre.
A continuación se muestra un ejemplo de puntuación detallada para un par de candidatos:
| Campo | Valor del sistema A | Valor del sistema B | Algoritmo | Puntuación | Peso |
|---|---|---|---|---|---|
| Nombre | Bob | Robert | Tabla de apodos | 1.00 | 0.15 |
| Apellido | Andersen | Anderson | Jaro-Winkler | 0.97 | 0.20 |
| Empresa | Acme Corp | ACME CORPORATION | Proporción del conjunto de fichas | 0.95 | 0.25 |
| Teléfono | 6025550198 | 6025550198 | Exacto | 1.00 | 0.25 |
| Código postal | 85001 | 85001-4230 | Coincidencia de prefijo | 1.00 | 0.15 |
| Puntuación global | 0.979 | ||||
Una puntuación de 0,979 supera cualquier umbral razonable para la vinculación automática (normalmente, 0,85 o más). Estos dos registros corresponden a la misma persona, a pesar de que el formato del nombre de pila, la grafía del apellido y el formato del nombre de la empresa son diferentes, y de que en uno de los sistemas aparece un ZIP+4.
Para obtener más información sobre cómo gestiona cada algoritmo determinados tipos de campos, consulta nuestra guía sobre el funcionamiento de los algoritmos de coincidencia aproximada.
Enrutamiento por umbral
No todos los pares deben vincularse automáticamente. Asigna los pares en función de la puntuación compuesta:
- Puntuación ≥ 0,85: enlace automático — alta fiabilidad, no se requiere revisión humana
- 0,65 – 0,84: cola de revisión — enviar a un evaluador humano para que decida si hay coincidencia o no
- Score < 0.65: no match — records remain separate
Al principio, establece los umbrales de forma conservadora. Siempre podrás reducir el umbral de enlace automático una vez que hayas comprobado la precisión del motor con una muestra de tus datos.
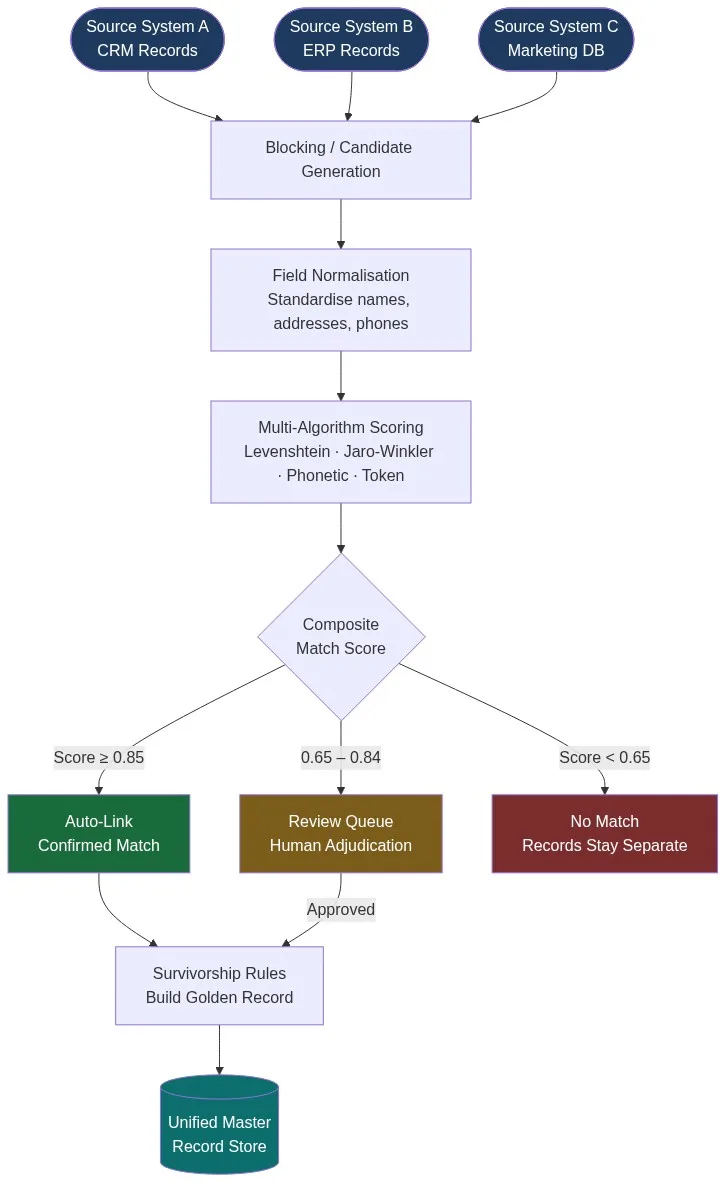
Etapa 5: Normas de supervivencia y creación del «Golden Record»
Una vez que se haya confirmado que los pares coinciden, debes decidir qué valores de los campos se van a conservar en el registro unificado. A esto se le denomina «supervivencia». Dos registros coincidentes pueden tener valores diferentes para el mismo campo: ¿cuál prevalece?
Normas generales sobre la supervivencia:
- Más reciente: toma el valor del último registro actualizado
- Más completo: se da preferencia al valor no nulo; si ambos son no nulos, se da preferencia al más extenso o al más detallado
- Prioridad de la fuente: designar un sistema de referencia fiable para cada tipo de campo (el ERP tiene prioridad para la dirección de facturación; el CRM, para el nombre del contacto)
- Indicador de verificación: dar prioridad a los valores que hayan sido validados explícitamente (dirección verificada por CASS, registro confirmado por correo electrónico)
El motor de fusión de datos y de selección de registros de Match Data Pro te permite configurar reglas a nivel de campo para cada sistema de origen sin necesidad de escribir código. El resultado es un «registro de referencia»: la única representación oficial de cada entidad del mundo real en todos tus sistemas de origen.
Para los equipos que se enfrentan a tareas complejas de resolución de entidades en múltiples sistemas, Match Data Pro también integra la resolución de entidades de Senzing, un motor basado en grafos que gestiona las coincidencias transitivas (A = B, B = C, por lo tanto A = C) y evoluciona a medida que se incorporan nuevos registros.
Cómo gestionar los casos extremos que interrumpen los flujos de trabajo sencillos
Un proceso de conciliación entre sistemas en entorno de producción se encuentra con casos extremos que nunca salen a la luz en una prueba de concepto.
Dígitos invertidos en los números de teléfono
602-555-0198 frente a 602-555-0189: una simple permutación de un dígito. La comparación exacta falla. La distancia de Levenshtein de 2 en una cadena de 10 caracteres da una puntuación de alrededor de 0,80, lo cual es suficiente para que se envíe a la cola de revisión en lugar de crearse un enlace automático. Si a esto le sumamos una puntuación alta del nombre, el resultado combinado sigue superando el umbral.
Sufijos de número de apartamento en las direcciones
«123 Main St» frente a «123 Main St, Suite 400»: mismo edificio, diferente unidad. Analiza el identificador de la unidad por separado y puntúalo de forma independiente. Si falta la unidad en un sistema, se puntúa como «neutral» (0,5) en lugar de como «falta grave» (0,0). De este modo se evitan los falsos negativos en el caso de los clientes que han facilitado su dirección con distintos niveles de detalle en los distintos sistemas.
Variantes legales de la denominación social
«Smith & Sons» frente a «Smith and Sons LLC»: una divergencia habitual entre los sistemas ERP y CRM. La comparación de la proporción de conjuntos de tokens resuelve bien este problema: compara la intersección de los tokens en lugar de las cadenas completas, y considera que «SMITH» y «SONS» coinciden perfectamente, independientemente de la palabra de enlace y del sufijo.
Orden de los nombres a nivel internacional
En los formatos de nombres de Asia Oriental, el apellido va primero: «Li Wei» en el CRM puede aparecer como «Wei Li» en el ERP si un operador occidental ha introducido los datos en uno de los sistemas. Un analizador de nombres que reconozca los códigos de país e invierta el orden de los campos antes de la evaluación detecta por completo este tipo de discrepancias.
Las reglas de coincidencia configurables de Match Data Pro te permiten definir asignaciones de algoritmos específicas para cada campo, ponderaciones y excepciones para casos extremos a través de la interfaz de usuario, sin necesidad de escribir código.
Puesta en marcha del proceso: emparejamiento por lotes frente a emparejamiento continuo
La vinculación de registros entre sistemas no es un proyecto puntual. Cada día llegan nuevos registros a cada sistema de origen. Es necesario contar con una estrategia para mantener actualizados los registros vinculados.
Coincidencia por lotes
Ejecuta una ronda completa de cotejo con una periodicidad programada —nocturna, semanal o mensual, en función del volumen de datos—. Exporta los registros nuevos y modificados de cada sistema fuente desde la última ejecución, procesa estos registros a través del proceso de cotejo y actualiza el almacén de registros de referencia. El motor de automatización de tareas de Data Matching Pro programa y ejecuta tareas de cotejo por lotes sin intervención manual.
Coincidencia de API en tiempo real
En el caso de los sistemas de alta velocidad —puntos de venta, formularios web, integraciones de API—, se necesita una coincidencia en tiempo real en el momento de la creación del registro. La API de búsqueda aproximada en tiempo real de Match Data Pro acepta un nuevo registro como entrada y devuelve el registro de referencia que mejor coincide (junto con la puntuación de coincidencia) en menos de 200 ms. Los nuevos registros que no coinciden con ninguna entidad existente se marcan como candidatos a un nuevo registro de referencia, en lugar de crear un duplicado de forma silenciosa.
Para obtener una comparación detallada sobre cuándo utilizar cada modo, consulta nuestra guía sobre la API de deduplicación frente al procesamiento por lotes.
¿Quieres ver cómo funciona el proceso completo con tus propios datos? Reserva una demostración y te guiaremos paso a paso por una comparación en tiempo real con tus sistemas de origen. O regístrate ahora para empezar una prueba gratuita sin contrato ni compromiso.
Preguntas frecuentes
¿Cómo se pueden cotejar registros entre distintos sistemas cuando no existe un identificador común?
La coincidencia se establece en función del contenido de los propios registros: nombre, correo electrónico, teléfono, dirección y cualquier combinación de esos campos. Un motor de puntuación basado en múltiples algoritmos calcula una puntuación de similitud para cada par de candidatos. Los pares que superan un umbral configurado se vinculan; los que están por debajo se mantienen separados. No se requiere ningún identificador compartido. El proceso funciona siempre que los registros compartan al menos algunos valores de atributos que se solapen.
¿Qué es el bloqueo y por qué es necesario para la conciliación entre sistemas?
El bloqueo reduce el número de pares de registros que hay que evaluar. Sin él, la comparación de 400 000 registros con 600 000 generaría 240 000 millones de pares, lo cual resulta inviable desde el punto de vista computacional. El bloqueo agrupa los registros según una clave compartida (código fonético del nombre, prefijo del código postal, dominio de correo electrónico) de modo que solo se comparen los registros que pertenecen al mismo bloque. Una estrategia de bloqueo de múltiples pasadas bien diseñada reduce los pares candidatos en un 99 % o más, al tiempo que pasa por alto menos del 1 % de las coincidencias reales.
¿Qué campos generan las señales de coincidencia entre sistemas más fiables?
La dirección de correo electrónico (cuando está disponible y es correcta) es el campo con mayor peso: es único, rara vez cambia y admite un margen de error prácticamente nulo. El número de teléfono (normalizado) es el segundo campo más relevante. El nombre completo, junto con el código postal, forma una clave compuesta fiable. La dirección por sí sola es menos fiable, ya que muchas personas comparten la misma dirección. Utiliza el correo electrónico y el teléfono como campos de referencia y considera el nombre y la ubicación como pruebas complementarias, no como la señal principal.
¿Cómo se gestionan los registros en los que faltan campos clave en un sistema?
Considera los campos que faltan como lagunas en la puntuación, en lugar de como errores graves. Si el Sistema A no tiene correo electrónico y el Sistema B sí, puntúa el correo electrónico como neutro (0,5 u omítelo de la puntuación compuesta) en lugar de como cero. Otorga mayor peso a los campos disponibles. Un registro con una fuerte coincidencia entre nombre, teléfono y dirección puede superar el umbral de enlace automático incluso si le falta el correo electrónico. Match Data Pro te permite configurar el tratamiento de los valores nulos por campo en la definición de la regla de coincidencia.
¿Qué ocurre una vez que se han emparejado los registros? ¿Cómo se mantiene el «registro de referencia»?
Tras la correspondencia, las reglas de supervivencia determinan qué valor de campo de cada registro vinculado se incluye en el registro de referencia. Las reglas se configuran por campo: el más reciente, el más completo o la prioridad de la fuente (por ejemplo, el ERP tiene prioridad para la dirección de facturación). El registro de referencia se almacena por separado de los sistemas de origen y se actualiza de forma incremental a medida que llegan nuevos registros. Los registros de los sistemas de origen nunca se modifican: el registro de referencia es una capa de lectura, no de escritura.