
La limpieza automatizada de datos elimina errores, duplicados e incoherencias estructurales de los conjuntos de datos sin procesar mediante un proceso repetible. A gran escala, esto implica analizar millones de registros, estandarizar formatos, corregir errores a nivel de campo, verificar direcciones, eliminar duplicados y resolver la identidad de las entidades antes de que ningún sistema posterior tenga contacto con los datos. La plataforma de limpieza de datos de Match Data Pro ejecuta todo este proceso en un único flujo de trabajo automatizado, sin necesidad de scripts ni de revisión manual de cada registro.
¿Estás listo para depurar tus datos a gran escala? Empieza una prueba gratuita, sin necesidad de contrato.
¿Qué es la depuración de datos y por qué la escala lo cambia todo?
Los términos «depuración de datos» y «limpieza de datos» se utilizan indistintamente. Ambos se refieren al proceso de identificar y corregir registros inexactos, incompletos o incoherentes en un conjunto de datos. La distinción que importa es el volumen. Cuando se trata de unos pocos miles de filas, es posible realizar una inspección manual. Cuando se trata de 5 millones de filas, ya no lo es.
La escala plantea cuatro problemas que los enfoques manuales o improvisados no pueden resolver:
- Volumen: Un sistema CRM con 3 millones de contactos puede contener 400 000 duplicados. Encontrarlos a simple vista es imposible.
- Variedad: La misma empresa aparece como «Acme Corp», «Acme Corporation» y «ACME CORP». Una simple comparación de cadenas no detecta ninguna de las tres como duplicadas.
- Velocity: Continuamente se introducen nuevos datos erróneos en el sistema a través de importaciones, envíos de formularios e integraciones. Una limpieza puntual pierde eficacia en cuestión de semanas.
- Complejidad: Los errores se acumulan. Un registro con un nombre mal escrito, un código postal incorrecto y sin número de teléfono requiere tres pasos de corrección independientes antes de que pueda cotejarse con otro sistema.
La limpieza de datos empresariales aborda estos cuatro aspectos mediante un proceso estructurado y automatizado que se ejecuta según una programación o se activa en tiempo real a través de una API.
El proceso de depuración de datos en 7 etapas
Una limpieza de datos eficaz no es una operación aislada. Se trata de una secuencia de etapas interdependientes, en las que cada una prepara los datos para la siguiente. Si se omite una etapa, los errores se acumulan en las etapas posteriores.
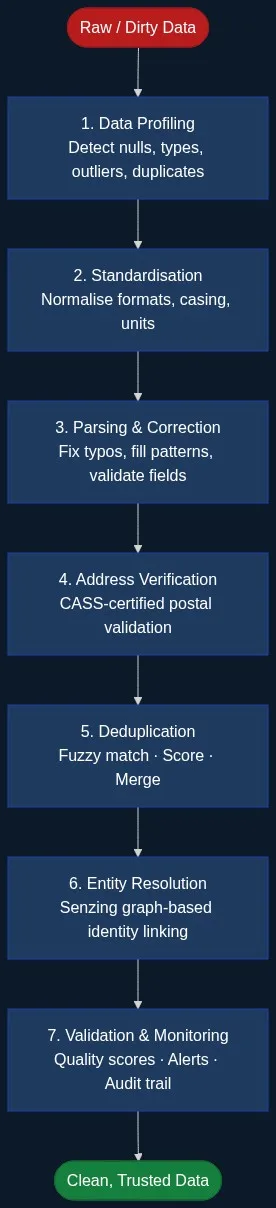
Fase 1: Perfilado de datos
Antes de corregir los datos, es necesario comprender su estado. El análisis de perfiles de datos basado en IA examina todos los campos e informa sobre: índices de valores nulos, distribuciones de formatos, rangos de valores, cardinalidad e incumplimientos de patrones. Un análisis de perfiles realizado en un archivo de contactos de 2 millones de filas podría arrojar los siguientes resultados: un 18 % de direcciones de correo electrónico nulas, un 34 % de formatos de teléfono no estándar y un 7 % de valores de fecha no válidos. Estas cifras definen el alcance de la limpieza antes de que se realice ninguna corrección.
Fase 2: Normalización
La estandarización convierte las representaciones inconsistentes en una única forma canónica. Los números de teléfono pasan a seguir el formato E.164. Las fechas, el formato ISO 8601. Los sufijos de las empresas («Inc», «Inc.», «Incorporated») se unifican en una sola forma. Los valores de estado como «CA», «California» y «Calif.» se resuelven como «CA». La estandarización de datos elimina la variación superficial que provoca falsas discrepancias en etapas posteriores del proceso.
Etapa 3: Análisis sintáctico y corrección de campos
Muchos registros llegan con valores en campos incorrectos o combinados cuando deberían estar separados. Una única columna «Nombre» que contenga «Dra. Jane M. Smith» debe desglosarse en título, nombre, segundo nombre y apellido. Los campos de texto libre correspondientes a la dirección deben dividirse en número de calle, nombre de la calle, ciudad, provincia y código postal. La corrección basada en patrones se encarga de los errores predecibles: en un código postal de seis dígitos se marca el último dígito; un número de teléfono de ocho dígitos se deriva para su revisión.
Fase 4: Verificación de la dirección
Los datos de direcciones pierden precisión a un ritmo aproximado del 10-15 % anual, a medida que los residentes se mudan, las empresas cierran y cambian las rutas postales. La verificación de direcciones con certificación CASS comprueba cada registro postal cotejándolo con la base de datos del USPS, añade los códigos ZIP+4, corrige los errores de entrega y estandariza los sufijos de calle y las indicaciones de dirección. Este paso va más allá del correo: es la única forma fiable de identificar la misma ubicación física en sistemas que la han registrado de forma diferente.
Etapa 5: Desduplicación
La deduplicación identifica los registros que representan la misma entidad del mundo real. La coincidencia exacta se encarga de los registros idénticos. El problema más complejo son los casi duplicados: «Jon Smith, en el 123 de Main St» y «Jonathan Smith, en el 123 de Main Street». La coincidencia aproximada basada en IA calcula puntuaciones de similitud en múltiples campos simultáneamente utilizando el algoritmo de Jaro-Winkler para los nombres, la coincidencia basada en tokens para las direcciones y algoritmos fonéticos para los campos propensos a errores. Una puntuación compuesta ponderada determina si dos registros son iguales, similares pero inciertos, o distintos.
| Campo | Registro A | Disco B | Puntuación |
|---|---|---|---|
| Nombre | Jonathan | Jon | 0,84 (Jaro-Winkler) |
| Apellido | Smith | Smith | 1.00 |
| DIRECCIÓN | Calle Principal, 123 | Calle Main, 123 | 0,97 (token) |
| Correo electrónico | jsmith@acme.com | j.smith@acme.com | 0.91 |
| Compuesto | 0,93 → Coincidencia |
Los registros que superan el umbral de coincidencia se fusionan siguiendo las reglas de supervivencia: prevalece el valor de campo más completo, más reciente o procedente de la fuente más fiable. Los registros que se encuentran en la banda de incertidumbre se envían a una cola de revisión.
Etapa 6: Resolución de entidades
La deduplicación agrupa los registros dentro de un mismo conjunto de datos. La resolución de entidades vincula registros de varios conjuntos de datos que carecen de un identificador común. La resolución de entidades de Senzing utiliza una coincidencia probabilística basada en grafos para agrupar registros procedentes de sistemas CRM, ERP, de marketing y de asistencia técnica en una única vista unificada de entidades. Gestiona variantes de nombres, cambios de dirección a lo largo del tiempo y solapamientos parciales de identificadores, todo ello sin necesidad de reglas definidas manualmente.
Etapa 7: Validación y seguimiento
La limpieza de datos no es un proyecto, sino un proceso continuo. La validación posterior a la limpieza evalúa los aspectos de calidad: exhaustividad, validez, coherencia y unicidad. La supervisión continua detecta cualquier deterioro de la calidad entre ciclos de limpieza. Se activan alertas cuando las tasas de valores nulos superan un umbral o cuando las tasas de introducción de duplicados se disparan tras una importación masiva. Esta etapa cierra el ciclo y da lugar a la siguiente ejecución de la creación de perfiles.
Cuando la limpieza de datos falla sin automatización
Los equipos que recurren a la limpieza manual o a scripts SQL se enfrentan a tres tipos de fallos recurrentes:
Los scripts puntuales no son escalables
Un script en Python que limpia 50 000 registros funciona correctamente. Sin embargo, ese mismo script, aplicado a 50 millones de registros, tarda horas en ejecutarse, no cuenta con recuperación ante errores y no genera ningún registro de auditoría. Cuando el script deja de funcionar tras un cambio en el esquema, nadie sabe qué registros se han limpiado y cuáles no. La coincidencia aproximada en SQL tiene limitaciones similares: SOUNDEX y LIKE no pueden calcular la similitud en varios campos a la vez, y el rendimiento de pg_trgm se degrada rápidamente cuando la cardinalidad es elevada.
La revisión manual tampoco es escalable
Incluso con la detección automatizada, remitir todos los registros dudosos a un revisor humano resulta insostenible cuando se superan los 10 000 registros al día. Un proceso automatizado con umbrales de coincidencia configurables aprueba automáticamente las coincidencias de alta fiabilidad, rechaza automáticamente las que claramente no coinciden y envía a revisión únicamente los casos límite genuinos. La mayoría de los conjuntos de datos empresariales procesan entre el 85 % y el 95 % de los registros de forma directa, sin intervención humana.
La falta de repetibilidad implica deterioro
Un conjunto de datos depurado comienza a deteriorarse al día siguiente de la limpieza. Si no se cuenta con una automatización de tareas que ejecute limpiezas según un calendario definido, la calidad vuelve a los niveles iniciales en cuestión de meses. Los flujos de trabajo automatizados se integran con conectores de importación y exportación, de modo que cada nueva carga de datos activa una limpieza antes de que los registros entren en los sistemas de producción.
Limpieza de datos para casos de uso específicos
Limpieza de datos de CRM
Los sistemas CRM acumulan registros duplicados a través de formularios web, importaciones de ferias comerciales y la introducción manual de datos. Una instalación típica de Salesforce o HubSpot acumula una tasa de duplicación del 10 al 20 % en un plazo de dos años. La limpieza de un CRM requiere una coincidencia aproximada que tenga en cuenta el nombre (que gestione apodos como «Bob» para «Robert»), la estandarización de direcciones, la validación de dominios de correo electrónico y reglas de supervivencia que conserven los datos de actividad más recientes.
Limpieza de listas de marketing
Las bases de datos de marketing procedentes de distintos proveedores de listas contienen registros que se solapan y presentan diferentes formatos. La depuración previa a una campaña evita el gasto innecesario en envíos, excluye a los contactos que se han dado de baja y garantiza que las listas de exclusión se apliquen correctamente. Una lista depurada de 1 millón de registros suele reducirse a entre 750 000 y 850 000 contactos únicos a los que se puede enviar el mensaje.
Limpieza de datos financieros y operativos
Los ficheros maestros de proveedores, los libros mayores de clientes y las bases de datos de contrapartes deben someterse a un proceso de depuración antes de la presentación de informes reglamentarios. Los registros duplicados de proveedores suponen un riesgo de fraude en los pagos. Las identidades de clientes sin resolver en las distintas líneas de negocio crean puntos ciegos en la lucha contra el blanqueo de capitales. La resolución de entidades en los conjuntos de datos financieros es un requisito de cumplimiento normativo, no solo una mejora de la calidad.
Cómo Match Data Pro automatiza la limpieza de datos
Match Data Pro ofrece las siete etapas en una única plataforma SaaS en la nube. No es necesario aprovisionar ninguna infraestructura ni firmar ningún contrato a largo plazo. Solo tienes que conectar tu fuente de datos mediante los conectores de importación integrados (CSV, Excel, base de datos, API), configurar el proceso de limpieza de datos y ejecutarlo bajo demanda o según una programación.
El motor de perfilado de datos con IA de la plataforma se ejecuta antes de cada limpieza y genera una ficha de evaluación de la calidad. Las reglas de estandarización se pueden configurar según el tipo de campo. El motor de coincidencia aproximada admite algoritmos de Levenshtein, Jaro-Winkler, fonéticos y basados en tokens, con ponderaciones por campo y umbrales compuestos. La resolución de entidades de Senzing se ejecuta de forma nativa dentro de la plataforma para establecer vínculos entre conjuntos de datos. La verificación de direcciones, certificada por CASS, añade el código ZIP+4 y corrige los errores de entrega a nivel de registro. La automatización de tareas programa limpiezas periódicas y activa alertas cuando se superan los umbrales de calidad.
Tras un proceso de depuración, la plataforma exporta los registros limpios a través del mismo conector utilizado para la importación, directamente a Salesforce, HubSpot, bases de datos SQL o archivos planos. Cada decisión de coincidencia se registra con puntuaciones a nivel de campo y el algoritmo que las ha generado, lo que proporciona a los equipos de cumplimiento normativo un registro de auditoría completo.
Reserva una demostración para ver cómo funciona todo el proceso de limpieza de datos con una muestra de tus datos.
Preguntas frecuentes
¿Cuál es la diferencia entre el «data scrubbing» y la «limpieza de datos»?
Los términos «depuración de datos» y «limpieza de datos» describen el mismo proceso: detectar y corregir errores, incoherencias y duplicados en un conjunto de datos. En la práctica, ambos términos son intercambiables. Algunos equipos utilizan el término «depuración» para hacer hincapié en la eliminación de registros basura, mientras que «limpieza» implica una mejora de la calidad más amplia, que incluye la estandarización y el enriquecimiento. En cualquier caso, el enfoque estándar a gran escala consiste en un flujo de trabajo automatizado que abarca la elaboración de perfiles, la estandarización, la deduplicación y la validación.
¿Cuánto tiempo se tarda en depurar un conjunto de datos grande?
El tiempo de procesamiento depende del tamaño del conjunto de datos, la complejidad de los campos y el número de etapas del proceso. Un archivo de contactos de un millón de filas con coincidencia aproximada y verificación de direcciones suele completarse en un plazo de entre 15 y 45 minutos en una plataforma en la nube. Un archivo de 50 millones de filas puede tardar varias horas en modo por lotes. La limpieza en tiempo real a través de la API procesa registros individuales o pequeños lotes en milisegundos, lo que resulta adecuado para la validación en el punto de entrada, más que para limpiezas masivas.
¿Con qué frecuencia se debe realizar una limpieza de datos?
La calidad de los datos se deteriora continuamente. La mayoría de los equipos empresariales realizan una limpieza programada mensual o trimestral de sus conjuntos de datos principales, además de una limpieza en tiempo real en el momento de la entrada de los nuevos registros. Los conjuntos de datos que reciben grandes importaciones masivas deben activar una limpieza inmediatamente después de cada importación. Los datos de direcciones requieren una verificación al menos una vez al año para tener en cuenta la tasa de cambio anual del 10-15 % en los registros postales.
¿El software de limpieza de datos puede gestionar datos internacionales?
Sí, pero los datos internacionales requieren una configuración del algoritmo. La coincidencia de nombres debe tener en cuenta las variantes de transliteración (por ejemplo, «Mohamed» frente a «Muhammad»), los conjuntos de caracteres y las convenciones de orden de los nombres, que varían según el país. El análisis de direcciones debe tener en cuenta los formatos distintos a los de EE. UU. Match Data Pro admite la coincidencia aproximada internacional con ponderaciones de algoritmos configurables y definiciones de campos que se adaptan a estructuras de datos distintas a las de EE. UU.
¿Qué es una regla de supervivencia en la limpieza de datos?
Una regla de supervivencia determina qué valor de campo se debe conservar cuando dos registros coincidentes tienen valores diferentes. Entre las reglas más habituales se incluyen: conservar el valor actualizado más recientemente, conservar el valor no nulo, conservar el valor de la fuente más fiable o conservar el valor más largo en el caso de los campos de texto libre. Las reglas de supervivencia se aplican durante la fase de fusión del proceso de deduplicación y deben configurarse para cada campo con el fin de evitar que los datos válidos se sobrescriban con datos erróneos.