
El EMPI (Índice Maestro de Pacientes Empresarial) y la resolución de entidades resuelven el mismo problema fundamental —vincular registros que representan a la misma entidad del mundo real en sistemas aislados—, pero están diseñados para contextos, escalas de datos y requisitos operativos diferentes. El EMPI es una tecnología específica del sector sanitario; la resolución de entidades es una técnica generalizada aplicable a cualquier sector. Comprender en qué aspectos coinciden, en qué difieren y qué enfoque se adapta mejor a tu entorno puede ahorrarle a tu equipo meses de trabajo de implementación.
¿Estás listo para descubrir cómo la resolución de entidades moderna resuelve tu problema de coincidencia? Empieza hoy mismo una prueba gratuita de Match Data Pro, sin necesidad de contrato.
¿Qué es un EMPI y por qué lo utilizan los equipos de TI del sector sanitario?
Un Índice Maestro de Pacientes Empresarial es una base de datos y un sistema de cotejo que crea una identidad única y oficial del paciente en todos los sistemas clínicos, administrativos y de facturación de una organización sanitaria. Su función es responder a una pregunta: ¿son la misma persona Jane Smith, con fecha de nacimiento 15/04/1982, que figura en la historia clínica electrónica, y J. Smith, con fecha de nacimiento 15/04/82, que figura en el sistema de facturación?
Los sistemas EMPI suelen utilizar una combinación de reglas deterministas (coincidencia exacta del número de la Seguridad Social, fecha de nacimiento exacta) y una puntuación probabilística basada en datos demográficos —nombre, fecha de nacimiento, dirección, teléfono y sexo— para asignar una puntuación de confianza en la coincidencia. Cuando la puntuación supera un umbral, el sistema vincula los registros bajo un único identificador empresarial (a menudo denominado «identificador maestro del paciente» o MPI).
Modelo de datos EMPI
Un EMPI típico se basa en un conjunto fijo de atributos demográficos. El historial del paciente podría tener el siguiente aspecto:
| Campo | Fuente A (historial clínico electrónico) | Fuente B (Facturación) | Peso de la partida |
|---|---|---|---|
| Apellido | Johnson | Jonhson | 0,87 (difuso) |
| Nombre | Margaret | Maggie | 0,72 (apodo) |
| Fecha de nacimiento | 22 de marzo de 1975 | 22/03/75 | 1,00 (exacto) |
| Código postal | 90210 | 90210 | 1,00 (exacto) |
| Teléfono | 310-555-0142 | 3105550142 | 1,00 (normalizado) |
La puntuación combinada de este par supera el 0,85, lo que activa una vinculación automática. Por debajo de 0,60, el sistema marca los registros como distintos. Los casos de la zona gris (0,60-0,85) se remiten a un revisor humano.
Las plataformas EMPI están profundamente integradas con estándares de datos específicos del sector sanitario, como HL7, FHIR e IHE PIX/PDQ. A menudo se ejecutan dentro del cortafuegos del hospital, alimentando la historia clínica electrónica (EHR), los sistemas de laboratorio, la farmacia y el portal del paciente a partir de una única fuente de identidad fiable.
¿Qué es la resolución de entidades y en qué se diferencia?
La resolución de entidades es el proceso más amplio e independiente del ámbito específico que consiste en identificar y vincular registros que hacen referencia a la misma entidad del mundo real —un cliente, una empresa, un producto, una dirección o una persona— en fuentes de datos dispares. Mientras que EMPI es un producto específico para el sector sanitario, la resolución de entidades es una funcionalidad que puede aplicarse en sistemas CRM, ERP, sistemas financieros, bases de datos gubernamentales o cualquier entorno de datos con múltiples fuentes.
Las plataformas modernas de resolución de entidades, como Match Data Pro, utilizan una técnica de coincidencia probabilística basada en grafos, impulsada por la tecnología de resolución de entidades de Senzing, para gestionar millones de registros en tiempo real. A diferencia de los sistemas EMPI, que funcionan con un esquema demográfico fijo, la resolución de entidades puede operar con cualquier combinación de campos —nombre de la empresa, NIF, dominio, dirección, código SIC— y adaptar las ponderaciones de puntuación a los datos disponibles.
Diferencias arquitectónicas clave
| Dimensión | EMPI | Resolución de entidades empresariales |
|---|---|---|
| Dominio | Solo asistencia sanitaria | Cualquier sector |
| Esquema | Campos demográficos fijos | Cualquier combinación de campos |
| Normas | HL7, FHIR, IHE PIX/PDQ | API REST, CSV, JDBC, conectores en la nube |
| Enfoque de emparejamiento | Reglas probabilísticas y determinísticas | Probabilístico, basado en grafos y ponderado mediante IA |
| Escala | Decenas de millones de historiales de pacientes | Cientos de millones de registros |
| Implementación | En las propias instalaciones (por lo general) | SaaS o en las propias instalaciones |
| Revisión por parte de una persona | Flujo de trabajo integrado | Enrutamiento con umbrales configurables |
| Registro de auditoría | Nivel de cumplimiento normativo en el sector sanitario | Registro de auditoría configurable |
Las carencias del EMPI fuera del ámbito sanitario
Las herramientas EMPI están diseñadas específicamente para los datos de los pacientes. Este enfoque plantea tres limitaciones importantes cuando los equipos de TI del sector sanitario intentan aplicarlas más allá de la identidad clínica:
1. Esquema rígido
Los sistemas EMPI están optimizados para un modelo demográfico específico. La correspondencia entre entidades empresariales, cuentas financieras o registros de la cadena de suministro requiere diferentes ponderaciones de campos y algoritmos que las plataformas EMPI no pueden reconfigurar fácilmente. Por ejemplo, no es posible añadir un campo de NIF ni asignar una ponderación diferente a los nombres de dominio sin un desarrollo a medida.
2. Enlaces entre dominios limitados
Las organizaciones sanitarias modernas necesitan vincular las identidades de los pacientes no solo dentro de los sistemas clínicos, sino también con los datos de las entidades pagadoras, los gestores de prestaciones farmacéuticas y las plataformas de salud poblacional. Los sistemas EMPI rara vez ofrecen API flexibles para este tipo de resolución de entidades entre distintos dominios. Una API de coincidencia basada en REST se adapta mucho mejor a una integración rápida entre múltiples dominios.
3. Procesamiento por lotes
Muchas plataformas EMPI heredadas procesan los registros en ejecuciones por lotes nocturnas. La comparación en tiempo real en el momento del registro —cuando un paciente acude al servicio de urgencias— requiere tiempos de respuesta inferiores a un segundo, algo que las arquitecturas orientadas a lotes no pueden ofrecer. La comparación entre la deduplicación por lotes y la deduplicación mediante API pone de manifiesto por qué es importante contar con una arquitectura en tiempo real en el momento de la admisión del paciente.
Ámbitos en los que la resolución de entidades destaca
Las plataformas de resolución de entidades de uso general presentan varias ventajas estructurales frente a las herramientas EMPI específicas de un ámbito concreto:
Algoritmos de coincidencia configurables
El motor de coincidencia aproximada de Match Data Pro te permite elegir el algoritmo para cada campo: Jaro-Winkler para nombres, coincidencia exacta para fechas de nacimiento, fonética para variantes de nombres extranjeros y proporción de conjuntos de tokens para nombres de empresas. Las plataformas EMPI suelen aplicar una ponderación fija del algoritmo en todos los campos, con posibilidades de ajuste limitadas.
Consideremos estos dos historiales clínicos que un EMPI poco flexible podría pasar por alto:
| Campo | Registro 1 | Registro 2 | Nota |
|---|---|---|---|
| Nombre | Mohamed Al-Rahman | Mohammad Alrahman | Variante de transliteración |
| Fecha de nacimiento | 3 de noviembre de 1989 | 11 de marzo de 1989 | Mes y día invertidos |
| DIRECCIÓN | Calle Oak, 14, apartamento 2B | Calle Oak, 14, apartamento 2B | Variante del sufijo de unidad |
Un motor de resolución de entidades (EMPI) que utilice ponderaciones fijas para la fecha de nacimiento otorgaría a este par una puntuación baja, ya que la transposición de la fecha de nacimiento reduce a cero la puntuación del campo de fecha. Un motor de resolución de entidades configurable puede reducir la ponderación de la fecha de nacimiento, aumentar la ponderación de la coincidencia de la dirección y señalar este caso como un posible duplicado para su revisión manual.
Tipos de entidades intersectoriales
La resolución de entidades gestiona personas, empresas, direcciones y productos dentro del mismo flujo de trabajo. Esto resulta fundamental para una red de prestación de servicios integrada que también gestiona contratos con proveedores, colaboraciones de investigación y relaciones con las entidades pagadoras. Una única plataforma de resolución de entidades puede cotejar los historiales de los pacientes en una tarea y los registros de los proveedores en otra, y ejecutar ambas tareas según una programación automatizada.
Coincidencia de API en tiempo real
Match Data Pro ofrece una API de búsqueda aproximada en tiempo real que devuelve posibles coincidencias en milisegundos. En el momento del registro del paciente, el sistema de recepción realiza una llamada a la API con los datos demográficos recibidos y obtiene al instante una lista de coincidencias ordenadas por relevancia, sin necesidad de procesar por lotes ni de realizar búsquedas manuales. Se trata de la misma arquitectura que se utiliza en la detección de fraudes en tiempo real y en la deduplicación de datos de CRM.
El proceso de seis etapas que une ambos mundos
Tanto si gestionas un EMPI, una plataforma general de resolución de entidades o ambas cosas, el proceso subyacente de control de calidad de los datos es el mismo. Saltarse cualquier etapa reduce la precisión de las coincidencias en todas las etapas posteriores.
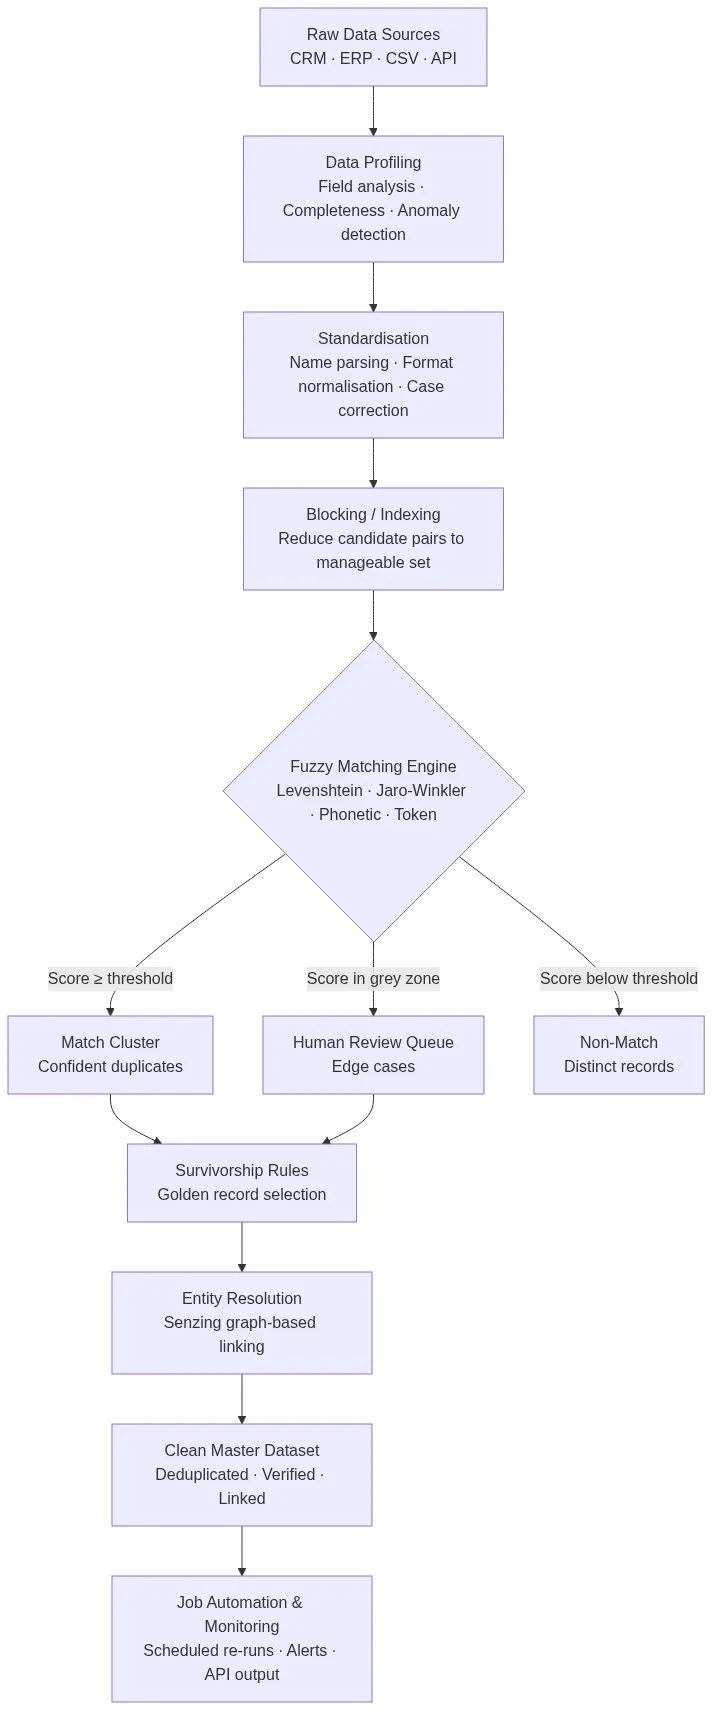
Fase 1: Perfilado de datos. Se comprueba cada campo entrante para verificar que esté completo, que el formato sea coherente y que no presente un índice de anomalías elevado. El motor de perfilado de datos basado en IA de Match Data Pro evalúa cada campo en seis dimensiones y señala aquellos campos con índices elevados de valores nulos o formatos incoherentes antes de que entren en el proceso de cotejo.
Etapa 2: Estandarización. Análisis sintáctico de nombres (separación de nombre, apellidos y segundo nombre), normalización del formato de fecha (de MM/DD/AA a ISO 8601), eliminación de números de teléfono y separación de los componentes de la dirección. Sin este paso, «John A. Smith» y «Smith, John A.» nunca coincidirían, ni siquiera con un algoritmo de búsqueda aproximada perfecto.
Etapa 3: Agrupación / Indexación. Comparar cada registro con todos los demás tiene una complejidad de O(n²). La agrupación reduce el espacio de pares candidatos al agrupar los registros que comparten al menos un elemento común —un código postal, los tres primeros caracteres del apellido o un código Soundex—. Esto hace que la comparación de 10 millones de registros sea factible desde el punto de vista computacional.
Etapa 4: Coincidencia aproximada. Se aplican algoritmos específicos para cada campo y se calcula una puntuación de coincidencia global para cada par de candidatos. Las puntuaciones superiores al umbral de enlace automático dan lugar a coincidencias confirmadas. Las puntuaciones que se encuentran en la zona gris se remiten a revisión humana. Las puntuaciones inferiores al umbral se descartan como no coincidentes.
Etapa 5: Supervivencia y creación del registro de oro. Cuando dos registros coinciden, las reglas de supervivencia determinan qué valor de campo se mantiene en el registro maestro. La regla puede ser: dar preferencia al valor actualizado más recientemente, al valor más largo o al valor procedente del sistema fuente más fiable. El motor de supervivencia de Match Data Pro te permite configurar estas reglas por campo.
Etapa 6: Automatización y supervisión. Tanto el EMPI como la resolución de entidades requieren ejecuciones programadas a medida que llegan nuevos registros. El programador de automatización de tareas de Match Data Pro se encarga de ello: basta con definir un flujo de trabajo, establecer una cadencia (nocturna, cada hora o activada por eventos) y la plataforma ejecuta el ciclo completo de perfilado, estandarización, emparejamiento y fusión sin intervención manual.
¿Estás listo para ejecutar este proceso con tus datos? Reserva una demostración y nuestro equipo te guiará paso a paso por la configuración adaptada a tu entorno de datos específico.
Cuándo optar por EMPI, la resolución de entidades o ambas
Elige EMPI cuando:
- El ámbito de comparación se limita exclusivamente a los datos demográficos de los pacientes dentro de un único sistema sanitario.
- Necesitas una integración profunda con los estándares HL7 FHIR e IHE PIX/PDQ desde el primer momento.
- Los requisitos normativos (HIPAA, Ley Cures de la ONC) exigen un sistema certificado para el sector sanitario integrado en tu historia clínica electrónica (EHR).
- Tu proveedor de historias clínicas electrónicas (EHR) ofrece funciones de EMPI incluidas en el mismo producto.
Elige la resolución de entidades cuando:
- Debes relacionar entidades que vayan más allá de los datos demográficos de los pacientes: proveedores, entidades pagadoras, socios de investigación o personal.
- Operáis en varios sectores o ámbitos de datos dentro de la misma organización.
- Necesitas una sincronización en tiempo real a través de la API, no solo un procesamiento por lotes nocturno.
- Quieres algoritmos y ponderaciones de campos configurables sin necesidad de desarrollo a medida.
- Necesitas un marco completo de calidad de datos —perfilado, limpieza, deduplicación y resolución de entidades— en una sola plataforma.
Ten en cuenta ambos casos cuando:
Las grandes redes integradas de atención sanitaria suelen utilizar un EMPI para la identidad clínica y una plataforma independiente de resolución de entidades para la calidad de los datos a nivel de toda la organización. Ambos sistemas pueden coexistir: el EMPI gestiona la identidad de los pacientes dentro del ámbito clínico, mientras que la plataforma de resolución de entidades se encarga de la correspondencia entre ámbitos, la deduplicación de proveedores y el proceso general de calidad de los datos. La vinculación de registros entre múltiples sistemas es precisamente donde la resolución de entidades aporta un valor añadido que el EMPI no puede ofrecer.
Preguntas frecuentes
¿Cuál es la diferencia entre EMPI y la resolución de entidades?
El EMPI (Enterprise Master Patient Index) es un sistema de coincidencia de identidades específico para el ámbito sanitario, diseñado para los historiales de pacientes, que utiliza campos demográficos fijos y estándares de datos sanitarios (HL7, FHIR). La resolución de entidades es el proceso más amplio e independiente del ámbito de aplicación que consiste en vincular registros de cualquier tipo de datos o sector, mediante algoritmos configurables, esquemas de campos flexibles y la integración de una API REST.
¿Puede la resolución de entidades sustituir al EMPI en el ámbito sanitario?
En muchos casos de uso, sí. Una plataforma configurable de resolución de entidades puede cotejar los datos demográficos de los pacientes con una precisión igual o superior a la de un EMPI tradicional, al tiempo que gestiona entidades ajenas a los pacientes, como proveedores, entidades pagadoras y personal. La contrapartida es que las plataformas EMPI ofrecen una integración más profunda y lista para usar con los estándares específicos del sector sanitario y los sistemas de historias clínicas electrónicas (EHR).
¿Qué algoritmos de emparejamiento utiliza un EMPI?
La mayoría de las plataformas EMPI combinan reglas deterministas (coincidencias exactas en el número de la Seguridad Social y la fecha de nacimiento) con una puntuación probabilística de los campos demográficos mediante algoritmos como Jaro-Winkler para los nombres y Soundex para las variantes fonéticas. Las puntuaciones ponderadas combinadas determinan si los registros se vinculan automáticamente, se marcan para su revisión o se rechazan por no coincidir.
¿Cómo decide una organización sanitaria entre el EMPI y la resolución de entidades generales?
Si el alcance de la resolución de entidades se limita a la identidad de los pacientes dentro de un único sistema sanitario integrado con HL7 FHIR, un EMPI suele ser la opción más adecuada. Si la organización necesita resolver entidades entre distintos ámbitos —pacientes, proveedores, entidades pagadoras, socios de investigación— o necesita una resolución en tiempo real basada en API y algoritmos configurables, una plataforma general de resolución de entidades ofrece mayor flexibilidad a un coste similar o inferior.
¿Qué es un «registro de referencia» en el contexto de la identificación de pacientes?
Un «registro de referencia» es la única representación oficial de un paciente que se crea aplicando reglas de selección a todos los registros duplicados emparejados. Para cada campo demográfico, una regla determina qué valor de origen se mantiene —normalmente, el actualizado más recientemente, el más completo o el valor procedente del sistema de origen más fiable—. El «registro de referencia» se convierte en la única identidad a la que hace referencia toda la organización.