
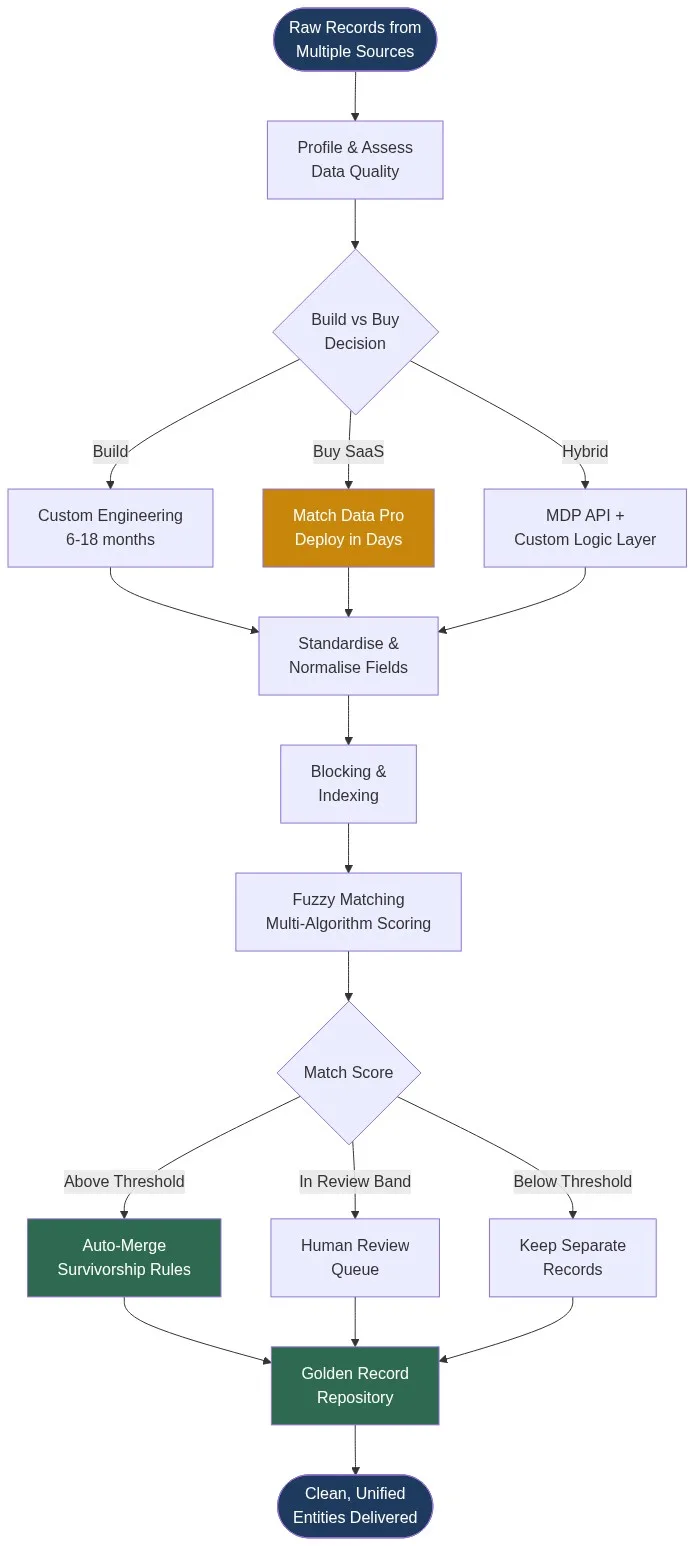
Elegir entre desarrollar, adquirir o combinar distintos enfoques para la resolución de entidades es una de las decisiones de infraestructura de mayor importancia que toma un equipo de datos. Para la mayoría de las organizaciones que procesan millones de registros en sistemas CRM, ERP y fuentes de terceros, adquirir una plataforma SaaS en la nube de probada eficacia ofrece resultados precisos en cuestión de días —y no de meses— a una fracción del coste de desarrollo. La vía híbrida es adecuada para equipos que necesitan una capa de API con su propia marca sobre un motor de correspondencia que haya demostrado su eficacia. Comprender en qué aspectos cada enfoque tiene éxito y en cuáles falla evita un error de ingeniería que podría costar cientos de miles de euros.
¿Necesitas evaluar tus opciones rápidamente? Empieza una prueba gratuita de Match Data Pro y ejecuta tu primera tarea de resolución de entidades con datos reales antes de decidirte por cualquier enfoque.
Lo que realmente requiere la resolución de entidades
La resolución de entidades identifica los registros de distintos conjuntos de datos que hacen referencia a la misma entidad del mundo real —una persona, una empresa, una dirección o un activo— y los vincula o fusiona en un «registro de referencia» unificado. El proceso es más complicado de lo que parece. Consideremos estos dos registros de clientes:
| Campo | Registro A (CRM) | Registro B (ERP) |
|---|---|---|
| Nombre | Acme Corp. | ACME Corporation |
| DIRECCIÓN | 123 Main St, Chicago, IL | Calle Main, 123, Chicago, Illinois 60601 |
| Teléfono | 312-555-0182 | (312) 555-0182 |
| Contacto | J. Smith | John Smith |
Una unión determinista basada en un único campo falla. La resolución de entidades requiere una puntuación difusa basada en varios campos —aplicando el algoritmo de Jaro-Winkler al nombre, la relación de conjuntos de tokens a la dirección y la coincidencia exacta normalizada al número de teléfono— y, a continuación, ponderar esas puntuaciones para obtener una puntuación de similitud compuesta. Solo entonces el sistema puede decidir: fusionar, marcar para su revisión o rechazar.
Ese proceso consta, como mínimo, de seis etapas: perfilado de datos, estandarización, agrupación en bloques, coincidencia aproximada, enrutamiento por umbrales y supervivencia. Cada etapa debe ser configurable, auditable y escalable a decenas de millones de pares de registros. El nivel de exigencia técnica es considerable, independientemente del enfoque que se elija.
El enfoque de construcción: costes reales y riesgos ocultos
Desarrollar un sistema de resolución de entidades internamente parece una opción atractiva. Lógica personalizada, control total, sin dependencia de proveedores. En la práctica, el esfuerzo de ingeniería casi siempre supera el alcance y los plazos previstos.
Lo que realmente requiere un montaje a medida
- Motor de búsqueda: varias implementaciones de algoritmos (Levenshtein, Jaro-Winkler, Soundex, basados en tokens), configuración de la ponderación de campos y gestión de umbrales.
- Capa de bloqueo: La generación de pares candidatos debe ser eficiente a gran escala. Sin el bloqueo, comparar 10 millones de registros por pares generaría 50 billones de comparaciones.
- Lógica de supervivencia: reglas que determinan qué valor de campo prevalece cuando dos registros entran en conflicto: el más reciente, el más completo o el de mayor fiabilidad de la fuente.
- Interfaz de revisión: una interfaz de usuario para la revisión humana de pares dudosos, con opciones de aceptación o rechazo y bucles de retroalimentación hacia el modelo.
- Registro de auditoría: cada decisión sobre coincidencias se registra junto con los resultados de campo, el algoritmo utilizado y la acción del operador —requisito obligatorio según el RGPD, la HIPAA y la ley SOX—.
- Mantenimiento continuo: los algoritmos deben reajustarse a medida que cambian los patrones de los datos. Los cambios en el esquema de los sistemas de origen rompen las reglas de normalización.
La realidad de los costes
Un proyecto de resolución de entidades de complejidad media suele requerir dos ingenieros sénior durante un periodo de entre 6 y 18 meses. Con un coste total de entre 180 000 y 220 000 dólares por ingeniero al año, eso supone entre 180 000 y 660 000 dólares en mano de obra antes de que se haya emparejado el primer registro en producción. Si se añaden los costes de infraestructura, pruebas y mantenimiento continuo, el total a tres años supera los 800 000 dólares para la mayoría de los equipos. El análisis comparativo entre desarrollar o adquirir software de resolución de entidades muestra sistemáticamente que el desarrollo interno cuesta entre 500 000 y 1,5 millones de dólares a lo largo de tres años.
El riesgo se agrava con el paso del tiempo. Un calendario de desarrollo de seis meses retrasa en medio año el valor empresarial de los datos limpios. Durante ese periodo, se acumulan los duplicados, los análisis siguen sin ser fiables y el equipo que se suponía que debía llevar a cabo iniciativas relacionadas con los datos se ve obligado, en cambio, a depurar un motor de coincidencia.
El enfoque de compra: qué hay que valorar en una plataforma SaaS
La adquisición de una plataforma de resolución de entidades diseñada específicamente para este fin elimina la carga de trabajo de ingeniería y ofrece un proceso listo para su implementación en producción en cuestión de días. La clave está en saber qué diferencia a las herramientas de coincidencia genéricas de las plataformas capaces de gestionar la resolución de entidades a escala empresarial y en múltiples dominios.
Cinco características que definen las plataformas de nivel empresarial
- Puntuación configurable con múltiples algoritmos: no hay ningún algoritmo que funcione para todos los tipos de campos. Los campos de nombre requieren el algoritmo de Jaro-Winkler; los de dirección, la relación de conjuntos de tokens; y los de identificadores numéricos, una coincidencia exacta o tolerante a la transposición. La plataforma debe permitir asignar algoritmos y ponderaciones para cada campo.
- Eficiencia de agrupación: la agrupación por vecindad ordenada, el índice invertido o la agrupación fonética reducen el número de pares candidatos de un crecimiento cuadrático a uno lineal. Sin ello, ninguna plataforma puede escalar más allá de unos pocos cientos de miles de registros.
- Agrupación de entidades basada en grafos: al vincular A con B y B con C, A debería vincularse automáticamente con C. Las plataformas que utilizan la resolución de entidades basada en grafos de Senzing gestionan las relaciones transitivas de forma nativa, sin necesidad de programar manualmente la lógica de encadenamiento.
- Reglas de supervivencia: controles a nivel de campo que determinan qué valor se introduce en el registro de referencia. La plataforma debe admitir reglas de prioridad de la fuente, actualidad y exhaustividad, y gestionar los conflictos sin pérdida de datos. Descubre cómo funcionan en la práctica las reglas de supervivencia y los registros de referencia.
- Registro de auditoría y explicabilidad: cada decisión de emparejamiento debe poder rastrearse hasta los resultados de campo y las ponderaciones del algoritmo que la generaron. Esto es imprescindible en los sectores regulados.
Match Data Pro como opción de compra
Match Data Pro ofrece estas cinco funcionalidades en una plataforma SaaS en la nube sin contrato a largo plazo. La plataforma combina la elaboración de perfiles de datos basada en IA, que evalúa la calidad de los campos antes de ejecutar la comparación; algoritmos difusos configurables para todo tipo de campos; la resolución de entidades de Senzing para la agrupación probabilística basada en grafos; y la verificación de direcciones certificada por CASS. Los conectores de importación admiten CSV, Excel, bases de datos SQL y la API REST. La automatización de tareas ejecuta procesos programados de deduplicación y resolución de entidades sin necesidad de activarlos manualmente. La API de búsqueda difusa en tiempo real permite evitar duplicados en el momento de introducir los registros, antes de que los datos erróneos entren en el sistema.
La implementación lleva horas, no meses. Un equipo puede analizar un conjunto de datos, configurar reglas de coincidencia, ejecutar un proceso completo de resolución de entidades y revisar el resultado del «registro de referencia» desde el primer día. Reserva una demostración para ver el proceso completo aplicado a tus datos.
El enfoque híbrido: cuándo conviene utilizar una capa personalizada
El término «híbrido» se refiere a utilizar como núcleo un motor de emparejamiento SaaS de probada eficacia —al que se accede a través de una API— y desarrollar una lógica personalizada a su alrededor. Esta es la vía adecuada para una minoría concreta de equipos, no una recomendación general.
Cuándo está justificado el sistema híbrido
- Preprocesamiento específico del ámbito: Tus datos de origen requieren un análisis sintáctico específico del sector antes de que se pueda ejecutar la comparación estándar; por ejemplo, el análisis sintáctico de nombres de compuestos químicos, códigos ISIN o identificadores de entidades jurídicas que un normalizador general no gestiona.
- Caso de uso de un producto integrado: tu plataforma es un producto, no una herramienta interna. Debes ofrecer la función de búsqueda de coincidencias a los clientes como una funcionalidad de marca a través de tu propia API, con el motor SaaS funcionando en segundo plano.
- Anulación de la puntuación predeterminada: Tu ámbito de negocio cuenta con una lógica de correspondencia verdaderamente única —un modelo de puntuación de riesgo, una regla de clasificación de cumplimiento— que no puede expresarse mediante ponderaciones y umbrales de campo estándar.
La API REST y la API de búsqueda difusa en tiempo real de Match Data Pro son compatibles directamente con arquitecturas híbridas. Tu flujo de trabajo realiza llamadas a los puntos finales de MDP para la generación de candidatos, la puntuación y la deduplicación, y a continuación aplica tu lógica propia a los resultados puntuados. De este modo, el motor de correspondencias se mantiene y actualiza por parte del proveedor, mientras que tu capa personalizada se encarga de los requisitos específicos del dominio. Descubre cómo los flujos de trabajo de resolución de entidades basados en agentes utilizan este patrón a gran escala.
Cuándo no está justificado el sistema híbrido
La mayoría de los equipos que afirman necesitar un enfoque híbrido están, en realidad, racionalizando un proceso de desarrollo. La verdadera motivación suele ser la familiaridad con la programación frente a la configuración, o la creencia de que sus datos son excepcionalmente complejos. En la práctica, las ponderaciones de campos configurables, las claves de bloqueo personalizadas y los umbrales ajustables en una plataforma como Match Data Pro permiten gestionar la gran mayoría de los requisitos específicos del ámbito sin necesidad de escribir ni una sola línea de código de coincidencia.
Si estás llevando a cabo la resolución de entidades de forma interna con datos de CRM, ERP o de marketing —sin que exista ningún requisito de producto orientado al cliente—, es mejor optar por una solución de compra en lugar de una híbrida. El mantenimiento continuo de una capa de API personalizada aumenta los costes de ingeniería e introduce puntos de fallo con cada cambio en el esquema de origen.
Marco de decisión: cómo elegir
Responde a estas cuatro preguntas en orden. Detente cuando tengas una respuesta clara.
- ¿Dispones de un equipo de ingeniería dedicado con una autonomía financiera de al menos 6 meses? Si la respuesta es no, cómpralo. El plazo de desarrollo por sí solo descarta la opción de una solución a medida.
- ¿Tu caso de uso requiere una personalización de la marca en la API orientada al cliente o una lógica de puntuación propia? Si es así, plantéate la opción híbrida. Si no, cómprala.
- ¿Se pueden expresar los requisitos específicos de tu ámbito mediante ponderaciones de campos configurables, claves de bloqueo personalizadas y reglas de umbral? Para el 90 % de los equipos, la respuesta es sí. Cómpralo y configúralo.
- ¿Son tu volumen de datos y tu esquema tan poco habituales que ninguna plataforma comercial se ajusta a tus necesidades? Si realmente es así, crea tu propia solución. Pero comprueba primero esta afirmación con una versión de prueba de la plataforma: quizá te sorprenda lo que se puede conseguir solo con la configuración.
El análisis sobre cómo ajustar adecuadamente tu estructura de calidad de datos confirma que la mayoría de los equipos sobreestiman enormemente la complejidad de sus requisitos a la hora de valorar si es mejor desarrollar la solución internamente o adquirirla. Una prueba gratuita resuelve la duda en cuestión de horas.
Tabla comparativa
| Factor | Compilar | Comprar (Match Data Pro) | Híbrido |
|---|---|---|---|
| Tiempo hasta el primer partido | 6-18 meses | De horas a días | De 2 a 6 semanas (integración con API) |
| Coste a tres años | Entre 500 000 y 1,5 millones de dólares o más | Suscripción mensual a un servicio SaaS | Cuota de SaaS + tiempo de ingeniería |
| Flexibilidad de los algoritmos | Totalmente personalizado | Configurable, con múltiples algoritmos | Algoritmos MDP + anulación personalizada |
| Carga de mantenimiento | Responsabilidad total en materia de ingeniería | Gestionado por el proveedor | Solo capa personalizada |
| Registro de auditoría | Hazlo tú mismo | Integrado, conforme a las normas de cumplimiento | Ruta MDP + registro personalizado |
| Escala | Depende de la calidad de fabricación | Probado con decenas de millones de registros | Heredan la escala MDP |
Preguntas frecuentes
¿Cuánto tiempo se tarda en desarrollar un sistema de resolución de entidades desde cero?
Una implementación de resolución de entidades lista para producción suele tardar entre 6 y 18 meses con dos ingenieros sénior. El plazo incluye el desarrollo de algoritmos, la optimización de bloques, la revisión de la interfaz, el registro de auditoría y el ajuste del rendimiento a gran escala. La mayoría de los equipos subestiman el coste de mantenimiento tras la implementación inicial, lo que supone una carga de trabajo de ingeniería continua cada vez que cambian los esquemas de origen o aumentan los volúmenes de datos.
¿Cuál es el coste habitual de adquirir un software de resolución de entidades?
Las plataformas SaaS de resolución de entidades empresariales suelen oscilar entre 1.000 y 10.000 dólares al mes, dependiendo del volumen de registros, el número de fuentes y las funciones activadas. Match Data Pro ofrece suscripciones mensuales sin contrato a largo plazo, por lo que los equipos pueden empezar con un plan básico e ir ampliándolo. Compárese esto con los 500.000-1,5 millones de dólares que costaría una solución a medida en tres años.
¿En qué casos resulta adecuado el enfoque híbrido para la resolución de entidades?
El modelo híbrido está justificado cuando se desarrolla un producto dirigido al cliente que requiere API personalizadas con la marca, o cuando el ámbito de aplicación exige una lógica de preprocesamiento que ninguna plataforma comercial admite de forma nativa. Para casos de uso internos relacionados con la calidad de los datos —deduplicación de CRM, gestión de datos maestros, análisis—, lo mejor es adquirir y configurar la solución. La vía híbrida supone una sobrecarga de ingeniería que rara vez aporta suficiente valor incremental como para justificar el coste.
¿Puede una plataforma de resolución de entidades SaaS gestionar datos específicos de un sector, como registros financieros o sanitarios?
Sí. Plataformas como Match Data Pro gestionan la correspondencia de entidades en todos los principales sectores mediante ponderaciones de campos configurables, claves de bloqueo personalizadas y algoritmos adecuados para cada ámbito. Los registros financieros utilizan la normalización de códigos ISIN y LEI. Los registros sanitarios utilizan un sistema de correspondencia de pacientes conforme a la HIPAA, basado en la evaluación de nombres, fechas de nacimiento y direcciones. La configuración sustituye a la mayor parte del trabajo de ingeniería específico de cada ámbito.
¿Qué es Senzing y por qué es importante para la resolución de entidades?
Senzing es un motor de resolución de entidades probabilístico basado en grafos que vincula registros a través de relaciones transitivas: si A coincide con B y B coincide con C, Senzing agrupa automáticamente los tres como una sola entidad. Está preentrenado con datos del mundo real y no requiere reglas definidas manualmente, lo que hace que su implementación sea considerablemente más rápida que la de los modelos probabilísticos personalizados. Match Data Pro integra Senzing de forma nativa para las cargas de trabajo de resolución de entidades empresariales.
¿Estás listo para probar la resolución de entidades con tus propios datos? Regístrate para obtener una prueba gratuita de Match Data Pro: sin compromiso ni necesidad de tarjeta de crédito. O solicita una demostración para que te guiemos por el proceso con tu caso de uso específico.