
La correspondencia de entidades es el proceso de determinar si dos o más registros, procedentes de conjuntos de datos distintos, se refieren al mismo objeto del mundo real. Responde a una pregunta: ¿es «Acme Corp., 123 Main St» en tu CRM la misma entidad que «ACME Corporation, 123 Main Street» en tu ERP? Sin un identificador común, la respuesta requiere el uso de algoritmos. Este artículo explica cómo funcionan esos algoritmos, en qué puntos fallan y cómo configurar un proceso que sea escalable.
Empieza una prueba gratuita de Match Data Pro y ejecuta tu primera tarea de comparación de entidades en cuestión de minutos.
¿Qué es la correspondencia de entidades y por qué fallan las uniones exactas?
La coincidencia exacta funciona cuando cada registro utiliza el mismo identificador único: un número de la Seguridad Social, un número DUNS o un UUID asignado en el momento de su creación. En la práctica, esa condición se cumple quizá en el 30-40 % de los datos empresariales. El resto procede de sistemas que nunca han compartido una clave. Un registro de cliente importado desde un formulario web, un registro de proveedor introducido manualmente en un ERP y un contacto enriquecido por un proveedor externo describen todos a la misma empresa, pero no comparten ningún identificador.
El resultado son registros duplicados y fragmentados. Una empresa con cinco oficinas podría aparecer como catorce entidades distintas en tu almacén de datos. Una clienta que haya cambiado de apellido al casarse se convierte en dos contactos distintos en tu CRM. Un proveedor registrado bajo tres nombres de filiales se asigna a tres categorías de gasto distintas en tu sistema de compras.
Las uniones exactas no detectan ninguno de estos casos. Los algoritmos de coincidencia de entidades sí lo hacen.
Emparejamiento determinístico frente a emparejamiento probabilístico
Los dos enfoques fundamentales para la correspondencia de entidades son el determinista y el probabilístico. La correspondencia determinista aplica reglas explícitas: si dos registros comparten el mismo NIF y el mismo número de teléfono, se consideran coincidentes. Es rápida y totalmente auditable, pero frágil. Basta con que se invierta un dígito en un número de teléfono para que se incumpla la regla.
La coincidencia probabilística asigna una puntuación de similitud ponderada en varios campos. Una similitud en el nombre de 0,92, sumada a una similitud en la dirección de 0,88 y a una similitud en el número de teléfono de 0,60, da como resultado una puntuación compuesta de, por ejemplo, 0,85, lo cual es suficiente para derivar el par a una coincidencia confirmada o a una cola de revisión. La mayoría de los procesos de producción combinan ambas cosas: las reglas determinísticas se encargan de los casos sencillos, mientras que la puntuación probabilística se ocupa de los ambiguos.
Los cuatro algoritmos principales utilizados en la correspondencia de entidades
No existe un único algoritmo que sirva para todos los tipos de campo. La tabla siguiente muestra qué algoritmos se aplican a cada tipo de datos.
| Algoritmo | Lo mejor para | Ejemplo | Umbral típico |
|---|---|---|---|
| Levenshtein (distancia de edición) | Cadenas cortas, códigos, nombres | «Smith» frente a «Smyth» → 0,80 | 0.80+ |
| Jaro-Winkler | Nombres con similitud en el prefijo | «Johnson» frente a «Johnston» → 0,93 | 0.88+ |
| Fonética (Soundex, Double Metaphone) | Nombres con variantes ortográficas | «Schmidt» frente a «Schmitt» → coinciden | Coincidencia exacta con la clave fonética |
| Basado en tokens (TF-IDF, Jaccard) | Nombres y direcciones de empresas | «Acme Corp Ltd» frente a «ACME Corporation» → 0,85 | 0.75+ |
La elección del algoritmo es tan importante como el umbral. El algoritmo de Levenshtein, aplicado a un campo de nombre de empresa, penalizará las diferencias en el orden de las palabras, algo que los métodos basados en tokens gestionan bien. El algoritmo de Jaro-Winkler, aplicado a un campo de dirección, premiará en exceso a los registros que compartan un prefijo de número de calle. Aplicar el algoritmo adecuado al tipo de campo adecuado reduce significativamente los falsos positivos y los falsos negativos.
Puntuación compuesta: combinación de algoritmos de distintos campos
La coincidencia de entidades de producción utiliza una puntuación compuesta. Cada campo tiene su propio algoritmo y ponderación. Un campo de nombre podría tener una ponderación de 0,40, un campo de dirección de 0,30, un número de teléfono de 0,20 y un dominio de correo electrónico de 0,10. La media ponderada de las puntuaciones de cada campo da como resultado una única probabilidad de coincidencia para el par.
El motor de coincidencia aproximada basado en inteligencia artificial de Match Data Pro te permite configurar la ponderación de los campos y seleccionar el algoritmo según el tipo de campo. La plataforma muestra los pares de coincidencias sugeridos por la IA junto con sus puntuaciones de confianza, de modo que puedas ver exactamente qué campos han determinado una decisión de coincidencia antes de aprobarla. Esa transparencia es lo que distingue a las plataformas configurables de las herramientas de «caja negra».
El proceso de resolución de entidades: seis etapas
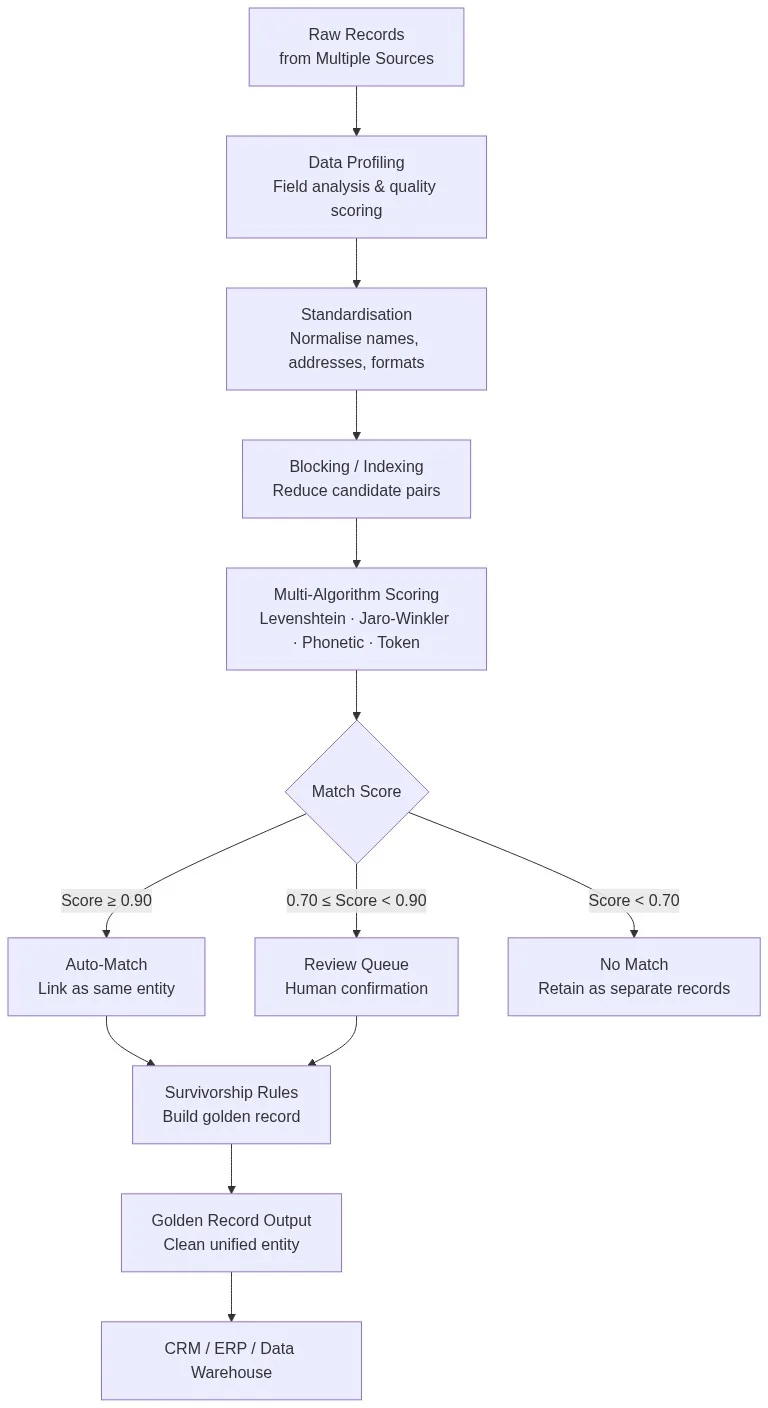
Un proceso fiable de correspondencia de entidades consta de seis etapas. Si se omite cualquiera de ellas, se reduce la recuperación o la precisión.
Fase 1: Perfilado de datos
Antes de que se lleve a cabo cualquier proceso de emparejamiento, el análisis de perfiles de datos de IA comprueba todos los campos para verificar que estén completos, que el formato sea coherente y que la distribución de valores sea adecuada. Un campo con un 40 % de valores nulos requiere un tratamiento diferente al de uno con un 99 % de datos rellenados. El análisis de perfiles pone de manifiesto estas deficiencias para que puedas asignar una menor ponderación a los campos incompletos o excluirlos por completo de la puntuación.
Fase 2: Normalización
Los registros sin procesar llegan con un formato inconsistente. «Street» aparece como «St», «St.» y «Street». Los sufijos de las empresas aparecen como «Inc», «Inc.», «Incorporated» y «Corp». Un proceso de estandarización normaliza estas variaciones antes de la puntuación, de modo que dos registros que representan a la misma entidad obtengan una puntuación alta en lugar de ser penalizados únicamente por las diferencias de formato.
El motor de limpieza y estandarización de datos de Match Data Pro se encarga de la normalización de los sufijos de las empresas, el análisis sintáctico de los nombres (nombre, apellidos y segundo nombre), el análisis sintáctico de los componentes de la dirección y el formateo de los números de teléfono de forma automática, como parte de un proceso continuo.
Etapa 3: Bloqueo
Comparar cada registro con todos los demás registros de un conjunto de datos de un millón de filas supone 500.000 millones de pares posibles. Esto resulta computacionalmente imposible a esa escala. El bloqueo reduce el espacio de posibilidades agrupando los registros que comparten al menos un atributo: los tres primeros caracteres de un nombre, el código postal o el prefijo telefónico. Solo se comparan los registros que pertenecen al mismo bloque.
Una estrategia de filtrado bien diseñada conserva más del 99 % de las coincidencias reales, al tiempo que elimina más del 95 % de las no coincidencias del conjunto de comparación. Match Data Pro utiliza un filtrado adaptativo que combina varias claves de filtrado, lo que reduce las coincidencias omitidas causadas por fallos en el filtrado basado en un único atributo.
Fase 4: Puntuación mediante múltiples algoritmos
Cada par de candidatos dentro de un bloque se puntúa en todos los campos configurados utilizando el algoritmo adecuado para cada campo. El resultado es una puntuación compuesta comprendida entre 0 y 1. Los registros con una puntuación superior al umbral de coincidencia automática se vinculan de inmediato. Los registros que se sitúan en una banda intermedia pasan a una cola de revisión. Los registros por debajo del umbral de no coincidencia se mantienen separados.
Etapa 5: Normas para los supervivientes
Cuando dos registros coinciden, se necesita un «registro canónico» único. Las reglas de prevalencia determinan qué valor de campo prevalece. Entre las reglas más habituales se incluyen: el valor actualizado más recientemente, el más completo, el que aparece con mayor frecuencia o la prioridad del sistema de origen. Match Data Pro te permite configurar las reglas de prevalencia a nivel de campo de forma independiente, de modo que el CRM prevalezca en el nombre del contacto, pero el ERP prevalezca en la dirección de facturación, sin que ninguno de los dos registros sobrescriba todos los campos del otro.
Etapa 6: Producción del «Disco de Oro»
El resultado es un registro limpio y completo: una entidad unificada por cada objeto del mundo real, con un historial que muestra qué registros de origen han aportado cada valor de campo. Este registro se transfiere a tu CRM, ERP, almacén de datos o capa de análisis a través de los conectores de importación y exportación de Match Data Pro.
Retos de la correspondencia de entidades en el mundo real
Hay varias categorías de datos que plantean dificultades persistentes a la hora de realizar la correspondencia.
Variantes del nombre y apodos
Una persona llamada «William» puede aparecer como «Bill», «Will» o «Billy» en los distintos sistemas de origen. Los algoritmos estándar de distancia de edición otorgan una puntuación baja a la comparación entre «William» y «Bill»: 0,44 según el algoritmo de Levenshtein. Los algoritmos fonéticos y las tablas de búsqueda de apodos resuelven este problema. Match Data Pro aplica la expansión de apodos configurable como paso de preprocesamiento antes de la puntuación.
Dígitos intercambiados y errores de OCR
Un número de teléfono como «555-1234» frente a «555-1243» tiene una puntuación de Levenshtein de 0,88: una transposición de dos dígitos adyacentes. Un código postal «90210» frente a «90201» parece no coincidir en una comparación exacta, pero obtiene una puntuación de 0,89 en la distancia de edición normalizada. Los procesos de coincidencia de entidades necesitan que se incorpore tolerancia a la transposición de dígitos en la puntuación de los campos numéricos.
Formatos de direcciones internacionales
La estandarización de direcciones que funciona para los registros estadounidenses no se adapta a los formatos internacionales. En el Reino Unido, el código postal aparece después de la ciudad. En las direcciones japonesas, la provincia va primero. En Alemania, los números de las calles van después del nombre de la calle. La comparación de direcciones a gran escala requiere un análisis sintáctico que tenga en cuenta los formatos, no un único patrón de expresión regular.
Variaciones del nombre de la empresa
Una misma empresa puede aparecer como «Acme Corp», «Acme Corporation», «ACME Corp.», «Acme Corp Ltd» y «Acme (UK) Ltd» en los distintos conjuntos de datos. Los algoritmos basados en tokens que eliminan las palabras vacías —suprimiendo «Ltd», «Inc» y «Corp» antes de la puntuación— mejoran significativamente la recuperación en la coincidencia de nombres de empresas.
Coincidencia de entidades frente a resolución de entidades: la diferencia
La coincidencia de entidades determina si dos registros concretos se refieren al mismo objeto. La resolución de entidades va más allá: agrupa todos los registros coincidentes de un conjunto de datos completo en clústeres, un clúster por cada entidad del mundo real. La resolución de entidades es la coincidencia de entidades aplicada a escala de conjunto de datos, con agrupamiento basado en grafos para gestionar las coincidencias transitivas.
Si el registro A coincide con el registro B, y el registro B coincide con el registro C, la resolución de entidades sabe que A, B y C son la misma entidad, incluso aunque A y C no superen directamente el umbral de coincidencia. Match Data Pro integra la resolución de entidades de Senzing, un motor probabilístico basado en grafos que gestiona precisamente este problema de vinculación transitiva a un ritmo de millones de registros por hora.
¿Estás listo para ver cómo funciona la correspondencia de entidades con tus propios datos? Reserva una demostración con el equipo de Match Data Pro o inicia hoy mismo una prueba gratuita para ejecutar una tarea de correspondencia con tus propios registros.
Preguntas frecuentes
¿Qué es la correspondencia de entidades en la gestión de datos?
La correspondencia de entidades es el proceso de identificar registros en conjuntos de datos independientes que hacen referencia al mismo objeto del mundo real —una persona, una empresa o una dirección— sin depender de un identificador único compartido. Utiliza algoritmos de similitud para puntuar pares de registros y genera registros vinculados o fusionados, lo que permite realizar análisis precisos y obtener un conjunto de datos maestro limpio.
¿Qué algoritmos se utilizan para la correspondencia de entidades?
Los algoritmos más habituales son la distancia de edición de Levenshtein para cadenas cortas y códigos, el algoritmo de Jaro-Winkler para nombres, algoritmos fonéticos como Double Metaphone para la detección de variantes de nombres, y métodos basados en tokens, como la similitud de Jaccard y el coseno TF-IDF, para campos formados por varias palabras, como nombres de empresas y direcciones. Los procesos de producción utilizan combinaciones de estos algoritmos con ponderaciones específicas para cada campo.
¿En qué se diferencia la correspondencia de entidades de la deduplicación?
La deduplicación elimina los registros duplicados dentro de un mismo conjunto de datos. La correspondencia de entidades vincula registros de distintos conjuntos de datos que representan la misma entidad del mundo real. La deduplicación suele ser un paso dentro de un proceso de correspondencia o resolución de entidades, y no un sustituto del mismo cuando se trabaja con varios sistemas de origen.
¿Qué es una estrategia de bloqueo en la correspondencia de entidades?
El bloqueo reduce el número de pares de registros que deben evaluarse agrupando aquellos que comparten al menos un atributo común, como los primeros caracteres de un nombre, un código postal o un prefijo telefónico. Solo se comparan los registros que pertenecen al mismo bloque, lo que reduce el número de pares posibles de miles de millones a millones sin mermar significativamente la recuperación de coincidencias.
¿Cómo puedo saber si los umbrales de coincidencia de mis entidades son correctos?
La calibración del umbral requiere pares de datos de referencia etiquetados, es decir, registros de los que se sabe que coinciden o no coinciden. Ejecuta tu proceso de puntuación con esos pares y, a continuación, mide la precisión y la recuperación con diferentes valores de umbral. Un umbral que ofrezca una precisión del 95 % con una recuperación del 90 % es un punto de partida razonable para la mayoría de los conjuntos de datos empresariales. Ajusta primero las ponderaciones de los campos antes de modificar el umbral global.