
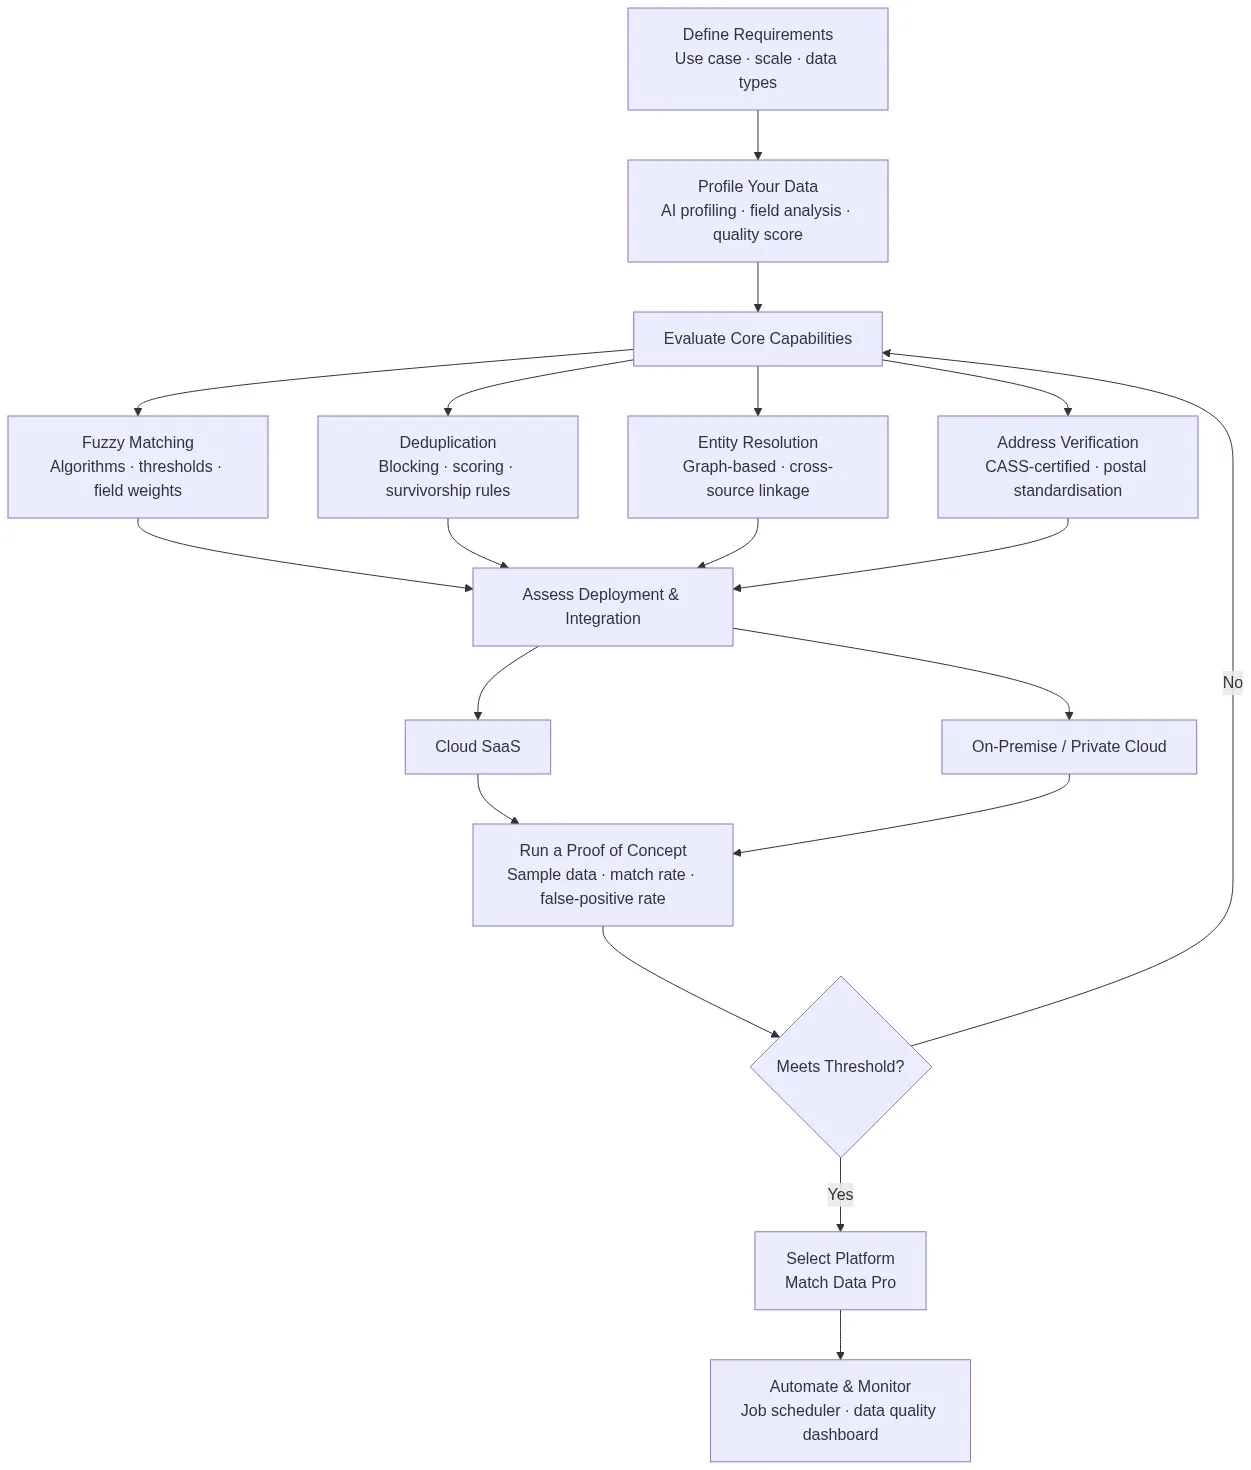
La herramienta adecuada de cotejo de datos elimina los registros duplicados, vincula identidades entre sistemas y proporciona datos limpios a todos los procesos posteriores. Una herramienta inadecuada supone un desperdicio de meses de trabajo de integración y genera índices de coincidencia inferiores al 70 %. Este marco ofrece a los equipos de datos de las empresas un método repetible, dividido en cinco etapas, para evaluar, comparar y seleccionar una plataforma de cotejo de datos que se adapte a su carga de trabajo real.
¿Estás listo para ver cómo rinden tus datos? Empieza una prueba gratuita de Match Data Pro y realiza una prueba de concepto real con tus propios registros.
Por qué fracasa la evaluación de las herramientas de cotejo de datos
La mayoría de los equipos evalúan las herramientas en función de sus características, no de los resultados. En las demostraciones de los proveedores se utilizan datos de muestra limpios y seleccionados. Tus datos de producción contienen variantes de apodos, dígitos invertidos, campos que faltan y abreviaturas de direcciones que desbaratan una lógica de coincidencia simplista.
Una encuesta de Gartner de 2024 reveló que el 60 % de los proyectos de integración de datos no lograron cumplir los objetivos de precisión en la correspondencia de datos. La causa principal, en la mayoría de los casos, fue una falta de adecuación entre la plataforma seleccionada y las características reales de calidad de los datos de los sistemas de origen.
Tres errores habituales en la evaluación:
- Realizar la evaluación con demos depuradas: pide a los proveedores que comparen una muestra de 10 000 registros de tus propios datos, no de los suyos.
- Priorizar la interfaz de usuario frente a los algoritmos: una interfaz sencilla oculta si los algoritmos de emparejamiento subyacentes admiten ponderaciones configurables y puntuaciones en varios campos.
- Si se omiten las pruebas de escalabilidad, las herramientas que procesan 50 000 registros en un minuto pueden quedarse atascadas durante horas al llegar a los 50 millones.
Fase 1: Define tus necesidades antes de probar una demo
Anota tus requisitos antes de ponerte en contacto con cualquier proveedor. Los requisitos deben abarcar cuatro ámbitos.
Volumen y velocidad de los datos
¿Cuántos registros necesitas cotejar? ¿Los cotejos se realizan por lotes (nocturnos, semanales) o en tiempo real (API, punto de entrada)? Un equipo de CRM que procesa 500 000 registros de clientes a la semana tiene necesidades diferentes a las de una entidad financiera que identifica entidades en 40 millones de transacciones al día.
Tipos de datos y complejidad de los campos
Los campos de nombre requieren algoritmos fonéticos y de distancia de edición. Los campos de dirección necesitan análisis postal y verificación de direcciones mediante CASS. Los nombres de empresas requieren una comparación basada en tokens que tenga en cuenta las variantes «Corp», «Inc» y «LLC». Los campos de texto libre deben normalizarse antes de aplicar cualquier puntuación.
Número de sistemas de origen
La comparación de dos listas es más sencilla que resolver identidades en seis sistemas de origen sin una clave compartida. La comparación entre fuentes requiere una estrategia de bloqueo, una puntuación compuesta y reglas de supervivencia para fusionar los registros coincidentes en un registro de referencia.
Requisitos normativos y de auditoría
Los sectores regulados —servicios financieros, sanidad, seguros— necesitan un registro de auditoría completo para cada decisión de coincidencia. Cada puntuación, cada peso del algoritmo y cada acción de fusión deben ser trazables. Evalúa si la plataforma registra las decisiones de coincidencia de forma predeterminada o si requiere una configuración personalizada.
Fase 2: Analiza tus datos antes de evaluarlos
Antes de evaluar cualquier herramienta, analiza el perfil de tus datos de origen. El análisis de perfil de datos mediante IA examina cada campo para comprobar su integridad, la coherencia del formato, la distribución de los valores y los patrones de anomalías. El resultado te indica exactamente qué problemas de calidad de los datos debe resolver tu proceso de cotejo.
Un análisis de perfiles realizado en un CRM B2B típico revela lo siguiente:
- Entre el 15 % y el 25 % de los campos de nombre de empresa contienen abreviaturas, variantes ortográficas o truncamientos.
- Entre el 8 % y el 12 % de los números de teléfono tienen dígitos invertidos o les faltan prefijos
- Entre el 10 % y el 18 % de los campos de dirección contienen sufijos de unidades no estándar (Ste, Suite o #).
- Entre el 4 % y el 7 % de los registros tienen los campos de correo electrónico en blanco, pero los de teléfono son válidos
Este perfil indica directamente qué capacidades algorítmicas debe tener la herramienta. Una plataforma que no pueda gestionar la lógica de alternativa a nivel de campo —como buscar coincidencias en el número de teléfono cuando el campo de correo electrónico está en blanco— fallará en una parte significativa de tus registros antes incluso de que concluya la evaluación.
Fase 3: Evaluar las capacidades básicas de correspondencia
Es en este punto donde la mayoría de las evaluaciones dedican muy poco tiempo. La capacidad básica de coincidencia es lo que distingue a las herramientas que alcanzan una tasa de coincidencia del 72 % de las que alcanzan una del 94 %.
Cobertura del algoritmo de coincidencia aproximada
La búsqueda aproximada no es un único algoritmo. Cada tipo de campo requiere un enfoque diferente:
- Levenshtein / distancia de edición: ideal para códigos cortos, identificadores de productos y partes locales de direcciones de correo electrónico
- Jaro-Winkler: optimizado para nombres propios en los que las primeras letras son más importantes
- Fonética (Soundex, Metaphone): gestiona las variantes de los apellidos: «Smith» frente a «Smyth»
- Basado en tokens (TF-IDF, coseno): gestiona las variantes del nombre de la empresa: «Acme Corp» frente a «ACME Corporation»
Pregunta a los proveedores: ¿puedo configurar un algoritmo diferente para cada campo? ¿Puedo establecer ponderaciones por campo para que una coincidencia de correo electrónico tenga mayor peso que una coincidencia de código postal? ¿Puedo establecer umbrales de confianza que deriven los pares con baja confianza a una revisión manual?
Profundidad del proceso de deduplicación
Evalúa todo el proceso de deduplicación de datos, no solo la fase de comparación. Un proceso completo incluye: agrupación en bloques (para reducir el número de pares de comparación de N² a un número manejable), puntuación, enrutamiento por umbrales, reglas de supervivencia para la fusión a nivel de campo y la exportación a un almacén de registros de referencia.
Resolución de entidades entre distintas fuentes
Si realizas la comparación entre más de dos sistemas de origen, necesitas una resolución de entidades basada en grafos, no solo una deduplicación por pares. La comparación por pares pasa por alto las coincidencias transitivas: el registro A coincide con el registro B, el registro B coincide con el registro C, pero el registro A nunca se relaciona directamente con el registro C. La resolución de entidades agrupa los tres en una única identidad verificada.
Fase 4: Evaluar la implantación, la integración y el coste total
Modelo de implementación
El SaaS en la nube se implementa en cuestión de horas y no requiere ninguna inversión en infraestructura. La implementación local o en la nube privada ofrece a los equipos que dan prioridad a la seguridad el control total sobre los datos. Evalúa ambas opciones en función de tu política de gobernanza de datos. Nuestra guía de opciones de implementación describe en detalle las ventajas e inconvenientes de cada una.
Conectores de integración
¿Cómo entran y salen los datos? Los conectores nativos con Salesforce, HubSpot, SAP y Snowflake reducen el esfuerzo de integración. El acceso a la API REST permite la comparación en tiempo real en el punto de entrada, algo fundamental para los flujos de trabajo de creación de registros de CRM, en los que se desea bloquear los duplicados antes de que entren en el sistema, en lugar de tener que eliminarlos después.
Coste total de propiedad
Los precios de los proveedores rara vez reflejan toda la realidad. Hay que sumar: la cuota de licencia (por puesto, por registro o una cuota mensual fija), los servicios profesionales de configuración, el tiempo de los ingenieros internos dedicado al mantenimiento de las reglas personalizadas y los costes de infraestructura si se aloja en propio. Nuestro análisis comparativo entre «desarrollar» y «comprar» muestra que las soluciones de cotejo internas cuestan entre 300 000 y 800 000 dólares a lo largo de tres años cuando se tiene plenamente en cuenta el tiempo de ingeniería. Una plataforma SaaS con precios mensuales y sin contrato elimina ese riesgo.
Etapa 5: Realiza una prueba de concepto con tus propios datos
Ninguna evaluación está completa sin una prueba de concepto (PoC) realizada con una muestra representativa de tus datos reales. Utiliza entre 50 000 y 100 000 registros extraídos de tu conjunto de datos de producción. Entrega la misma muestra a todos los proveedores que estés evaluando.
Mide cuatro resultados de la prueba de concepto:
- Índice de coincidencias: ¿qué porcentaje de duplicados reales ha detectado la herramienta?
- Tasa de falsos positivos: ¿cuántos pares no duplicados se marcaron erróneamente?
- Tiempo de procesamiento: ¿cuánto tiempo duró la ejecución y es escalable a un volumen 10 veces mayor?
- Esfuerzo de configuración: ¿cuántas horas dedicó tu equipo a ajustar los umbrales hasta que se obtuvieron resultados aceptables?
Una buena plataforma debería alcanzar una tasa de coincidencia superior al 90 % con datos limpios y superior al 80 % con datos sin procesar en una prueba de concepto. Las tasas de falsos positivos superiores al 5 % indican que el algoritmo es demasiado permisivo y provocará errores de fusión en producción.
Match Data Pro ofrece una prueba gratuita en members.matchdatapro.com: carga tus propios datos y realiza una prueba de concepto completa en cuestión de horas, no de semanas. Sin contrato y sin necesidad de configurar ninguna infraestructura.
¿Quieres repasar el proceso de evaluación con un ingeniero de calidad de datos? Reserva una demostración y realizaremos juntos la prueba de concepto (PoC) con tus datos.
Preguntas frecuentes
¿Qué es un programa de cotejo de datos y para qué sirve?
El software de cotejo de datos identifica los registros que hacen referencia a la misma entidad del mundo real en uno o varios conjuntos de datos, utilizando algoritmos de puntuación difusa, estrategias de bloqueo y reglas de supervivencia para fusionar los duplicados en un único registro de referencia. Se utiliza para la deduplicación de CRM, la resolución de entidades, la vinculación de registros y los programas de gestión de datos maestros.
¿Cómo puedo evaluar las herramientas de cotejo de datos sin un identificador común para todos los sistemas?
Evalúa las capacidades de bloqueo y puntuación difusa de la plataforma. Una herramienta que no pueda realizar coincidencias sin una clave compartida debe puntuar la similitud combinada de los campos de nombre, dirección, teléfono y correo electrónico de forma simultánea. Realiza una prueba de concepto (PoC) con tus datos reales que contengan duplicados conocidos para medir la tasa de coincidencias y la tasa de falsos positivos antes de decidirte por una plataforma.
¿Qué porcentaje de coincidencias puedo esperar de una herramienta de comparación de datos?
Las plataformas de nivel empresarial suelen alcanzar una tasa de coincidencia del 85-95 % con datos estandarizados. En el caso de registros sin procesar y no estandarizados, la tasa desciende al 70-85 % sin un procesamiento previo. La aplicación de un paso automatizado de limpieza y estandarización de datos antes de la coincidencia eleva de forma sistemática las tasas de coincidencia por encima del 90 %, incluso con datos de origen desordenados.
¿Cuál es la diferencia entre la deduplicación y la resolución de entidades?
La deduplicación elimina los registros duplicados dentro de un mismo conjunto de datos mediante comparaciones por pares. La resolución de entidades vincula registros de múltiples sistemas de origen mediante agrupaciones basadas en grafos, gestionando así las coincidencias transitivas que la deduplicación por pares no detecta. La mayoría de los programas de calidad de datos empresariales necesitan ambas cosas: deduplicación dentro de cada fuente y, a continuación, resolución de entidades entre fuentes.
¿Cuánto tiempo lleva realizar una prueba de concepto de una herramienta de cotejo de datos?
Una prueba de concepto (PoC) estructurada con entre 50 000 y 100 000 registros tarda entre 2 y 5 días laborables de principio a fin: un día para cargar y perfilar los datos, entre uno y dos días para ajustar los umbrales y un día para revisar los resultados. Las plataformas SaaS en la nube con conectores preconfigurados reducen este tiempo a unas pocas horas. Las implementaciones locales añaden el tiempo de configuración de la infraestructura, que suele suponer entre 3 y 10 días laborables adicionales.