
Conectar un modelo de lenguaje grande (LLM) o un agente de IA a los datos de la empresa sin limpiarlos previamente es la forma más rápida de corromper los resultados de la IA. La solución es un proceso estructurado de control de calidad de datos que analice, limpie, deduplique y resuelva los registros para crear un «golden master» antes de que cualquier flujo de trabajo de IA los procese. Match Data Pro ofrece todas las etapas de ese proceso en una única plataforma SaaS en la nube, para que tu modelo de lenguaje grande (LLM) recupere registros precisos y unificados en todo momento.
Reserva una demostración para ver cómo Match Data Pro limpia y conecta tus datos para los flujos de trabajo de IA.
Por qué los flujos de trabajo de los modelos de lenguaje grande (LLM) dependen de la calidad de los datos
Los modelos de lenguaje a gran escala no evalúan la calidad de los datos. Procesan cualquier contexto que reciban y generan resultados basándose en él. Cuando ese contexto contiene registros de clientes duplicados, nombres de empresas incoherentes o direcciones en tres formatos diferentes, el modelo no puede distinguir entre un registro válido y uno erróneo. Genera una respuesta con seguridad basándose en datos contradictorios.
Imaginemos un proceso de generación aumentada por recuperación (RAG) que extrae registros de clientes para responder a una consulta de atención al cliente. Si el mismo cliente figura como «Acme Corp», «ACME Corporation» y «Acme Inc.» en tres sistemas de origen distintos, la fase de recuperación devuelve tres registros parciales. El modelo de lenguaje grande (LLM) fusiona los campos contradictorios, inventa una respuesta compuesta y ofrece una respuesta que no satisface a nadie.
La solución no es una indicación mejor. Es una capa de datos más limpia subyacente al modelo.
Hay tres fallos en la calidad de los datos que son los responsables de la mayoría de los errores en los resultados de la IA:
- Duplicados. La existencia de varios registros para una misma entidad genera señales contradictorias.
- Formato inconsistente. «NY», «New York» y «new york» son idénticos para una persona, pero para un modelo son elementos distintos.
- Valores ausentes o nulos. Un modelo al que se le pide que resuma un registro con un 40 % de campos nulos genera un resumen inventado.
El proceso de seis etapas para la calidad de los datos con vistas a la preparación para la IA
La creación de una base de datos limpia para los flujos de trabajo de los modelos de lenguaje a gran escala (LLM) y la inteligencia artificial (IA) requiere seis etapas secuenciales. Saltarse cualquier etapa da lugar a un tipo de errores que se acumulan en las etapas posteriores.
Fase 1: Perfilado de datos
El perfilado mide lo que tienes antes de corregirlo. Cuantifica las tasas de valores nulos por campo, detecta inconsistencias de formato, identifica valores atípicos y señala fallos de integridad referencial. Sin el perfilado, la limpieza de datos se basa en conjeturas. El perfilado de datos impulsado por IA de Match Data Pro analiza los conjuntos de datos cargados y genera un informe de calidad estructurado que abarca la integridad, la unicidad y la conformidad con el formato.
Un análisis de perfil de una exportación de CRM de 500 000 filas podría revelar lo siguiente: un 12 % de direcciones de correo electrónico nulas, un 8 % de números de teléfono que no siguen el formato E.164 y 3 400 variantes de nombres de empresas que probablemente correspondan a menos de 200 entidades jurídicas distintas.
Fase 2: Limpieza y estandarización de datos
La limpieza corrige los valores. La estandarización los normaliza a un formato coherente. Ambas son necesarias antes de la comparación.
Ejemplos prácticos de normalización para la preparación en materia de IA:
- Nombres de empresas: «IBM Corp.», «I.B.M.», «International Business Machines» → forma canónica «IBM»
- Números de teléfono: «+1 (212) 555-0100», «2125550100», «212.555.0100» → E.164 «+12125550100»
- Códigos de los estados: «California», «Calif.», «CA» → «CA»
- Fechas: «20/09/2026», «20 de septiembre de 2026», «2026-09-20» → ISO 8601 «2026-09-20»
El proceso de limpieza de datos de Match Data Pro aplica reglas de transformación configurables a todos los tipos de campos. Las reglas se ejecutan por lotes sobre conjuntos de datos completos o en tiempo real a través de la API en directo.
Etapa 3: Desduplicación y coincidencia aproximada
Tras la estandarización, es necesario identificar y fusionar los registros que representan a la misma entidad del mundo real. La coincidencia exacta no detecta los casi duplicados: «Jon Smith en Acme» y «Jonathan Smith en Acme Corp» son la misma persona, pero no comparten ningún valor de campo idéntico.
Los algoritmos de coincidencia aproximada —Jaro-Winkler, Levenshtein, fonéticos y basados en tokens— evalúan la similitud entre pares en varios campos de forma simultánea. Una puntuación combinada superior a un umbral configurado activa una coincidencia. El motor de Match Data Pro evalúa cada par candidato campo por campo, aplica ponderaciones configurables y devuelve una lista ordenada de candidatos a coincidencia con un registro de auditoría completo.
En el ámbito de la IA, la deduplicación cumple una función específica: garantiza que una consulta de recuperación devuelva un único registro de referencia, en lugar de tres registros parciales. Un proceso RAG que recupere un único registro de referencia es más preciso que uno que recupere tres versiones contradictorias y pida al modelo que las concilie.
Fase 4: Resolución de entidades
La deduplicación se lleva a cabo dentro de un único conjunto de datos. La resolución de entidades vincula registros de varios sistemas de origen que no comparten ningún identificador común.
Match Data Pro integra la resolución de entidades de Senzing, un motor probabilístico basado en grafos que vincula registros de sistemas de CRM, ERP, automatización de marketing y atención al cliente. El resultado es un grafo de entidades unificado: cada aparición de «Acme Corp» en todos los sistemas se resuelve en un único identificador de entidad.
En el caso de los flujos de trabajo de modelos de lenguaje grande (LLM) que extraen contexto de varios sistemas, esto resulta fundamental. La fase de recuperación del modelo puede consultar un único identificador de entidad y obtener un registro completo y sin contradicciones, en lugar de una visión fragmentada procedente de varios sistemas.
Fase 5: Verificación de la dirección
Los datos de direcciones son especialmente propensos a la degradación. Los campos se rellenan de forma libre, se abrevian de manera inconsistente y rara vez se validan en el momento de su introducción. En los flujos de trabajo de IA que se basan en la ubicación —optimización logística, asignación de territorios, jurisdicción normativa—, los errores en las direcciones afectan directamente a los resultados.
Match Data Pro incluye una verificación de direcciones certificada por CASS que analiza, estandariza y valida las direcciones postales de EE. UU. comparándolas con la base de datos del USPS, añadiendo los códigos ZIP+4 y corrigiendo los errores de introducción de datos más habituales. Las direcciones estandarizadas también mejoran las tasas de coincidencia en las rondas posteriores de deduplicación, ya que los campos de dirección presentan un formato coherente.
Etapa 6: Disco de Oro y resultados
El resultado del proceso es un «registro de referencia»: una representación única, fidedigna y sin conflictos de cada entidad del mundo real. Las reglas de prevalencia determinan qué valor de campo prevalece cuando los registros de origen no coinciden: el más reciente, el más completo o el de mayor fiabilidad. El motor de fusión y prevalencia de Match Data Pro aplica estas reglas automáticamente y documenta cada decisión.
El «disco de oro» es lo que recibe tu LLM, tu agente de IA o tu herramienta de análisis. Se trata de datos limpios, sin duplicados, con las entidades identificadas y las direcciones verificadas.
Conexión de la capa de datos limpios a los flujos de trabajo de los modelos de lenguaje a gran escala (LLM)
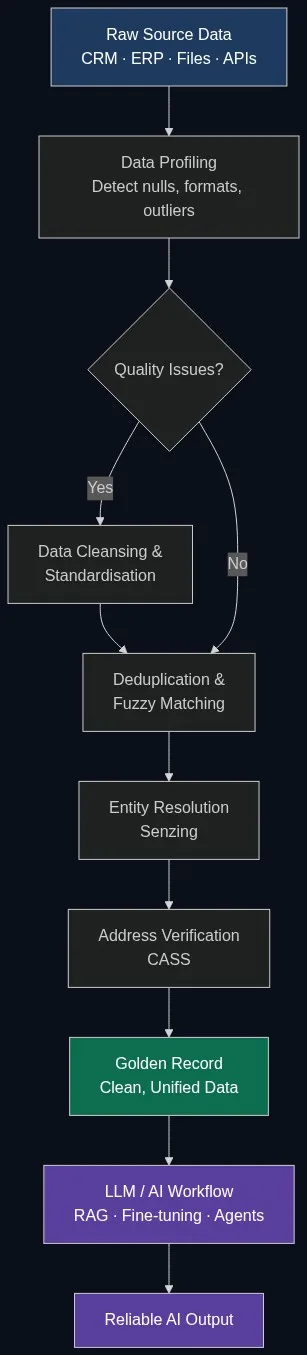
Una vez que se dispone de registros de referencia, es necesario que lleguen a tu flujo de trabajo de IA de forma eficiente. Match Data Pro admite tres modelos de integración:
Exportación por lotes a un almacén vectorial o a una base de conocimientos
Exporta registros limpios y optimizados en formato CSV, JSON o mediante un conector directo a tu almacén de datos. Importa esos registros a un almacén vectorial (Pinecone, Weaviate, pgvector) para alimentar los flujos de trabajo de RAG. Dado que cada registro está deduplicado y se ha resuelto su entidad, la búsqueda semántica devuelve un único resultado limpio por cada consulta de entidad, en lugar de múltiples fragmentos contradictorios.
API de búsqueda difusa en tiempo real
La API de búsqueda difusa en tiempo real de Match Data Pro permite que cualquier agente de IA o integración de LLM consulte tus datos depurados en tiempo real. Un agente puede enviar una cadena de entidad no estructurada —«ibm corp new york»— y recibir a cambio el registro de referencia que coincida, junto con una puntuación de confianza, sin necesidad de una clave exacta. Esto resulta especialmente útil para flujos de trabajo basados en agentes que reciben referencias a entidades en lenguaje natural no estructuradas.
Flujos de trabajo automatizados
La calidad de los datos no es algo puntual. Cada día se incorporan nuevos registros a tus sistemas y la calidad se deteriora continuamente. La automatización de tareas de Match Data Pro ejecuta todo el proceso según un calendario preestablecido —perfilado, limpieza, deduplicación, resolución de entidades y exportación— para que tu capa de IA siempre recupere información de un conjunto de datos actualizado y limpio. No se requiere ninguna intervención manual entre ejecuciones.
Ejemplo práctico: proceso RAG con datos de CRM
Un equipo de operaciones de ventas crea un flujo de trabajo RAG para que su asistente de IA pueda responder a preguntas sobre las cuentas de los clientes. Los datos de origen son una exportación del CRM con 1,2 millones de registros que presenta problemas de calidad conocidos.
Antes del proceso de control de calidad de los datos:
- La misma cuenta figura como «Acme Corp», «Acme Corporation» y «ACME» en tres divisiones.
- El contacto principal, «Jon Smith», también aparece como «Jonathan Smith» y «J. Smith».
- Campo de dirección: «123 Main St Suite 4B», «123 Main Street, Ste 4B», «123 Main St, n.º 4B»
Consulta al asistente de IA: «¿Cuál es el valor total de los contratos de Acme Corp?» Resultado: se han recuperado tres registros parciales; el modelo suma un subconjunto de contratos y devuelve un total incorrecto.
Proceso de «After Match Data Pro»:
- Las tres variantes de Acme se resolvieron con el identificador de entidad E-00481 mediante la resolución de entidades de Senzing.
- Tres variantes de contacto fusionadas en un único registro de referencia: «Jonathan Smith»
- Dirección estandarizada mediante CASS como «123 Main St, Ste 4B, [Ciudad], [Estado] [Código postal+4]»
Consulta al asistente de IA: «¿Cuál es el valor total del contrato de Acme Corp?» Resultado: se ha recuperado un registro de entidad, se ha devuelto el historial completo del contrato y se ha calculado el total correcto.
Qué hay que tener en cuenta a la hora de elegir una plataforma de calidad de datos para la IA
A la hora de evaluar las plataformas que servirán de base para tu capa de datos de IA, ten en cuenta los siguientes criterios:
- Integridad del proceso. La creación de perfiles, la limpieza de datos, la deduplicación, la resolución de entidades y la verificación de direcciones deben estar disponibles en una única plataforma. La combinación de cinco herramientas independientes aumenta los puntos de fallo.
- Acceso a la API. Tus flujos de trabajo de IA necesitan consultar datos limpios mediante programación. Una API de búsqueda aproximada en tiempo real no es opcional.
- Configurabilidad. Los umbrales de coincidencia, las reglas de supervivencia y la lógica de transformación deben poder ajustarse sin necesidad de modificar el código.
- Automatización. Las ejecuciones manuales no son escalables. Se necesitan flujos de trabajo programados para mantener actualizada la capa limpia.
- Sin compromiso de permanencia. El modelo SaaS mensual sin contrato a largo plazo te permite empezar de inmediato y ampliar tus servicios sin compromiso.
Match Data Pro cumple los cinco criterios. Empieza una prueba gratuita y ejecuta tu primer proceso de control de calidad de datos en menos de una hora: sin contrato y sin necesidad de recursos informáticos.
Preguntas frecuentes
¿Qué es la calidad de los datos de los modelos de lenguaje grande (LLM) y por qué es importante?
La calidad de los datos de un modelo de lenguaje grande (LLM) hace referencia a la precisión, la exhaustividad, la coherencia y la unicidad de los datos que un LLM recupera o con los que se entrena. Es importante porque los LLM no validan las entradas: generan resultados basándose en cualquier contexto que reciban. Los datos erróneos producen resultados que parecen fiables, pero que son incorrectos. Limpiar los datos en las fases iniciales es la única forma fiable de mejorar la precisión de la IA desde el origen.
¿En qué consiste una base de datos limpia para la IA?
Una base de datos limpia es un conjunto de datos deduplicado, estandarizado y con resolución de entidades que sirve como única fuente de información fiable para la recuperación y la generación de datos mediante IA. Se crea sometiendo los datos brutos de origen a procesos de perfilado, limpieza, coincidencia aproximada, resolución de entidades y verificación de direcciones antes de que cualquier sistema de IA los consulte.
¿Cómo se conecta un proceso RAG para depurar los datos de la empresa?
Procesa tus datos de origen a través de un flujo de trabajo de calidad de datos para generar registros de referencia. Exporta esos registros a un almacén vectorial o a una base de conocimiento. Configura el paso de recuperación de RAG para realizar consultas en el almacén depurado. Para las consultas en tiempo real, utiliza una API de búsqueda difusa en tiempo real que compare cadenas de texto de entidades no estructuradas con los registros de referencia y devuelva resultados puntuados.
¿Es necesario que el control de calidad de los datos se ejecute de forma continua en los flujos de trabajo de IA?
Sí. Cada día se introducen nuevos registros en los sistemas de origen y la calidad se deteriora continuamente. Una limpieza en una sola pasada es suficiente para un proyecto puntual, pero los flujos de trabajo de IA en producción requieren procesos automatizados y recurrentes que vuelvan a perfilar, limpiar y deduplicar los datos según un calendario establecido. La automatización de tareas de Match Data Pro se encarga de ello sin necesidad de intervención manual.
¿Puede la búsqueda aproximada facilitar la recuperación de datos en los flujos de trabajo de IA?
Sí. Una API de búsqueda difusa en tiempo real permite a los agentes de IA enviar una cadena de texto no estructurada que representa una entidad y recuperar el registro de referencia que mejor se ajusta a ella, junto con una puntuación de confianza. Esto elimina la necesidad de una coincidencia exacta de claves en la recuperación y gestiona las variaciones de nombre, las abreviaturas y los errores tipográficos que aparecen en las consultas reales de los modelos de lenguaje grande (LLM) sobre los datos de la empresa.