
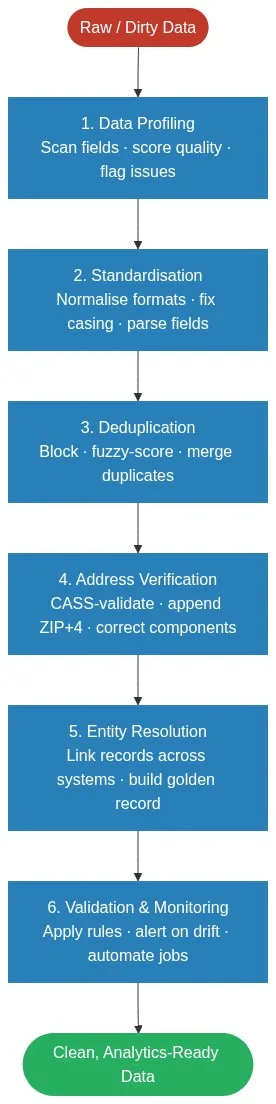
La limpieza de datos moderna se lleva a cabo mediante un proceso estructurado y automatizado, y no como un proyecto manual puntual. Un programa completo de limpieza de datos hace pasar los datos brutos por seis etapas definidas: elaboración de perfiles, estandarización, deduplicación, verificación de direcciones, resolución de entidades y supervisión continua. Los equipos que siguen este proceso reducen sistemáticamente las tasas de error en los datos entre un 30 % y un 60 % en los primeros 90 días.
Las consecuencias de saltarse cualquier etapa se acumulan: los campos no estandarizados generan falsos resultados de no coincidencia; los duplicados no resueltos aumentan los costes operativos; y las direcciones no verificadas provocan devoluciones de correo y entregas fallidas. Esta guía abarca todas las etapas, las herramientas necesarias en cada paso y las técnicas que distinguen a un programa de limpieza fiable de una limpieza puntual que pierde eficacia en cuestión de semanas.
¿Estás listo para limpiar tus datos ya? Empieza una prueba gratuita de Match Data Pro: sin contrato ni cuota de alta.
Por qué ha cambiado la limpieza de datos en los últimos tres años
El paso de la limpieza manual a la asistida por IA supone el cambio más significativo en las prácticas de calidad de los datos desde la adopción de las bases de datos relacionales. Hay tres factores que lo impulsan:
- Volumen de datos: Las organizaciones recopilan actualmente registros procedentes de sistemas CRM, ERP, de automatización de marketing, de comercio electrónico, del Internet de las cosas (IoT) y de fuentes de enriquecimiento de terceros de forma simultánea. Un enfoque manual no puede adaptarse a más de 10 sistemas de origen.
- Dependencia de la IA: La precisión de los modelos de aprendizaje automático depende exclusivamente de la calidad de los datos de entrenamiento. Una entrada de datos errónea genera resultados poco fiables —lo que los expertos denominan «si entran datos erróneos, salen datos erróneos», pero a la velocidad de una máquina—.
- Presión normativa: el RGPD, la CCPA, la HIPAA y las normativas específicas de cada sector exigen a las organizaciones que mantengan registros precisos, sin duplicados y auditables. Los organismos reguladores auditan cada vez más la calidad de los datos de forma directa.
El resultado es que la limpieza de datos se ha convertido ahora en una disciplina de flujos de trabajo, y no en una tarea que se realiza en hojas de cálculo. Plataformas como el conjunto de herramientas de limpieza de datos de Match Data Pro automatizan todo el proceso —desde la creación de perfiles hasta la supervisión—, de modo que los equipos de datos gestionan los datos por excepción, en lugar de hacerlo manualmente.
Fase 1: Perfilado de datos — Averigua qué datos tienes antes de tocarlos
La generación de perfiles es el paso de diagnóstico. Ejecútala antes de cualquier transformación. Un análisis de perfiles adecuado genera estadísticas a nivel de campo, entre las que se incluyen: índices de valores nulos, recuentos de valores distintos, distribuciones de formatos, brechas de integridad referencial y registros atípicos.
¿Qué superficies se perfilan?
Imaginemos una tabla de clientes con 850 000 registros importados de tres sistemas CRM heredados. Al ejecutar un análisis de perfiles en la phone El campo podría devolver:
- El 22 % de los valores contienen letras (p. ej., «Llama después de las 17:00»)
- El 14 % tiene el formato de números locales de 7 dígitos sin prefijo
- El 9 % son duplicados del campo de correo electrónico insertados por un error de ETL
Sin el perfilado, una tarea de estandarización que se ejecute en ese campo genera resultados erróneos. Con el perfilado, el equipo sabe exactamente qué registros necesitan una corrección basada en reglas antes de que se realice cualquier proceso de coincidencia.
El motor de análisis de datos basado en IA de Match Data Pro examina automáticamente todos los campos, evalúa la calidad en una escala del 0 al 100 y detecta anomalías sin necesidad de configuración manual.
Fase 2: Estandarización — Un formato, un conjunto de normas
La normalización convierte los datos heterogéneos en un formato uniforme que permite a los procesos posteriores compararlos de forma fiable. Los objetivos de normalización más relevantes son:
Normalización de nombres
Datos sin procesar correspondientes a la misma persona en dos sistemas:
| Fuente A | Fuente B |
|---|---|
| JONATHAN K. SMITH | Jon Smith |
| IBM CORPORATION | International Business Machines |
| Hospital de Santa María | Hospital Saint Marys |
Sin normalización, la coincidencia aproximada entre estos registros requiere umbrales más altos y, aun así, se pierde un porcentaje significativo de coincidencias reales. Con la estandarización —normalización de mayúsculas y minúsculas, expansión de abreviaturas, eliminación de signos de puntuación—, la puntuación de similitud de Jaro-Winkler entre «Jonathan Smith» y «Jon Smith» aumenta de 0,71 a 0,89, superando la mayoría de los umbrales de coincidencia.
Formatos de fecha y numéricos
Una sola migración de un sistema ERP puede introducir seis formatos de fecha: MM/DD/YYYY, DD-MM-YY, YYYY-MM-DD, marcas de tiempo de Unix y variantes de la norma ISO 8601. La estandarización según la norma ISO 8601 antes de realizar cualquier comparación elimina por completo los falsos desajustes en los campos de fecha.
Para conocer las técnicas específicas para gestionar los campos de texto libre, consulta la guía sobre limpieza de datos de texto y estandarización de texto libre.
Fase 3: Desduplicación — Eliminar los duplicados que merman la eficiencia operativa
Los registros duplicados son el problema de calidad de datos más cuantificable. Gartner estima que la mala calidad de los datos supone a las organizaciones un coste medio de 12,9 millones de dólares al año, y que los duplicados representan una parte desproporcionada de esa cifra debido al gasto innecesario en marketing, los costes operativos inflados y los análisis fallidos.
Un flujo de trabajo de deduplicación en producción consta de tres pasos secundarios:
Bloqueo
Comparar cada registro con todos los demás supone una complejidad de O(n²), lo cual resulta inviable a gran escala. Se bloquean grupos de pares candidatos utilizando uno o más atributos compartidos (los tres primeros caracteres del apellido, el primer dígito del código postal, etc.), de modo que solo se tienen en cuenta las coincidencias plausibles. Una estrategia de bloqueo bien diseñada reduce los pares de comparación en más del 99 % sin perder los verdaderos positivos.
Puntuación difusa
Dentro de cada bloque, un modelo de puntuación ponderada aplica varios algoritmos a distintos campos. Ejemplo de configuración:
| Campo | Algoritmo | Peso |
|---|---|---|
| Apellido | Jaro-Winkler | 30% |
| Nombre | Fonética (Soundex) | 20% |
| Correo electrónico | Coincidencia exacta | 25% |
| Teléfono | Levenshtein (normalizado) | 15% |
| Código postal | Coincidencia exacta | 10% |
Una puntuación compuesta superior a 0,85 provoca la fusión automática. Las puntuaciones comprendidas entre 0,70 y 0,85 pasan a una cola de revisión. Las puntuaciones inferiores a 0,70 se clasifican como no duplicadas. Este modelo de tres bandas permite que la revisión humana se centre en los casos límite reales, que suelen representar entre el 2 % y el 5 % del conjunto total de comparaciones.
Descubre cómo funcionan los algoritmos de coincidencia aproximada y cuándo utilizar cada uno de ellos para profundizar en la selección de algoritmos según el tipo de campo.
Supervivencia y fusión
Una vez confirmado un par duplicado, las reglas de supervivencia determinan qué valores de los campos se mantienen en el registro de referencia. Estrategias habituales: se da prioridad a la última actualización en el caso de los campos de contacto; se da prioridad al registro más completo en el caso de los campos demográficos; se concatenan los valores en el caso de las notas y los comentarios. Para obtener información detallada, consulta la guía sobre la fusión de datos coincidentes y las reglas de supervivencia.
Fase 4: Verificación de la dirección — El paso que la mayoría de los procesos omiten
Los errores en las direcciones son sistémicos. Las direcciones pierden validez a un ritmo aproximado del 10-15 % anual, a medida que las personas se mudan, las empresas se trasladan y las autoridades postales actualizan los datos de los puntos de entrega. Un registro que superó la validación de la dirección hace 18 meses tiene muchas posibilidades de estar incorrecto hoy en día.
La certificación CASS (Sistema de Apoyo a la Precisión en la Codificación) es la norma del USPS para la verificación de direcciones. Un proceso certificado por CASS:
- Analiza la cadena de dirección sin formato y la divide en sus partes componentes (número de calle, nombre de la calle, número de piso, ciudad, provincia y código postal).
- Comprueba que cada componente se ajuste a la base de datos actual de puntos de entrega de USPS
- Añade códigos ZIP+4 para garantizar una ruta de entrega precisa
- Devuelve un indicador de estado DPV (validación del punto de entrega) por cada registro
Match Data Pro incluye la verificación de direcciones certificada por CASS como una etapa nativa del proceso, sin necesidad de conectores de terceros. Un lote de 500 000 direcciones suele devolverse con el estado DPV completo y el ZIP+4 añadido en menos de 10 minutos.
Etapa 5: Resolución de entidades — Vincular registros de distintos sistemas en una única vista
La resolución de entidades va más allá de la deduplicación dentro de un único conjunto de datos. Vincula registros que representan a la misma entidad del mundo real en múltiples sistemas inconexos, incluso cuando no existe ningún identificador compartido.
Ejemplo: un cliente figura en Salesforce como «Acme Corp», en el sistema de facturación como «ACME Corporation LLC» y en el sistema de gestión de incidencias como «Acme», con una dirección diferente. La coincidencia determinista basada en el nombre de la empresa falla en los tres casos. La resolución de entidades mediante un modelo probabilístico ponderado —que evalúa la similitud de los nombres, la proximidad de las direcciones, la coincidencia de los números de teléfono y el dominio— vincula correctamente los tres casos en un único grupo de entidades.
Match Data Pro integra la resolución de entidades de Senzing, un motor probabilístico basado en grafos y entrenado previamente con patrones reales de nombres y direcciones. Funciona en tiempo real y no requiere reglas definidas manualmente, lo que lo convierte en la opción más escalable para los equipos que vinculan registros entre tres o más sistemas de origen.
Para obtener información detallada sobre el problema de la vinculación entre sistemas, consulta cómo hacer coincidir registros de varios sistemas sin un identificador compartido.
Fase 6: Normas de validación y seguimiento continuo
La limpieza de datos no es una tarea que se realice una sola vez. Los datos se deterioran continuamente. Las direcciones de correo electrónico de los clientes devuelven mensajes de error. Los números de teléfono se reasignan. Los nombres de las empresas cambian debido a fusiones y adquisiciones. Un programa moderno de limpieza de datos incluye un seguimiento automatizado que avisa de las desviaciones antes de que se agraven.
Reglas de validación
La validación posterior a la limpieza aplica un conjunto de reglas para confirmar que el resultado cumple los objetivos de calidad del programa. Reglas habituales:
- La tasa de campos en blanco en los campos obligatorios debe ser inferior al 2 %
- La validez del formato de los correos electrónicos debe superar el 98 %
- La tasa de duplicados debe ser inferior al 0,5 %
- El porcentaje de direcciones confirmadas por el DPV debe superar el 90 %
Cualquier incumplimiento de las normas da lugar a una retención y revisión antes de que los datos lleguen a los sistemas posteriores.
Automatización y programación de tareas
Las funciones de automatización de tareas de Match Data Pro permiten a los equipos programar tareas de limpieza con la periodicidad que deseen: cada hora, cada día, cada semana o activadas por eventos, como la incorporación de nuevos datos. Cada ejecución genera un registro de auditoría completo de los cambios, lo que cumple con los requisitos de registro de auditoría descritos en la guía sobre registros de auditoría de datos para la gobernanza.
¿Quieres ver el proceso completo en acción? Concierta una demostración con un ingeniero de datos de Match Data Pro.
Cómo elegir las herramientas adecuadas para la limpieza de datos
El panorama de herramientas para la limpieza de datos en 2026 se divide claramente en cuatro categorías:
| Categoría | Ejemplos | Ideal para | Limitación |
|---|---|---|---|
| Hoja de cálculo / manual | Excel, Hojas de cálculo de Google | Conjuntos de datos pequeños con menos de 10 000 registros | No se puede escalar; no hay coincidencia aproximada |
| De código abierto | OpenRefine, pandas de Python | Equipos técnicos con capacidad de desarrollo | Sin verificación de direcciones; gestión manual |
| Plataformas ETL | Talend, Informatica | Grandes empresas con recursos informáticos | Alto coste; implementación lenta; sin resolución de entidades integrada |
| SaaS especializado en la calidad de los datos | Datos de partidos Pro | Equipos de datos que necesitan una cobertura completa del proceso de tratamiento de datos | Requiere acceso a SaaS; implementación en la nube |
Las plataformas diseñadas específicamente destacan en tres aspectos: la profundidad de los algoritmos (sistema de puntuación configurable con múltiples algoritmos), la amplitud de la integración (conectores nativos para CRM, ERP y almacenamiento en la nube) y el coste total de propiedad (sin necesidad de mantener infraestructura). Para consultar un marco de evaluación estructurado, véase la comparativa de software de calidad de datos para 2026.
Preguntas frecuentes
¿Cuál es la diferencia entre la limpieza de datos y la validación de datos?
La limpieza de datos corrige errores, elimina duplicados y estandariza los formatos de los registros existentes. La validación de datos comprueba que los datos nuevos o transformados se ajusten a las reglas definidas antes de que se introduzcan en un sistema. La limpieza es correctiva; la validación es preventiva. En un proceso maduro, las reglas de validación se ejecutan tras cada tarea de limpieza para confirmar que el resultado cumple los objetivos de calidad antes de su uso en fases posteriores.
¿Cuánto tiempo dura un proyecto de limpieza de datos?
Un proyecto de limpieza específico centrado en un único conjunto de datos de CRM de entre 100 000 y 500 000 registros suele completarse en un plazo de dos a cuatro semanas utilizando una plataforma automatizada. La mayor parte de ese tiempo se dedica a la configuración y la elaboración de perfiles durante la primera semana, mientras que las fases posteriores se ejecutan de forma automática. Una vez que el proceso inicial está en marcha, la supervisión continua y las ejecuciones de limpieza incrementales requieren unas pocas horas por ciclo.
¿Es mejor limpiar los datos antes o después de la migración?
Limpia siempre los datos antes de la migración. Trasladar datos sucios a un nuevo sistema propaga los errores al nuevo entorno y, a menudo, duplica el coste de la corrección. Analiza, estandariza, deduplica y verifica las direcciones comparándolas con el sistema de origen antes de la transición. Este enfoque se trata en profundidad en la guía sobre cómo preparar los datos para la migración a CRM.
¿Cuál es el problema más habitual relacionado con la calidad de los datos en los sistemas CRM?
Los registros de contactos duplicados son el problema más habitual en cuanto a la calidad de los datos de los sistemas CRM. La mayoría de las plataformas CRM carecen de una capa de coincidencia aproximada configurable en el momento de la introducción de datos, por lo que los registros casi duplicados —la misma persona con una ortografía ligeramente diferente del nombre, un formato de teléfono distinto o un dominio de correo electrónico diferente— se acumulan con el tiempo. Un estudio sobre las bases de datos CRM de las empresas reveló que las tasas medias de duplicados oscilaban entre el 10 % y el 30 % en el conjunto de los registros de contactos.
¿Se puede automatizar por completo la limpieza de datos?
La mayoría de las operaciones de limpieza —elaboración de perfiles, estandarización, deduplicación dentro de unos límites claros y verificación de direcciones— pueden automatizarse por completo. Los registros que se encuentran en bandas de coincidencia ambiguas (normalmente entre el 2 % y el 5 % del volumen total) siguen beneficiándose de una revisión humana. La automatización se encarga de más del 95 % de los casos claros; la plataforma destaca el resto para que lo evalúen expertos, en lugar de procesar todo el conjunto de datos manualmente.