
Cuando se integran datos de múltiples sistemas —CRM, ERP, plataformas de marketing, proveedores de datos externos—, se encuentran duplicados en todas las fronteras entre fuentes. El software de deduplicación para la integración de datos de múltiples fuentes resuelve este problema identificando y fusionando los registros que se solapan antes de que afecten negativamente a los análisis posteriores, inflen el recuento de contactos o provoquen comunicaciones duplicadas. El proceso requiere algo más que un filtrado básico por coincidencia exacta: los registros rara vez comparten valores de campo idénticos entre sistemas, por lo que la coincidencia aproximada y la resolución de entidades son esenciales.
Antes de elegir una plataforma, realiza un análisis de perfil de datos en cada fuente para conocer la cobertura de los campos, las variaciones de formato y la tasa estimada de duplicados. Esa referencia determina todas las decisiones de configuración posteriores. Solicita una demostración para ver cómo Match Data Pro gestiona la deduplicación de múltiples fuentes en tus propios datos.
Por qué la deduplicación de múltiples fuentes es diferente de la deduplicación de una sola fuente
La deduplicación de una sola fuente —es decir, la búsqueda de duplicados dentro de un único CRM o una única hoja de cálculo— es relativamente sencilla. El esquema de campos es coherente, los formatos son relativamente uniformes y las claves de bloqueo son predecibles. La integración de múltiples fuentes cambia cada una de esas premisas.
Incompatibilidad de esquemas
La fuente A almacena un nombre completo en un solo campo: John P. Smith. La fuente B lo divide en first_name y last_name. La fuente C utiliza una abreviatura: J Smith. Antes de poder realizar cualquier comparación, los campos deben analizarse y normalizarse para que adquieran una estructura común. Sin este paso, incluso un registro que represente a una misma persona obtendrá una puntuación inferior a cualquier umbral de coincidencia razonable.
Variación de formato
Pensemos en un número de teléfono. Un sistema almacena (312) 555-0147; otra tienda 3125550147; un tercero almacena +1-312-555-0147. Una unión por coincidencia exacta del número de teléfono no arroja ningún resultado, a pesar de que tres sistemas hacen referencia a la misma persona. Los datos de la dirección son aún peores: Suite 400, Ste 400y STE. 400 son el mismo sufijo de unidad en tres formatos diferentes.
Cobertura solapada pero no idéntica
La fuente A tiene 400 000 registros. La fuente B tiene 350 000. El solapamiento puede ser del 60-70 %, pero no es posible saber de antemano qué registros se solapan, cuáles son únicos y cuáles representan la misma entidad bajo un identificador diferente. Este es el principal reto que resuelven la coincidencia difusa y la resolución de entidades.
El proceso de seis etapas para la deduplicación de múltiples fuentes
Un sólido proceso de deduplicación de múltiples fuentes se desarrolla a lo largo de seis etapas ordenadas. Saltarse cualquier etapa provoca errores acumulativos en las etapas posteriores.
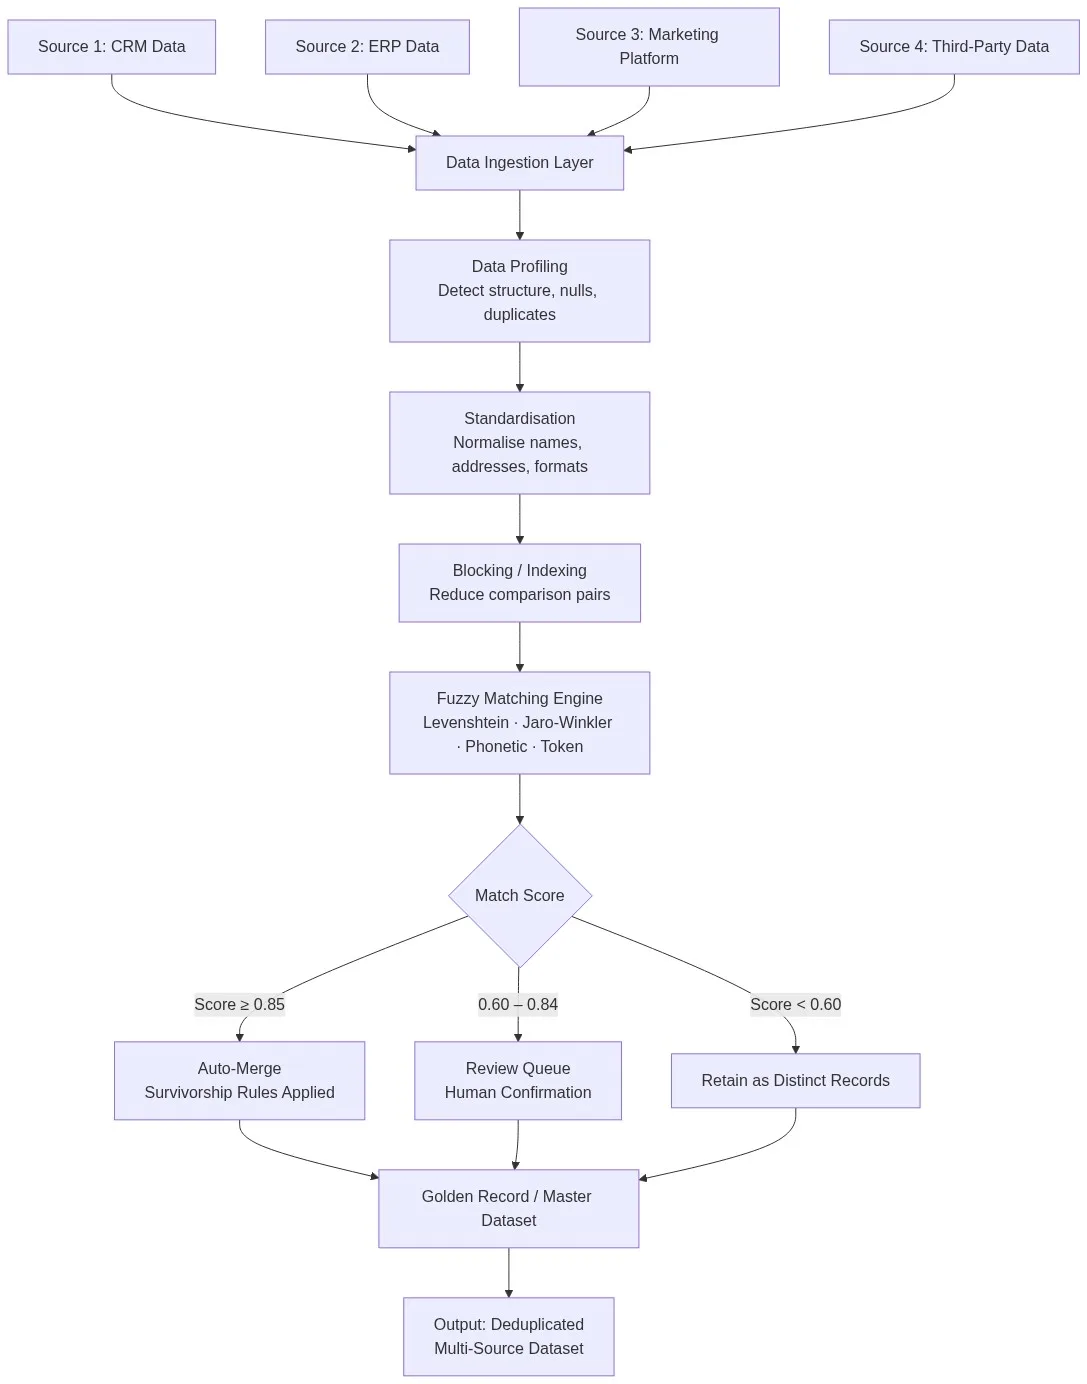
Fase 1: Elaboración de perfiles
Antes de la estandarización, analiza cada fuente de forma independiente. Mide los índices de valores nulos, las distribuciones de valores, los patrones de formato y los índices de duplicados dentro de cada fuente. Una fuente con un 22 % de direcciones de correo electrónico nulas requiere una estrategia de bloqueo diferente a la de una con una cobertura de correo electrónico del 98 %. El motor de análisis de datos basado en IA de Match Data Pro examina cada conjunto de datos automáticamente y muestra estas métricas antes de que se ejecute cualquier proceso de emparejamiento.
Fase 2: Normalización
Normaliza todos los campos a una forma canónica común. El análisis de nombres divide los nombres completos y elimina los títulos honoríficos. La normalización de números de teléfono elimina los signos de puntuación y aplica el formato E.164. La estandarización de direcciones desarrolla las abreviaturas y aplica las normas postales del USPS a través de limpieza y estandarización de datos rutinas. Tras esta etapa, J Smith, John P. Smithy John Smith compartir suficientes tokens normalizados para que sean comparables.
Fase 3: Bloqueo e indexación
Comparar cada registro de la fuente A con cada registro de la fuente B resulta computacionalmente inviable a gran escala. Un conjunto de datos de 500 000 registros procedentes de dos fuentes genera 250 000 millones de pares de comparación. El bloqueo reduce esta cifra a un número manejable agrupando los registros en conjuntos de candidatos; por ejemplo, todos los registros que comparten los tres primeros caracteres del apellido y el mismo código postal. Match Data Pro aplica varias claves de bloqueo superpuestas en paralelo para mantener la recuperación y, al mismo tiempo, reducir el volumen de comparaciones en más del 99 %.
Fase 4: Coincidencia aproximada y puntuación
Dentro de cada bloque, el motor puntúa cada par de candidatos utilizando una combinación ponderada de algoritmos. Los campos de nombre utilizan el algoritmo de Jaro-Winkler para cadenas cortas y la relación entre tokens y conjunto para nombres completos con iniciales del segundo nombre. Los campos de teléfono utilizan la coincidencia exacta tras la normalización. Los campos de dirección utilizan la distancia de Levenshtein sobre los componentes analizados. Los campos de correo electrónico utilizan la coincidencia exacta, además de una puntuación aproximada a nivel de dominio para las variantes corporativas.
Una configuración típica de puntuación ponderada tiene el siguiente aspecto:
| Campo | Algoritmo | Peso |
|---|---|---|
| Apellido | Jaro-Winkler | 30% |
| Nombre | Jaro-Winkler | 20% |
| DIRECCIÓN | Levenshtein sobre componentes analizados | 25% |
| Teléfono | Exacto tras la normalización según la norma E.164 | 15% |
| Correo electrónico | Exacto + difuso por dominio | 10% |
Una puntuación compuesta de 0,85 o superior activa la fusión automática. Las puntuaciones comprendidas entre 0,60 y 0,84 se envían a una cola de revisión manual. Las puntuaciones inferiores a 0,60 mantienen ambos registros como entidades independientes.
Etapa 5: Supervivencia e integración
Una vez que se confirma que dos registros son duplicados, las reglas de supervivencia determinan qué valor de campo se utiliza para completar el registro de referencia. Reglas habituales: prevalece el valor más reciente que no sea nulo; en los campos de nombre, prevalece la cadena más larga; la dirección verificada (con certificación CASS) prevalece sobre la no verificada. El proceso de fusión y eliminación de Match Data Pro aplica estas reglas automáticamente, generando un único registro de referencia con un registro de auditoría completo que muestra qué fuente aportó cada valor de campo.
Fase 6: Validación y seguimiento continuo
Tras la deduplicación, comprueba la calidad de los resultados. Mide la tasa de coincidencias, la tasa de falsos positivos (registros no duplicados confirmados que se han fusionado automáticamente) y la exhaustividad del registro de referencia. Configura un seguimiento continuo para que los nuevos registros importados desde cualquier fuente se comparen con el conjunto de datos maestro existente en tiempo real a través de la API de deduplicación antes de que entren en el sistema.
Gestión de casos concretos de solapamiento entre varias fuentes
Escenario 1: Solapamiento entre CRM y ERP
Una empresa manufacturera tiene 280 000 registros de clientes en su CRM y 195 000 cuentas en su ERP. El CRM utiliza el correo electrónico como clave principal; el ERP, el número de cuenta. No existe un identificador común. Tras la estandarización y la coincidencia aproximada, el equipo descubre que hay 140 000 registros que coinciden en ambos sistemas, pero 23 000 de esas coincidencias se sitúan en el intervalo de confianza de 0,60 a 0,84, lo que significa que comparten el mismo nombre de empresa y el mismo código postal, pero tienen nombres de contacto diferentes. Estos se envían a una cola de revisión antes de fusionarse.
Escenario 2: Fusión de bases de datos tras una adquisición
Una empresa adquiere a un competidor y necesita fusionar dos bases de datos de clientes independientes. Ambas utilizan la misma plataforma de CRM, pero con esquemas de campos personalizados diferentes. Un enfoque de vinculación de registros de múltiples fuentes asigna los campos de cada instancia, los estandariza y, a continuación, ejecuta un proceso completo de deduplicación entre bases de datos. Resultado: el 18 % de los registros son duplicados, y la base de datos combinada se reduce de 620 000 a 510 000 registros, lo que elimina 110 000 contactos fantasma antes de que el equipo combinado comience a ponerse en contacto con los clientes.
Escenario 3: CRM más una lista de contactos de terceros
Un equipo de marketing B2B importa una lista de contactos de terceros con 80 000 registros. Antes de subirla, la comparan con el CRM existente utilizando el proceso de deduplicación por lotes. Resultado: 31 000 registros (el 39 %) ya existen en el CRM. De los 49 000 restantes, 8 000 coinciden con puntuaciones de confianza de entre 0,60 y 0,84, lo que indica que probablemente se trate de la misma empresa con una dirección ligeramente diferente. Estos registros se marcan para que el departamento de ventas los revise antes de cargarlos, lo que evita tanto el contacto duplicado como el coste que supone enriquecer registros que ya existen.
Funcionalidades clave que hay que tener en cuenta en el software de deduplicación para la integración de múltiples fuentes
No todas las herramientas de deduplicación están diseñadas para escenarios con múltiples fuentes. Las herramientas de fuente única suelen carecer de la flexibilidad de esquema, la sofisticación en el bloqueo y los controles de supervivencia necesarios para una verdadera integración de múltiples fuentes. Evalúa las plataformas en función de estas seis dimensiones:
- Flexibilidad del esquema: ¿Es capaz la herramienta de asignar y normalizar campos procedentes de fuentes dispares sin necesidad de que los esquemas sean idénticos?
- Algoritmos configurables: ¿Se pueden ponderar los distintos algoritmos según el tipo de campo? Los campos de nombre, teléfono y dirección requieren distintos enfoques de puntuación.
- Estrategias de bloqueo múltiples: ¿Admite la herramienta bloques superpuestos para evitar la pérdida de recuperación cuando falta un campo o este es erróneo?
- Motor de reglas de supervivencia: ¿Se pueden definir reglas a nivel de campo que determinen qué fuente prevalece en cada atributo?
- Registro de auditoría: ¿Cada decisión de fusión genera un registro en el que se indica qué código fuente aportó cada valor?
- API para la prevención en tiempo real: una vez que el lote inicial esté limpio, ¿puede la herramienta bloquear futuros duplicados en el momento de la ingesta?
Match Data Pro gestiona las seis dimensiones. El motor de correspondencia configurable de la plataforma admite tanto la puntuación determinista como la probabilística, y su capa de resolución de entidades Senzing añade la resolución de identidades basada en grafos para escenarios complejos con múltiples fuentes que implican grandes volúmenes de registros o una elevada ambigüedad de entidades. La implementación se realiza en la nube como servicio (SaaS), sin contrato a largo plazo. Empieza una prueba gratuita y ejecuta tu primera tarea de deduplicación de múltiples fuentes en cuestión de horas.
Errores habituales en los proyectos de deduplicación de múltiples fuentes
Omitir la estandarización previa al partido
El error más habitual: los equipos realizan la comparación con datos sin procesar y no estandarizados. El resultado es una elevada tasa de falsos negativos —coincidencias no detectadas— porque el motor de puntuación no puede reconocer Ste 400 y Suite 400 como equivalentes. Hay que estandarizar primero, siempre. En un conjunto de datos con una variabilidad moderada en el formato, la estandarización por sí sola puede aumentar la recuperación de coincidencias entre un 20 % y un 35 %.
Uso de una única clave de bloqueo
Una única clave de filtrado —por ejemplo, el código postal— omite los registros en los que el código postal falta o es erróneo. El uso de varias claves que se solapan (código postal más prefijo del apellido, ciudad más prefijo telefónico, dominio de correo electrónico más identificador de la empresa) garantiza que los valores que faltan o son incorrectos en una clave no excluyan de la lista de coincidencias posibles a un candidato válido.
Configuración de umbrales sin elaboración de perfiles
Un umbral de 0,85 que funciona bien para un CRM empresarial bien organizado puede resultar demasiado estricto para una lista de contactos de terceros con un formato inconsistente. Analiza primero tus datos. A continuación, ajusta los umbrales basándote en una muestra etiquetada de coincidencias y no coincidencias conocidas antes de ejecutar el proceso completo a gran escala.
Considerar la deduplicación como un proceso que se realiza una sola vez
Cada día se introducen nuevos registros en todos los sistemas. Sin una comprobación en tiempo real basada en una API en el momento de la ingesta —o, como mínimo, una tarea por lotes semanal—, los duplicados vuelven a acumularse en cuestión de meses. La automatización de tareas de Match Data Pro ejecuta ciclos de deduplicación programados y comprobaciones en tiempo real mediante API para mantener limpio el conjunto de datos maestro de forma continua, no solo el primer día.
Preguntas frecuentes
¿Qué es el software de deduplicación para la integración de datos de múltiples fuentes?
El software de deduplicación para la integración de datos de múltiples fuentes identifica, puntúa y fusiona los registros duplicados en dos o más sistemas de datos que no comparten ninguna clave primaria común. Utiliza algoritmos de coincidencia aproximada y reglas de supervivencia para generar un único registro de referencia a partir de fuentes que se solapan, independientemente de las diferencias de esquema o las inconsistencias de formato entre ellas.
¿Cómo gestionas los registros que no tienen un identificador común en todos los sistemas?
Sin un identificador común, el motor de coincidencia compara los valores normalizados de los atributos —nombre, teléfono, correo electrónico, dirección— mediante algoritmos difusos ponderados. Una puntuación compuesta superior a un umbral definido activa una fusión. Por debajo de ese umbral, los registros se retienen para su revisión manual. Este enfoque resuelve correctamente entre el 85 % y el 95 % de los duplicados reales en conjuntos de datos empresariales típicos.
¿Qué porcentaje de solapamiento debo esperar al integrar dos bases de datos de clientes?
Los índices de solapamiento varían según el sector y el tipo de datos. Los conjuntos de datos B2B que integran CRM y ERP suelen presentar un solapamiento del 40-70 %. Las fusiones de dos listas de clientes en el mismo mercado tras una adquisición suelen situarse entre el 15 y el 30 %. Las ampliaciones de listas de terceros con un CRM ya existente suelen presentar un solapamiento del 25-45 %. La elaboración de perfiles antes de la comparación te proporciona la cifra exacta para tus datos concretos.
¿Es capaz el software de deduplicación de gestionar variantes de direcciones en distintos países?
Sí, pero la estandarización de direcciones internacionales requiere una herramienta que comprenda los formatos postales específicos de cada país. Las direcciones de EE. UU. se benefician de la verificación certificada por CASS, que estandariza los sufijos de unidad, las indicaciones de dirección y los códigos ZIP+4. Las direcciones fuera de EE. UU. requieren un análisis que tenga en cuenta el formato específico de cada país. La estandarización de direcciones de Match Data Pro gestiona ambos casos, reduciendo los falsos negativos causados por diferencias de formato en los conjuntos de datos globales.
¿Cuánto tiempo dura un proyecto de deduplicación de múltiples fuentes?
Un proyecto estándar de deduplicación de dos fuentes —que incluye la creación de perfiles, la estandarización, la comparación y la generación del registro de referencia— suele completarse en un plazo de dos a cuatro semanas utilizando una plataforma diseñada específicamente para ello. Las tareas que requieren más tiempo son el acceso a los datos (extracción y asignación de esquemas de origen) y el ajuste de los umbrales (validación con muestras etiquetadas). La deduplicación continua a través de una API o de tareas programadas supone una carga adicional insignificante una vez completada la configuración inicial.