
La limpieza de datos de CRM es el proceso de auditar, corregir y mantener todos los registros de contactos, cuentas y clientes potenciales de tu base de datos de clientes, de modo que los departamentos de ventas, marketing y éxito del cliente trabajen con datos precisos. Un CRM típico del mercado medio contiene entre un 15 % y un 30 % de registros duplicados o dañados. Si no se controlan, esos errores inflan los informes del canal de ventas, fragmentan los segmentos de las campañas y merman la atribución de ingresos. La limpieza de datos no es una tarea puntual, sino un proceso continuo y automatizado.
¿Estás listo para corregir los datos de tu CRM hoy mismo? Empieza una prueba gratuita de Match Data Pro y genera tu primer perfil de datos en cuestión de minutos, sin necesidad de contrato.
Por qué se deterioran los datos de CRM — y por qué es importante
Los datos del CRM se deterioran a un ritmo medio del 22-30 % al año. Los cambios de puesto de trabajo, los cambios de marca de las empresas y los cambios de dirección se producen continuamente. Además de este deterioro natural, hay cuatro causas mecánicas que añaden ruido a diario:
- Errores de introducción manual: «Acme Corp» frente a «ACME Corporation» frente a «Acme Corp.»: tres registros, una misma empresa.
- Importaciones combinadas: los archivos CSV de las ferias comerciales se importan sin deduplicar. Los comerciales crean nuevos clientes potenciales sin comprobar los ya existentes.
- Fuentes de datos de múltiples sistemas: la automatización del marketing, el ERP y las plataformas de atención al cliente envían datos al CRM utilizando convenciones de campos diferentes.
- Migraciones de sistemas heredados: los datos históricos de instancias anteriores de CRM contienen normas de formato con una década de antigüedad y registros sin depurar.
Las repercusiones posteriores son cuantificables. Se calcula que los equipos de ventas pierden un 27 % de su tiempo trabajando con datos inexactos. Las campañas de marketing enviadas a direcciones de correo electrónico duplicadas reducen los índices de entrega. La atribución de ingresos se ve afectada cuando un mismo cliente aparece en tres registros de cuenta distintos.
El proceso de limpieza de datos de CRM en siete etapas
Un proceso estructurado sustituye a las correcciones manuales puntuales. Match Data Pro ejecuta este proceso mediante tareas automatizadas y programables, que se activan al importar los datos, según una programación diaria o en tiempo real a través de la API.
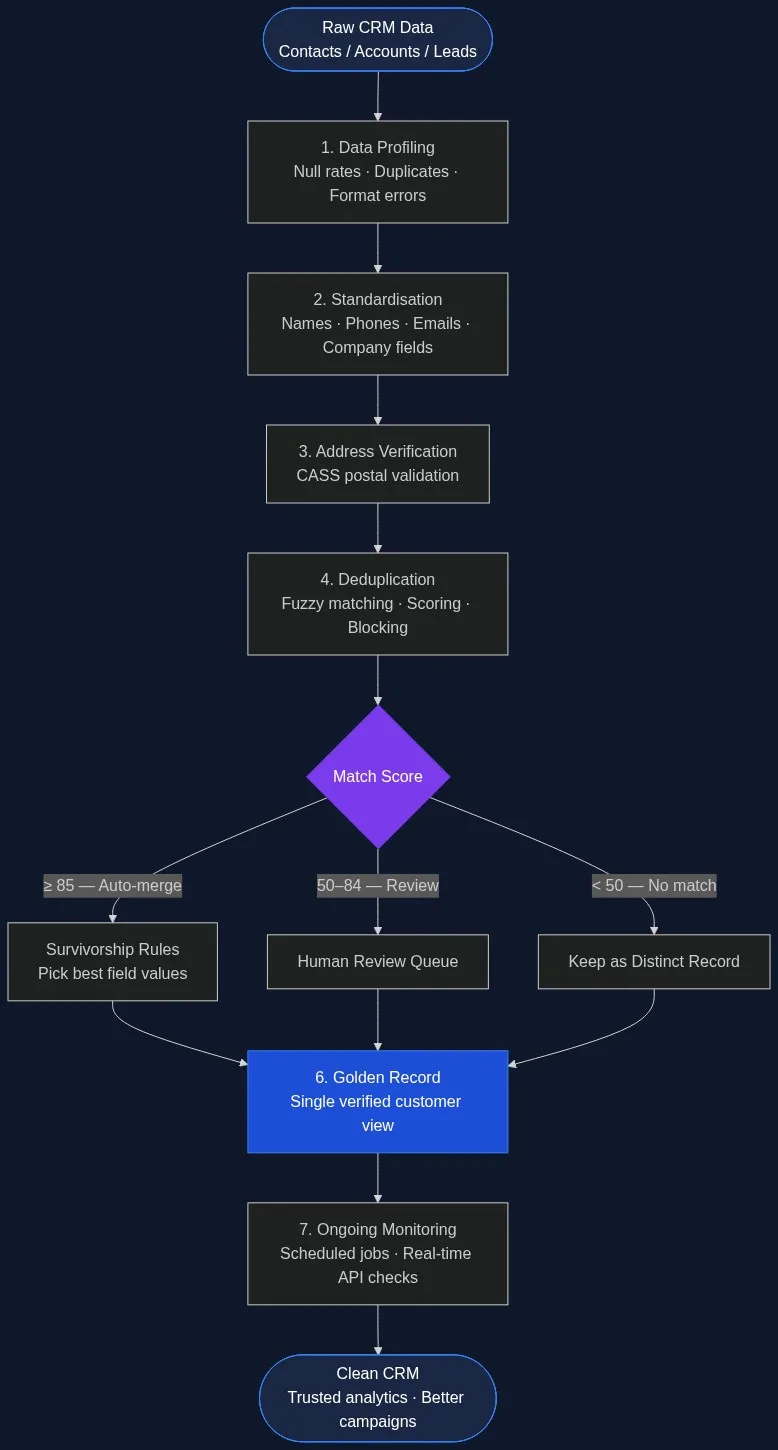
Fase 1: Análisis de los datos
El análisis de perfiles de datos mediante IA examina todos los campos de la exportación de tu CRM y genera un informe de calidad: índices de valores nulos, porcentajes de incumplimientos de formato, recuento de candidatos duplicados y distribución de valores. Por ejemplo, una base de datos de 50 000 contactos podría revelar que: el 18 % de los campos de teléfono contienen caracteres no numéricos, el 11 % de los campos de correo electrónico no superan la validación de formato y el 23 % de los campos de nombre de empresa presentan tres o más variantes ortográficas para la misma entidad.
El análisis de perfiles es un proceso no destructivo. Te indica qué falla antes de que toques los datos.
Fase 2: Estandarización de los formatos de campo
La estandarización de datos convierte cada campo a un formato uniforme. Transformaciones clave para los datos de CRM:
| Campo | Valor bruto | Estandarizado |
|---|---|---|
| Nombre | JONATHAN SMITH / jonathan smith | Jonathan Smith |
| Teléfono | (800) 555-1234 / 8005551234 | +18005551234 |
| Empresa | Acme Corp. / ACME CORPORATION | Acme Corporation |
| Correo electrónico | J.Smith@Acme.COM | j.smith@acme.com |
| Estado | California / CA / California | CA |
La estandarización es lo que hace que la coincidencia aproximada sea eficaz. Comparar «Acme Corp.» con «ACME CORPORATION» sin normalización da como resultado una puntuación de similitud inferior a la que se obtiene al comparar «Acme Corporation» con «Acme Corporation», aunque ambas se refieran a la misma entidad. Consulta la guía completa sobre técnicas de limpieza de datos de texto para el tratamiento de campos de texto libre.
Etapa 3 — Comprobación de direcciones
Los campos de dirección son los más complejos desde el punto de vista estructural en cualquier CRM. La verificación de direcciones certificada por CASS de Match Data Pro desglosa cada dirección en sus componentes (número de calle, nombre de la calle, número de piso, ciudad, estado y ZIP+4), valida cada componente con la base de datos postal del USPS y corrige los errores más habituales: códigos postales invertidos, sufijos de número de piso que faltan y tipos de calle abreviados.
Una dirección verificada también permite realizar una segmentación geográfica posterior y un análisis de la ruta de comercialización. Una dirección no verificada supone un desperdicio del presupuesto destinado al correo directo y distorsiona los datos territoriales.
Etapa 4: deduplicación mediante coincidencia aproximada
Esta es la fase más compleja desde el punto de vista técnico. La deduplicación por coincidencia exacta solo detecta los clones evidentes —el mismo correo electrónico, el mismo número de teléfono—. Los duplicados reales en los sistemas CRM son más complicados:
- Jon Smith contra Jonathan Smith (variante del apodo)
- Acme Corp., 100 Main St. frente a Acme Corp., 100 Main Street (abreviatura)
- +1 800 555 1234 frente a 8005551234 (diferencia de formato)
- sarah.jones@acme.com frente a sarah.jones@acme-corp.com (alias de dominio)
El motor de coincidencia aproximada de Match Data Pro aplica una puntuación ponderada configurable a varios campos simultáneamente. Una configuración típica de CRM asigna una ponderación del 40 % al correo electrónico, del 30 % al nombre de la empresa, del 20 % al teléfono y del 10 % a la dirección. Cada campo se puntúa utilizando el algoritmo más adecuado —Jaro-Winkler para los nombres, la relación de conjuntos de tokens para los nombres de empresas y la coincidencia exacta para los correos electrónicos— y, a continuación, se combinan para obtener una puntuación de coincidencia compuesta de entre 0 y 100.
Los registros con una puntuación de 85 o más se fusionan automáticamente. Los que obtienen una puntuación de entre 50 y 84 se colocan en cola para su revisión manual. Por debajo de 50, los registros se mantienen como independientes.
Etapa 5 — Aplicar las normas de supervivencia
Cuando se fusionan dos registros, las reglas de supervivencia determinan qué valores de los campos se conservan en el registro de referencia. Reglas habituales:
- Más reciente: utiliza el valor del campo del registro con la fecha de modificación más reciente.
- El más completo: elige el registro que tenga menos campos nulos.
- Prioridad de las fuentes: los datos del ERP prevalecen sobre los del CRM en lo que respecta a la dirección de facturación; los datos del CRM prevalecen en lo que respecta al correo electrónico de contacto.
- El más largo que no sea nulo: conservar el valor más descriptivo (por ejemplo, el nombre de la empresa más largo).
El motor de «survivorship» y «golden record» de Match Data Pro aplica estas reglas automáticamente y registra cada decisión a nivel de campo en el registro de auditoría.
Etapa 6 — Crear el Disco de Oro
El resultado de la fusión y la verificación es un único registro de cliente oficial. En él se consolidan todo el historial de interacciones, los campos de contacto verificados y los metadatos de origen. Un verdadero «registro de referencia» incluye: el identificador canónico, los identificadores de los sistemas de origen que han contribuido a la fusión, la dirección postal verificada y una puntuación de exhaustividad que indica cuántos campos opcionales se han rellenado.
Etapa 7 — Realizar un seguimiento continuo
Una limpieza no es suficiente. Cada día se introducen nuevos registros en tu CRM. La capa de automatización de tareas de Match Data Pro ejecuta tareas de limpieza programadas a intervalos configurables —por la noche, semanalmente o al importar datos— para que el CRM nunca acumule un año de datos obsoletos antes del siguiente ciclo de limpieza. La API de búsqueda aproximada en tiempo real también comprueba si hay duplicados en el momento de la introducción, bloqueando los nuevos duplicados antes de que se almacenen.
Problemas habituales relacionados con la calidad de los datos en los sistemas CRM y cómo solucionarlos
Problema: Contactos duplicados entre regiones
Un equipo de ventas global que opera en las regiones de EMEA y AMER suele tener el mismo contacto empresarial registrado en ambas regiones. Los nombres difieren según la configuración regional (José frente a Jose), los formatos de teléfono varían (+34 frente a 0034) y los dominios de correo electrónico difieren según la filial. La deduplicación estándar no tiene en cuenta estos aspectos. La vinculación de registros de múltiples fuentes de Match Data Pro gestiona los conjuntos de caracteres internacionales y la normalización de formatos antes de la puntuación.
Problema: Registros de cuentas obsoletos
Las cuentas que se cerraron o fusionaron hace años siguen figurando como activas en el CRM. La creación de perfiles identifica los registros sin actividad —sin aperturas de correos electrónicos, sin actualizaciones de oportunidades, sin entradas en el registro— en un intervalo de tiempo configurable. Estos registros se marcan para su archivo, en lugar de su eliminación, lo que permite conservar el historial al tiempo que se retiran de los segmentos activos.
Problema: Inconsistencias en la propiedad tras una migración
Las migraciones de CRM suelen provocar un caos en el campo «propietario»: el campo está en blanco, asignado a un usuario eliminado o vinculado al equipo equivocado. La fase de análisis identifica estos casos como anomalías de valor nulo en el campo «propietario», y el proceso de estandarización los asigna a un propietario predeterminado o a una cola de territorios para su reasignación.
Limpieza de datos de CRM frente a deduplicación de datos de CRM: ¿cuál es la diferencia?
Aunque estos términos suelen utilizarse indistintamente, describen operaciones diferentes. La deduplicación es una de las etapas del proceso más amplio de limpieza de datos: identifica y fusiona los registros que corresponden a una misma entidad. La limpieza de datos es el proceso completo: elaboración de perfiles, estandarización, verificación de direcciones, deduplicación, selección de registros y supervisión.
Se necesitan ambas cosas. La deduplicación sin estandarización da lugar a una menor precisión en las coincidencias: «Acme Corp» y «ACME Corporation» obtienen una puntuación inferior a la que deberían antes de la normalización. La estandarización sin deduplicación da como resultado registros que parecen limpios, pero que siguen siendo duplicados. Para profundizar específicamente en la fase de deduplicación, consulta la guía sobre deduplicación en CRM.
Cómo mantener la calidad de los datos del CRM tras la limpieza
Una limpieza se deteriora inmediatamente a menos que se incorporen medidas preventivas. Hay tres mecanismos que mantienen un alto nivel de calidad tras la limpieza inicial:
- Validación en el punto de entrada: la API de búsqueda aproximada de Match Data Pro compara cada nuevo registro con la base de datos existente en el momento de su creación. Si la coincidencia supera el umbral configurado, el comercial ve una advertencia de «posible duplicado» antes de guardar el registro.
- Tareas programadas por lotes: las tareas semanales o nocturnas vuelven a analizar el delta del CRM (registros modificados desde la última ejecución) y señalan nuevas anomalías. De este modo se detectan los duplicados creados a través de integraciones que eluden la interfaz de usuario.
- Cuadros de mando sobre la calidad de los datos: las puntuaciones de exhaustividad, las tasas de duplicados y las tasas de superación de la verificación de direcciones se muestran en un cuadro de mando de seguimiento para que el equipo de datos pueda analizar las tendencias, y no solo resolver incidencias.
El objetivo es un CRM con capacidad de autorreparación: uno que detecte y corrija la mayoría de los errores de forma automática, señale las excepciones para su revisión y mantenga un registro de auditoría documentado de cada cambio con fines de gobernanza y cumplimiento normativo.
Match Data Pro es una plataforma SaaS en la nube sin contrato a largo plazo y con una prueba gratuita disponible en members.matchdatapro.com. Si prefieres un recorrido guiado, reserva una demostración con el equipo y trae tu propia muestra de datos.
Preguntas frecuentes
¿Con qué frecuencia debería realizar una limpieza de datos del CRM?
Ejecuta un proceso completo de limpieza al menos una vez al trimestre, con tareas incrementales automatizadas que se ejecuten semanalmente o por la noche sobre los registros nuevos y modificados. Los datos del CRM se deterioran entre un 22 % y un 30 % al año, por lo que una limpieza anual hace que la mayoría de las organizaciones trabajen con datos significativamente corruptos durante la mayor parte del año. Las comprobaciones en tiempo real a través de la API en el punto de entrada reducen la tasa de acumulación.
¿Cuál es la diferencia entre la limpieza de datos de CRM y la deduplicación?
La deduplicación es uno de los pasos del proceso de limpieza: identifica y fusiona los registros que corresponden a una misma entidad. La limpieza es el proceso completo: elaboración de perfiles, estandarización de campos, verificación de direcciones, deduplicación, aplicación de reglas de supervivencia y seguimiento de la degradación continua de los datos. La deduplicación por sí sola, sin estandarización, produce una menor precisión en las coincidencias.
¿Puedo limpiar los datos del CRM sin afectar a las operaciones de ventas en curso?
Sí. El método más seguro consiste en ejecutar la limpieza en una instantánea exportada, validar los resultados e importar de nuevo los registros de referencia con un registro de cambios. Match Data Pro admite este flujo de trabajo mediante conectores de importación/exportación y genera un registro de auditoría completo de cada fusión y cada cambio de campo, que tu equipo puede revisar antes de dar el visto bueno. La validación mediante API en tiempo real permite entonces evitar que se generen nuevos duplicados en el momento de la entrada de datos, sin que ello suponga ninguna interrupción.
¿Qué umbral de coincidencia debo utilizar para la fusión automática de registros del CRM?
Un umbral de 85 o más en una puntuación compuesta de 0 a 100 es un punto de partida seguro para la fusión automática en la mayoría de los conjuntos de datos de CRM. Las puntuaciones comprendidas entre 50 y 84 deben someterse a revisión humana. Los umbrales dependen de la calidad de los campos: si la tasa de coincidencia de correos electrónicos es alta y fiable, otorgar una mayor ponderación al correo electrónico permite utilizar un umbral general más bajo de forma segura. Valida siempre los umbrales con una muestra etiquetada antes de aplicarlos a gran escala.
¿Funciona la limpieza de datos de CRM en varios sistemas de origen?
Sí. Match Data Pro recopila registros de múltiples sistemas de origen —CRM, ERP, automatización de marketing, plataformas de asistencia— a través de conectores de importación/exportación y los compara entre las distintas fuentes mediante un sistema de puntuación aproximada configurable. Los registros de diferentes sistemas que corresponden a un mismo cliente se vinculan y se fusionan en un único registro de referencia, conservando los identificadores de los sistemas de origen para garantizar la trazabilidad.