
Los registros duplicados suponen a las organizaciones un coste medio de 15 millones de dólares al año en gastos innecesarios, análisis erróneos y errores operativos. Cada registro duplicado de un cliente, proveedor o activo aumenta los costes operativos, distorsiona los informes y socava la confianza en los sistemas de datos. La solución pasa por un proceso estructurado de deduplicación, no por una limpieza puntual.
Por qué existen registros duplicados a gran escala
Los registros duplicados se introducen en las bases de datos a través de vías previsibles: la introducción manual de datos por parte de distintos miembros del personal, las importaciones por lotes procedentes de adquisiciones o fuentes de socios, las migraciones de CRM que incluyen registros heredados y los formularios web que carecen de validación en tiempo real. Un cliente que rellena un formulario con el nombre «Robert J. Smith» pasa a ser un registro distinto del «Bob Smith» introducido por un comercial.
Con 100 000 registros, una tasa de duplicación del 5 % supone 5 000 registros redundantes. Con 10 millones de registros, esa misma tasa genera 500 000 duplicados, cada uno de los cuales ocupa espacio de almacenamiento, distorsiona los análisis y genera acciones posteriores que pueden resultar conflictivas. Un análisis de perfiles de datos suele ser el primer indicio de la gravedad real del problema.
El verdadero impacto financiero de los registros duplicados
Los costes se dividen en cuatro categorías. Cada una de ellas es cuantificable y crece de forma no lineal con el tamaño del conjunto de datos.
Gasto en marketing mal invertido
Los registros de contactos duplicados suponen envíos duplicados de campañas. Si el 8 % de tus 2 millones de contactos de marketing son duplicados, estás enviando 160 000 correos electrónicos de más por campaña, pagando por el envío, el mantenimiento de la lista y la gestión de la lista de exclusión de registros que no deberían existir. A 0,003 dólares por correo electrónico y 12 campañas al año, eso supone 5.760 dólares en costes directos de envío, sin tener en cuenta las tarifas de alquiler de listas, el aumento de la tasa de bajas ni el deterioro de la capacidad de entrega debido a la dilución de la interacción.
Pérdida de ingresos
Los equipos de ventas que trabajan con registros duplicados realizan intentos de contacto duplicados con el mismo cliente potencial. Además, pasan por alto señales de venta cruzada: si las tres compras de un cliente figuran en tres registros duplicados, no es posible obtener una visión global de los ingresos generados por ese cliente. Una empresa de servicios financieros descubrió que el 12 % de sus excepciones en la contabilidad de clientes se debían a registros duplicados de empresas en su sistema ERP: se trataba de la misma entidad facturada con dos variantes de nombre ligeramente diferentes.
Fallos en el análisis y la elaboración de informes
Los paneles de control basados en datos erróneos generan métricas que apuntan en la dirección equivocada. El número de clientes se exagera. Las tasas de abandono se subestiman. Los cálculos del valor de por vida son fragmentados. Un director de datos (CDO) de una empresa de logística descubrió que su tasa de retención de clientes era 4 puntos porcentuales superior a la real, ya que los clientes que se habían dado de baja volvían a aparecer como nuevos registros tras las reimportaciones del CRM.
Cumplimiento normativo y riesgo regulatorio
Los registros duplicados suponen un riesgo normativo en sectores con obligaciones en materia de KYC, AML y conservación de datos. Si una entidad sancionada aparece con dos grafías ligeramente diferentes de su nombre, un sistema de filtrado que utilice una lógica de coincidencia exacta podría dar por válido uno y marcar el otro como sospechoso, lo que crearía una laguna que un auditor detectaría. En el marco del RGPD y la CCPA, los registros duplicados también complican las solicitudes de acceso de los interesados: responder a un registro cuando existe otro significa un cumplimiento incompleto.
Cómo calcular tu tasa de duplicación actual
Antes de corregir los duplicados, cuantifica el problema. Una evaluación estructurada de los datos mediante IA pone de manifiesto los indicadores clave:
- Índice de duplicados exactos: registros con valores idénticos en todos los campos clave.
- Índice de casi duplicados: registros en los que el nombre, el correo electrónico, el número de teléfono o la dirección difieren en entre 1 y 3 caracteres; detectados únicamente mediante algoritmos de coincidencia aproximada.
- Tasa de valores nulos por campo: los campos vacíos exageran la singularidad aparente.
- Solapamiento entre fuentes: la misma entidad que aparece en el CRM, el ERP y la automatización de marketing con identificadores diferentes.
Referencias del sector: los datos de CRM B2B suelen mostrar entre un 10 % y un 25 % de duplicación en los 18 meses posteriores a una migración. Los historiales de pacientes del sector sanitario presentan, de media, entre un 8 % y un 10 % de duplicación en los sistemas integrados. Los datos de las entidades de servicios financieros pueden alcanzar entre un 15 % y un 20 % de duplicación tras una adquisición.
¿Estás listo para calcular tu índice de duplicación? Empieza una prueba gratuita de Match Data Pro y ejecuta un proceso de perfilado en tu conjunto de datos en cuestión de minutos.
El proceso de deduplicación: de los datos brutos a los registros de referencia
Para eliminar duplicados a gran escala se necesita un flujo de trabajo, no un script. El siguiente diagrama muestra el proceso de siete etapas que Match Data Pro ejecuta automáticamente.
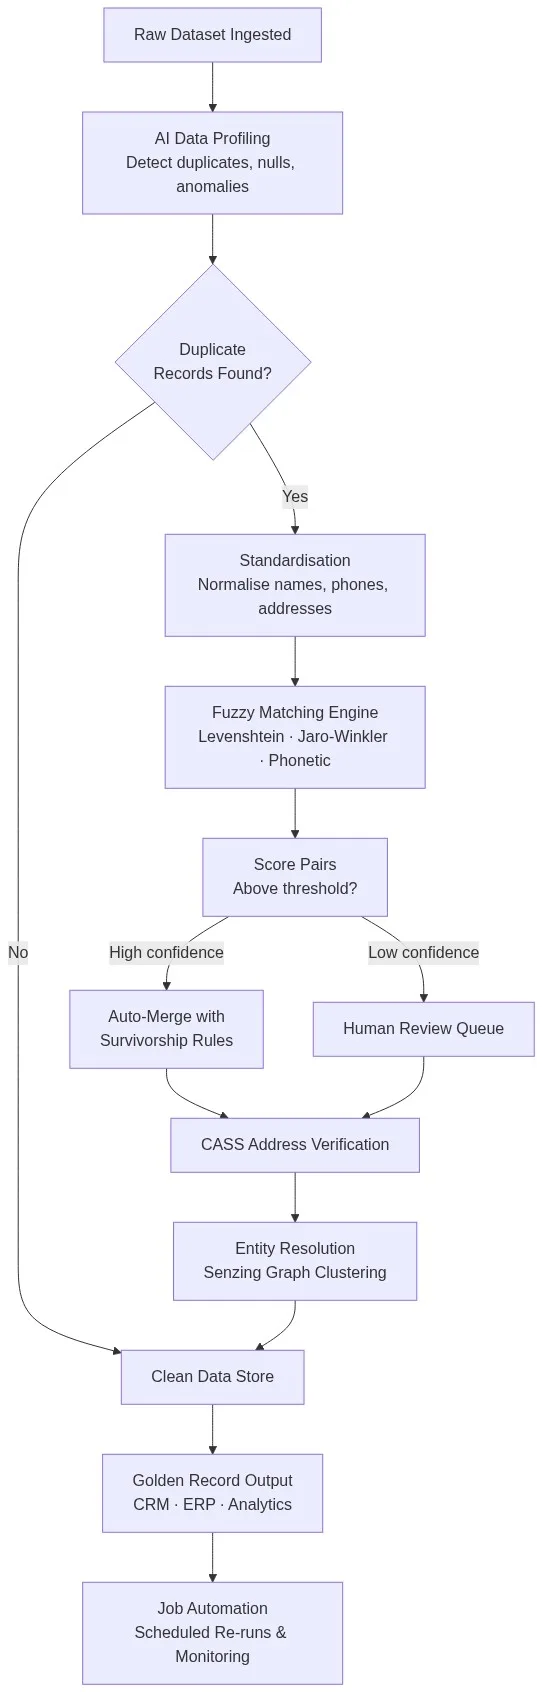
Fase 1: Elaboración de perfiles
El motor de análisis de datos basado en IA de Match Data Pro examina cada campo en busca de valores nulos, anomalías de formato, distribuciones de valores y posibles grupos de duplicados. Genera un informe de calidad antes de que se tome ninguna decisión sobre la fusión de datos.
Fase 2: Normalización
Los números de teléfono se normalizan al formato E.164. Los sufijos de las empresas («Inc.», «Incorporated», «Corp») se reducen a una forma canónica. Los campos de nombre se dividen en nombre y apellidos, con extracción del título. Los valores no estandarizados son la principal causa de que la coincidencia aproximada genere falsos positivos en esta fase.
Etapa 3: Bloqueo
Comparar cada par de registros con 10 millones de registros requeriría 50 billones de comparaciones. El bloqueo reduce el conjunto de candidatos agrupando los registros que comparten una clave indexada —los tres primeros caracteres del apellido, el prefijo del código de área o el prefijo del código postal— antes de aplicar la puntuación de similitud. Match Data Pro aplica automáticamente el bloqueo multiclave.
Etapa 4: Coincidencia aproximada
Dentro de cada bloque, el motor de coincidencia aproximada de Match Data Pro puntúa cada par candidato utilizando una combinación ponderada de algoritmos: la distancia de edición de Levenshtein para cadenas cortas, el algoritmo de Jaro-Winkler para nombres, la relación entre tokens y conjuntos para nombres de empresas con orden de palabras variable, y la codificación fonética (Soundex, Double Metaphone) para errores de transcripción.
Ejemplo de pareja puntuada por el motor:
| Campo | Registro A | Disco B | Puntuación |
|---|---|---|---|
| Empresa | Acme Corp | ACME Corporation | 0.91 |
| Teléfono | +1 312 555 0147 | 3125550147 | 1.00 |
| Correo electrónico | jsmith@acme.com | j.smith@acme.com | 0.94 |
| DIRECCIÓN | 123 N Wacker Dr | 123 North Wacker | 0.88 |
| Compuesto | 0,93 — Fusión automática |
Etapa 5: Enrutamiento por umbral
Los pares con una puntuación superior a 0,90 se envían directamente a la fusión automática. Los pares con una puntuación entre 0,70 y 0,90 se envían a una cola de revisión manual. Los pares con una puntuación inferior a 0,70 se conservan como registros distintos. Los umbrales se pueden configurar por conjunto de datos y tipo de campo.
Etapa 6: Supervivencia y fusión
Cuando se fusionan dos registros, las reglas de prevalencia determinan qué valor de campo prevalece. Las reglas pueden ser: el valor no nulo más reciente, la prioridad del sistema de origen, la cadena más larga o la sustitución manual. El motor de reglas de prevalencia de Match Data Pro las aplica de forma coherente y registra cada decisión de fusión para fines de auditoría. El resultado es un «registro de referencia»: una representación oficial de la entidad.
Etapa 7: Verificación de direcciones y resolución de entidades
Tras la fusión, Match Data Pro realiza una verificación de direcciones mediante CASS en todos los campos postales, corrigiendo las abreviaturas de las calles y añadiendo los códigos ZIP+4. A continuación, la resolución de entidades de Senzing agrupa los duplicados restantes procedentes de diferentes fuentes que no comparten ninguna clave común, vinculando los registros en función de patrones de atributos en lugar de valores exactos de los campos.
Evitar que los registros duplicados vuelvan a introducirse en el sistema
Una operación de deduplicación sin medidas preventivas supone un coste recurrente. La API de búsqueda aproximada en tiempo real de Match Data Pro compara los registros entrantes con el almacén de registros de referencia existente en el momento de su entrada. Cada vez que se envía un nuevo formulario web con los datos de «Jon Smyth, de Acme Corp», se compara con los registros existentes en tiempo real, lo que permite detectar un posible duplicado antes de que se guarde en la base de datos.
La automatización de tareas se encarga del mantenimiento continuo: la actualización periódica de perfiles, las operaciones de deduplicación incremental en los lotes recién importados y la activación de alertas cuando los índices de duplicación superan los umbrales definidos. El resultado es un flujo de trabajo de calidad de datos repetible, en lugar de una situación de emergencia trimestral.
Para los equipos cuyo principal caso de uso sea la deduplicación de CRM, consulta la guía paso a paso sobre la deduplicación de CRM. Para la consolidación de múltiples fuentes en conjuntos de datos adquiridos, la guía de fusión y purga describe todo el proceso entre conjuntos de datos.
Reserva una demostración para ver cómo Match Data Pro detecta y elimina los duplicados en tu entorno.
Preguntas frecuentes
¿Cuál es el coste medio que suponen los registros duplicados para las grandes empresas?
Los estudios del sector sitúan sistemáticamente los costes derivados de la mala calidad de los datos entre el 15 % y el 25 % de los ingresos de las organizaciones afectadas, y los registros duplicados representan una parte significativa de ellos. Los costes directos incluyen el gasto de marketing malgastado, el exceso de almacenamiento, los análisis fallidos y las sanciones por incumplimiento normativo. Para una empresa del mercado medio con unos ingresos de 50 millones de dólares, esto puede suponer entre 7,5 y 12,5 millones de dólares en pérdidas anuales relacionadas con la calidad de los datos, la mayor parte de las cuales pasan desapercibidas hasta que un ejercicio de perfilado pone de manifiesto el alcance de la duplicación.
¿Cómo detecta la búsqueda aproximada los duplicados que la lógica de coincidencia exacta no detecta?
La coincidencia aproximada evalúa el grado de similitud entre dos valores, en lugar de exigir que coincidan carácter por carácter. Una consulta de coincidencia exacta consideraría «Robert Smith» y «Bob Smith» como nombres completamente diferentes. Un motor de coincidencia aproximada que combine la puntuación de Jaro-Winkler en el campo del nombre con la codificación fonética los calificaría como coincidencias probables (0,82+) y los remitiría a revisión para su fusión. Esta es la técnica fundamental en la que se basa la deduplicación probabilística.
¿Cuánto tiempo suele durar un proyecto de deduplicación?
Con una plataforma como Match Data Pro, la creación de perfiles iniciales y una primera pasada de deduplicación en un conjunto de datos de un millón de registros suelen completarse en menos de 24 horas. La configuración de las reglas de supervivencia y el ajuste de los umbrales añaden entre 1 y 3 días al primer proyecto. Las ejecuciones posteriores con datos incrementales están automatizadas y se completan en cuestión de minutos. La fase más larga suele ser la coordinación entre las partes interesadas sobre las reglas de fusión, no el trabajo técnico.
¿Deberíamos realizar la deduplicación antes o después de una migración de CRM?
Siempre antes. La migración de datos incorrectos a un nuevo CRM introduce duplicados en la base del nuevo sistema, donde son más difíciles de eliminar y más costosos de corregir. Una ronda de deduplicación previa a la migración, mediante la limpieza y la estandarización de los datos, garantiza que solo se transfieran registros válidos al nuevo entorno, lo que reduce la complejidad de la transición y la carga de asistencia técnica tras la migración.
¿Qué es un disco de oro y cómo se produce?
Un «registro de referencia» es la única versión oficial de una entidad —cliente, empresa, dirección o producto— que se obtiene al fusionar todas las representaciones duplicadas mediante reglas de supervivencia definidas. Cada campo del registro de referencia contiene el valor que se considera más preciso según reglas como la prioridad de la fuente, la actualización más reciente o la cadena no nula más larga. Match Data Pro genera y exporta registros de referencia a cualquier sistema posterior a través de conectores de importación/exportación o una API.