
Los registros duplicados en el CRM inflan las cifras del canal de ventas, provocan el envío por duplicado de correos electrónicos de marketing y hacen que los comerciales llamen dos veces al mismo contacto. La solución es un proceso estructurado de deduplicación en seis pasos: analizar el perfil de los datos, estandarizar los campos, bloquear pares candidatos, puntuar las coincidencias con algoritmos difusos, fusionar utilizando reglas de supervivencia y verificar las direcciones. Ejecútalo una vez como limpieza por lotes y, a continuación, automatízalo para eliminar los duplicados de forma permanente.
¿Estás listo para limpiar tu CRM ahora mismo? Empieza una prueba gratuita de Match Data Pro y ejecuta tu primera tarea de deduplicación en cuestión de minutos.
Por qué los registros duplicados en el CRM son peores de lo que parecen
Un sistema CRM típico del segmento medio suele contener entre un 5 % y un 25 % de registros duplicados de contactos o cuentas. El perjuicio no es solo superficial. Los duplicados distorsionan todos los informes que utilizan esos datos. Un contacto llamado «Jon Smith» de Acme Corp y otro llamado «Jonathan Smith» de ACME Corporation son la misma persona. Sin la deduplicación, tu equipo de ventas tiene dos oportunidades abiertas, dos hilos de correo electrónico y dos conjuntos de actividades registradas para un mismo cliente.
Fuentes habituales de duplicados en el CRM:
- Introducción manual sin validación en el momento de la captura
- Contactos obtenidos en ferias, eventos o listas de terceros
- Migraciones de sistemas que conservan los duplicados existentes
- Integraciones con sistemas de automatización de marketing o ERP que crean nuevos contactos sin comprobar si ya existen otros
- Variantes de apodos y abreviaturas: «Bob» frente a «Robert», «Co.» frente a «Company», «St.» frente a «Street»
La deduplicación por coincidencia exacta (que busca direcciones de correo electrónico idénticas) detecta aproximadamente el 40 % de los duplicados. El resto requiere algoritmos de coincidencia aproximada que evalúan simultáneamente el grado de similitud entre los campos de nombre, teléfono, dirección y empresa.
El proceso de deduplicación del CRM en seis pasos
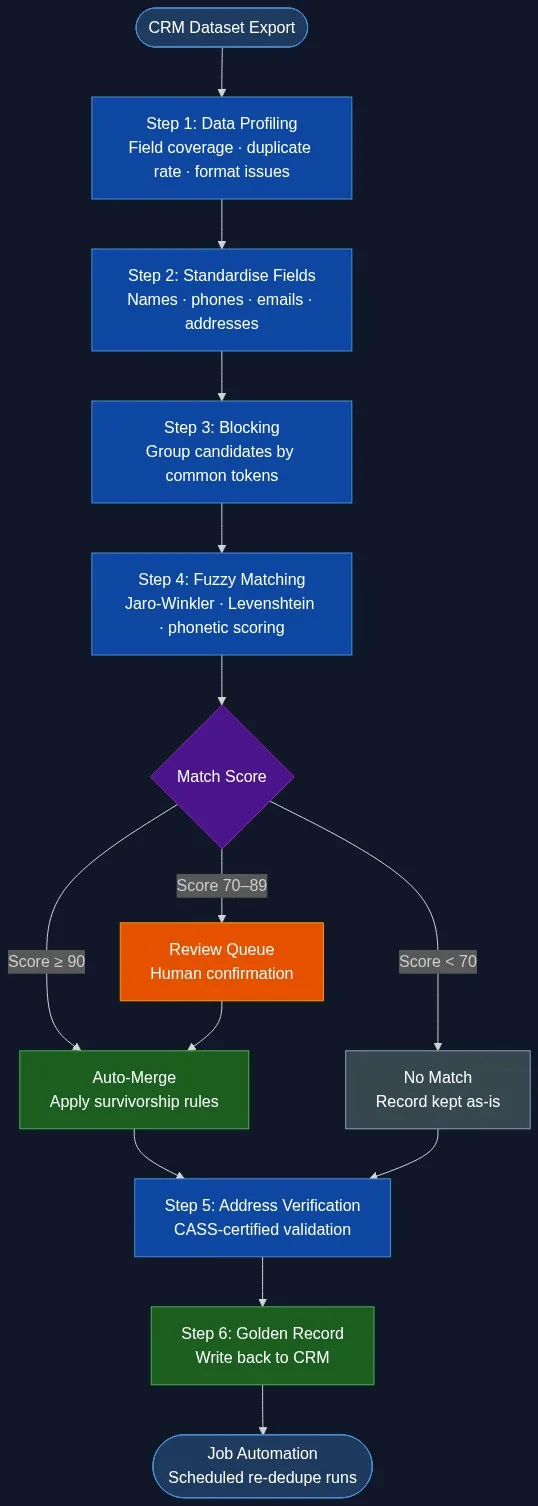
El siguiente diagrama muestra el proceso completo. Cada paso da paso al siguiente. Saltarse un paso, sobre todo la estandarización antes de la comparación, es la razón más habitual por la que las tareas de deduplicación producen resultados deficientes.
Paso 1: Análisis de datos
Antes de aplicar cualquier lógica de coincidencia, analiza el perfil de tu conjunto de datos. El análisis del perfil de los datos te indica qué porcentaje de registros contiene un correo electrónico, cuántos números de teléfono tienen formatos no estándar y cuál es la tasa global de duplicados según la agrupación por coincidencia exacta. Estas métricas establecen tus expectativas de umbral antes de que comience la puntuación difusa.
Resultados clave del análisis de perfiles para la deduplicación en CRM:
- Completitud de los campos: % de registros con nombre, apellidos, correo electrónico, teléfono y empresa
- Formato de distribución: cuántos números de teléfono utilizan guiones, puntos o ningún separador
- Índice de duplicados exactos: registros que comparten la misma dirección de correo electrónico o el mismo número de teléfono
- Índice de valores nulos por campo: los campos con un índice elevado de valores nulos deben tener una ponderación menor en la puntuación de la coincidencia
Paso 2: Estandarizar los campos
La comparación entre «Bob Smith» y «Robert Smith» falla si ninguno de los dos nombres se ha normalizado. La normalización convierte todos los campos a un formato coherente antes de que comience la evaluación. Aquí es donde fracasan la mayoría de los intentos manuales de deduplicación: los equipos se saltan este paso y luego se preguntan por qué sus índices de coincidencia son bajos.
Normas de estandarización para los campos del CRM:
| Campo | Valor bruto | Valor estandarizado |
|---|---|---|
| Nombre | BOB | Robert |
| Empresa | ACME Corp. | ACME Corporation |
| Teléfono | 212.555.0100 | +12125550100 |
| DIRECCIÓN | Calle Main, 123, local 4 | Calle Main, 123, oficina 4 |
| Correo electrónico | Bob.Smith@ACME.COM | bob.smith@acme.com |
Match Data Pro aplica más de 40 reglas de estandarización integradas que abarcan el análisis sintáctico de nombres, la normalización de números de teléfono, la expansión de sufijos de empresas y la separación de componentes de direcciones. También puedes configurar reglas personalizadas para patrones específicos de cada ámbito, como los números de identificación de empleados o los códigos de productos. Descubre cómo encaja esto en un flujo de trabajo completo de limpieza de datos empresariales.
Paso 3: Bloqueo
Un CRM con 500 000 registros tiene 125 000 millones de pares de registros posibles. Comparar todos los pares es computacionalmente inviable. El bloqueo reduce el espacio de comparación agrupando los registros que comparten al menos un elemento común: los tres primeros caracteres de un apellido, el mismo prefijo telefónico o el mismo dominio de empresa.
Una buena estrategia de filtrado omite menos del 2 % de los duplicados reales, al tiempo que reduce el espacio de comparación en más del 99 %. Match Data Pro utiliza el filtrado por claves múltiples: un par de registros se incluye si coincide en cualquiera de las distintas claves de filtrado. Esto evita que se pasen por alto coincidencias cuando un solo campo está dañado o falta.
Paso 4: Coincidencia aproximada y puntuación
Cada par de candidatos generado mediante el método de bloqueo se evalúa en varios campos utilizando una combinación ponderada de algoritmos de coincidencia difusa. Cada tipo de campo requiere un algoritmo específico:
- Jaro-Winkler para nombres y apellidos: premia la similitud de prefijos y gestiona las transposiciones
- Distancia de Levenshtein para códigos cortos e identificadores: cuenta el número mínimo de modificaciones de caracteres
- Fonética (Soundex/Double Metaphone) para nombres que suenan igual: «Smith» coincide con «Smyth»
- Basado en tokens (coseno TF-IDF) para nombres y direcciones de empresas: tiene en cuenta las variaciones en el orden de las palabras
Las puntuaciones de los campos se combinan para obtener una puntuación global del partido mediante ponderaciones configurables. Una configuración típica de CRM:
| Campo | Peso | Algoritmo |
|---|---|---|
| Correo electrónico | 40% | Exacto / Levenshtein |
| Nombre completo | 25% | Jaro-Winkler + fonética |
| Teléfono | 20% | Exacto (normalizado) |
| Empresa | 10% | Coseno simbólico |
| DIRECCIÓN | 5% | Coseno simbólico |
Los pares con una puntuación de 90 o más se fusionan automáticamente. Los pares con una puntuación de entre 70 y 89 pasan a una cola de revisión manual. Los pares con una puntuación inferior a 70 se tratan como registros distintos. Estos umbrales son configurables. Los equipos con mayor tolerancia a la calidad de los datos ajustan el umbral de fusión automática a 95; los equipos que trabajan con datos heredados más ruidosos pueden reducirlo a 85. Para obtener más información sobre la selección de algoritmos, consulta la guía sobre algoritmos de coincidencia de datos y vinculación de registros mediante múltiples algoritmos.
Paso 5: Normas de supervivencia y fusión
Cuando se confirma que dos registros son duplicados, las reglas de selección determinan qué valores de los campos se conservan en el registro de referencia fusionado. No se trata simplemente de una decisión del tipo «conservar el registro más reciente». Cada campo tiene sus propios indicadores de fiabilidad.
Normas generales de supervivencia para los registros del CRM:
- Últimos datos no nulos: número de teléfono, correo electrónico, cargo
- Victorias más largas que no sean nulas: nombre de la empresa (para evitar que las abreviaturas sustituyan a los nombres completos)
- Prevalece la prioridad de la fuente: los registros verificados del sistema de facturación tienen prioridad sobre los datos introducidos en formularios web no verificados
- Prevalece la dirección con mayor nivel de confianza: una dirección con el indicador de verificación CASS activado tiene prioridad sobre una dirección no verificada.
Match Data Pro te permite definir reglas de prevalencia por campo y por sistema de origen. El registro fusionado conserva un registro de auditoría completo: qué sistema de origen aportó cada valor de campo y por qué. Esto es importante para el cumplimiento del RGPD y para la resolución de disputas cuando los comerciales no se ponen de acuerdo sobre qué registro era el «correcto». Para obtener más información sobre cómo se relacionan la fusión y la prevalencia, consulta la guía sobre la fusión de datos y las reglas de prevalencia.
Paso 6: Verificación de la dirección
Tras la fusión, somete todas las direcciones a una verificación certificada por CASS. El sistema CASS (Coding Accuracy Support System) valida las direcciones cotejándolas con la base de datos del USPS, corrige las abreviaturas de los sufijos de las calles, añade los códigos ZIP+4 y señala las direcciones en las que no se puede realizar la entrega. Una dirección que dice «123 Main St, Ste 4, Nw Yrk, NY» pasa a ser «123 Main Street, Suite 4, Nueva York, NY 10001-2345».
Las direcciones no entregables son una fuente habitual de duplicados ocultos: la misma ubicación física introducida en cinco formatos diferentes. La verificación de direcciones en esta fase agrupa esas variantes antes de que vuelvan a introducirse en el CRM. El proceso de comparación y verificación de direcciones de Match Data Pro se encarga de ello automáticamente como parte del paso posterior a la fusión.
Cómo abordar los casos complejos de deduplicación en CRM
Apodos y variantes del nombre
«Bill» y «William» no comparten ningún carácter en común. La distancia de Levenshtein les asigna una puntuación cercana a cero. Los algoritmos fonéticos también les asignan puntuaciones diferentes. El enfoque correcto es una tabla de búsqueda de apodos: una correspondencia predefinida de variantes comunes de nombres de pila. Match Data Pro incluye una tabla de apodos con 4.200 entradas que abarca nombres comunes en inglés, español, francés y portugués. Cuando la tabla de búsqueda confirma que «Bill» se corresponde con «William», la puntuación del campo del nombre salta a 100, independientemente de la distancia entre las cadenas.
La misma persona, otra empresa
Un contacto que haya cambiado de empresa tendrá el mismo nombre y número de teléfono, pero un dominio de correo electrónico y un nombre de empresa diferentes. Si la comparación se basara únicamente en el correo electrónico, se le pasaría por alto. Si se basara únicamente en el nombre y el teléfono, se producirían falsos positivos en el caso de nombres comunes. La solución es una puntuación compuesta ponderada en la que una coincidencia alta entre el nombre y el teléfono, junto con una coincidencia baja en el correo electrónico, siga superando el umbral de revisión (70-89). A continuación, un revisor humano confirma si se trata de una actualización por cambio de trabajo o de una persona realmente diferente.
Relaciones entre cuentas principales y secundarias
«Acme Corp» y «Acme Corp – Oficina de Londres» no son duplicados. Son cuentas relacionadas. Una coincidencia aproximada simplista basada en el nombre de la empresa las marcaría como duplicadas con una puntuación de 88. Configura la coincidencia de empresas para excluir los registros en los que un nombre sea una subcadena del otro y ambos tengan direcciones distintas. La configuración de reglas y bloqueos de Match Data Pro admite este patrón sin necesidad de código personalizado. Para los equipos que gestionan varias fuentes de CRM simultáneamente, la guía sobre la coincidencia de registros entre varios sistemas aborda el escenario ampliado de coincidencia entre fuentes.
Automatización de la deduplicación continua en el CRM
Una deduplicación realizada una sola vez pierde eficacia en cuestión de semanas. Cada día llegan nuevos clientes potenciales a través de formularios web, campañas de pago y análisis de eventos. Sin un proceso de deduplicación continuo, volverás a tener un 10 % de duplicados en un trimestre.
Hay dos mecanismos que evitan la presencia de duplicados tras la limpieza inicial:
Deduplicación de la API en tiempo real
La API de búsqueda aproximada en tiempo real de Match Data Pro puede invocarse en el momento de la creación del registro. Cuando se envía un formulario de cliente potencial, la API consulta la base de datos del CRM en busca de coincidencias aproximadas antes de que se guarde el registro. Si se encuentra una coincidencia que supera el umbral establecido, el nuevo cliente potencial se fusiona con el existente o se marca para su revisión, en lugar de crear un duplicado. La latencia es inferior a 200 ms para un CRM con un millón de registros.
Tareas por lotes programadas
Para los registros que se introducen a través de integraciones o importaciones masivas, programa una tarea de deduplicación por lotes nocturna o semanal. El motor de automatización de tareas de Match Data Pro te permite configurar todo el proceso, desde la creación de perfiles hasta la fusión, como una tarea programada. La tarea registra cada decisión de coincidencia, cada acción de fusión y cada resultado de selección. Estos registros se incorporan directamente a tu flujo de trabajo de deduplicación automatizado.
¿Quieres ver cómo funciona la deduplicación con los datos de tu propio CRM? Reserva una demostración y analizaremos contigo tu estructura de datos específica y la configuración adecuada.
Deduplicación del CRM antes de una migración
Si estás planeando una migración de CRM, la deduplicación debe realizarse antes de la transición, no después. Trasladar datos incorrectos a un nuevo sistema no soluciona el problema. Lo integra en el historial de la nueva plataforma, donde resulta más difícil de corregir, ya que las actividades, las notas y las oportunidades ya están vinculadas a registros duplicados.
Ejecuta el proceso completo de seis pasos en tu conjunto de datos de origen. Exporta una instantánea limpia y sin duplicados. Carga la instantánea en el nuevo CRM. Este enfoque también reduce el tiempo de migración: un CRM de 200 000 registros, tras la deduplicación, que queda en 150 000 registros, se carga un 25 % más rápido y requiere un 25 % menos de esfuerzo de validación. La guía completa de preparación previa a la migración trata este tema en detalle: Migración de datos de CRM: cómo preparar y limpiar tus datos antes del traslado.
Cómo medir el éxito de la deduplicación
Realiza un seguimiento de estos indicadores antes y después de una operación de deduplicación para cuantificar el impacto en el negocio:
| Métrico | Antes de la deduplicación | Tras la deduplicación |
|---|---|---|
| Total de registros de contactos | 210,000 | 162,000 |
| Índice de duplicados | 23% | <1% |
| Tasa de rebote de correos electrónicos | 8.4% | 2.1% |
| Superposición en la baja de la lista de correo (mismo contacto, 2 o más registros) | 14% | 0% |
| Número de ofertas de empleo disponibles (dato exacto) | Subestimado en aproximadamente un 18 % | Preciso |
Es posible alcanzar una tasa de duplicados inferior al 1 % con un proceso bien configurado y una automatización continua. Una tasa superior al 5 % indica que, o bien la limpieza inicial fue incompleta, o bien están apareciendo nuevos duplicados a un ritmo más rápido del que la tarea programada puede detectar. Revisa tus claves de bloqueo y la cobertura de la integración de la API si tu tasa vuelve a superar el 5 %.
Empieza una prueba gratuita de Match Data Pro para analizar tu CRM, ejecutar una tarea de deduplicación de prueba y ver el número estimado de registros limpios antes de comprometerte a realizar una limpieza completa.
Preguntas frecuentes
¿Cuánto tiempo se tarda en eliminar los registros duplicados de un CRM con 500 000 registros?
Con una plataforma que utiliza el procesamiento por bloques y en paralelo, una tarea de deduplicación de 500 000 registros suele completarse en un plazo de entre 15 y 45 minutos. La revisión manual de la franja de puntuación de 70 a 89 añade tiempo en función del volumen, pero esa cola suele representar entre el 5 % y el 15 % del total de pares. La estandarización y la creación de perfiles añaden entre 30 y 60 minutos a la ejecución inicial.
¿Cuál es la diferencia entre la deduplicación por coincidencia exacta y la deduplicación aproximada?
La deduplicación por coincidencia exacta identifica los registros con valores de campo idénticos, como, por ejemplo, la misma dirección de correo electrónico. La deduplicación por coincidencia aproximada evalúa la similitud entre varios campos simultáneamente, detectando variantes como «Jon Smith» y «Jonathan Smith» en la misma empresa. La mayoría de los problemas de duplicados en los sistemas CRM requieren la coincidencia aproximada, ya que las coincidencias exactas detectan menos de la mitad de los duplicados reales.
¿Debería eliminar los contactos y las cuentas por separado?
Sí. La deduplicación de cuentas y la de contactos utilizan diferentes ponderaciones de campos y estrategias de bloqueo. Los registros de cuentas otorgan mayor importancia al nombre de la empresa, el dominio y la dirección. Los registros de contactos otorgan mayor importancia al nombre, los apellidos, el correo electrónico y el teléfono. Ejecuta primero la deduplicación de cuentas y, a continuación, vincula los contactos a las cuentas fusionadas antes de ejecutar la deduplicación de contactos, de modo que las relaciones entre cuentas sean correctas antes de que se agrupen los registros de contactos.
¿Cómo puedo evitar que se vuelvan a introducir nuevos registros duplicados en el CRM tras la limpieza?
Hay dos mecanismos que funcionan conjuntamente: una llamada a la API en tiempo real en el momento de la creación del registro, que comprueba si hay coincidencias aproximadas antes de crear un nuevo registro, y una tarea por lotes programada que detecta todo lo que haya entrado a través de integraciones o importaciones. Sin estas dos capas, los duplicados vuelven a aparecer a las pocas semanas de la limpieza inicial.
¿Puedo eliminar los datos duplicados del CRM sin exportarlos a una herramienta de terceros?
Match Data Pro admite conectores CRM directos para las plataformas más habituales, por lo que no es necesario que los datos salgan de tu entorno en forma de exportación de archivo plano. Los registros se transmiten a través del proceso de deduplicación y los resultados se vuelven a escribir a través del conector. Para implementaciones en las que la seguridad es fundamental, la plataforma también admite el procesamiento local, en el que ningún dato sale de tu red.