
Los apodos, las abreviaturas y las variantes de los nombres impiden la coincidencia de entidades cuando no se gestionan de forma explícita. «William» y «Bill» no comparten ningún solapamiento léxico; «IBM» e «International Business Machines» obtienen una puntuación cercana a cero si solo se tiene en cuenta la similitud de las cadenas de caracteres. Un motor de coincidencia que se base únicamente en algoritmos a nivel de caracteres pasará por alto estos pares, lo que generará falsos negativos que fragmentarán los registros de sus clientes, proveedores o pacientes en múltiples identidades. La solución es una capa de preprocesamiento que amplíe y normalice cada campo de nombre antes de que comience la puntuación difusa.
¿Estás listo para gestionar variantes de nombres a gran escala? Empieza una prueba gratuita de Match Data Pro y ejecuta tu primera tarea de coincidencia de entidades en cuestión de minutos.
Por qué las variantes de los nombres son el problema más difícil en la correspondencia de entidades
La mayoría de los fallos en la calidad de los datos relacionados con la correspondencia de entidades se deben a una causa fundamental: una misma persona u organización figura con múltiples variantes de nombre en distintos sistemas de origen. Esto ocurre por tres razones principales.
En primer lugar, las personas utilizan nombres informales en contextos cotidianos. «Robert Johnson» se convierte en «Bob Johnson» en el registro del CRM de un comercial, en «R. Johnson» en una exportación de datos financieros y en «Bobby Johnson» en una inscripción a un evento. Una comparación convencional de coincidencia exacta o incluso una comprobación estándar de distancia de edición no permitirá relacionar estos tres registros sin ayuda adicional.
En segundo lugar, en la práctica, las organizaciones acortan sus nombres. «International Business Machines Corporation» siempre se escribe como «IBM». «3M» son las siglas de «Minnesota Mining and Manufacturing». Si tu motor de correspondencias trata estas denominaciones como cadenas de caracteres diferentes, acabarás teniendo registros de proveedores duplicados, análisis de gasto fragmentados y datos maestros de proveedores erróneos.
En tercer lugar, las migraciones de sistemas heredados provocan truncamientos. Un campo de nombre de 30 caracteres en un ERP podría truncar «St. Christopher’s Medical Center» a «St Christoph Med Ctr», lo que se parece muy poco a la forma canónica que figura en tu CRM. Es imprescindible llevar a cabo una estandarización de los datos antes de que la correspondencia pueda realizarse con éxito.
El resultado es el mismo en los tres escenarios: tu motor de resolución de entidades detecta cadenas que no puede vincular con certeza, la tasa de errores supera el 15-25 % y los análisis posteriores fragmentan la misma entidad en dos, tres o más registros fantasma.
Las tres clases de variantes y cómo abordar cada una de ellas
1. Apodos y nombres de pila informales
Los apodos de los nombres propios siguen patrones muy conocidos: Robert/Bob/Rob/Bobby, William/Bill/Will/Billy, Elizabeth/Beth/Liz/Eliza, Katherine/Kate/Kathy/Cathy. El método más fiable es utilizar una tabla de correspondencias que relacione cada forma informal con su nombre base canónico. En Match Data Pro, el motor de coincidencia aproximada admite diccionarios de apodos configurables por el usuario, lo que permite ampliar las variantes específicas de cada ámbito; por ejemplo, los alias profesionales habituales en el sector sanitario (prefijos como «Dr.», apellidos con guion) o en los servicios financieros.
La tabla de correspondencias debe aplicarse de forma bidireccional: amplíe tanto el registro de origen como el de destino a su forma canónica antes de calcular la puntuación. De este modo se garantiza que tanto «Bob» como «Bobby» se asignen a «Robert» y obtengan una puntuación de similitud de 1,0 en el campo «nombre» antes de que se calcule la puntuación compuesta de varios campos.
2. Abreviaturas y acrónimos
Las abreviaturas aparecen en dos contextos: las iniciales de los nombres propios («J. Smith» frente a «John Smith») y los acrónimos de nombres de organizaciones («GE» frente a «General Electric»). Ambos requieren una lógica de resolución diferente.
En el caso de las iniciales de nombres propios, la regla más segura es la siguiente: si un registro contiene un nombre de un solo carácter y el otro contiene un nombre completo, comprueba si la inicial coincide con el primer carácter del nombre completo. Si es así, considera que los tokens de nombre son equivalentes antes de pasar el campo a tu sistema de evaluación de similitud. Esto evita que el algoritmo de Jaro-Winkler asigne una puntuación de 0,72 a la comparación entre «J Smith» y «John Smith», cuando la puntuación correcta debería ser 1,0 tras la resolución de las iniciales.
En el caso de las siglas de organizaciones, mantén un vocabulario controlado con las correspondencias conocidas entre abreviaturas y nombres completos, que suelen proceder de tu maestro de proveedores, del CRM o de tablas de códigos estándar del sector. Esto es especialmente importante en la resolución de entidades de servicios financieros, donde los documentos regulatorios suelen utilizar nombres abreviados de entidades jurídicas que difieren de los nombres comerciales.
3. Variantes de nombres por motivos culturales y regionales
Las bases de datos internacionales presentan variantes de transcripción. «Mohammed» aparece como «Mohamed», «Muhammad», «Mohammad» y «Muhammed», dependiendo del país de origen y de las convenciones de transcripción. Los nombres chinos pueden romanizarse en diferentes órdenes (nombre de pila primero frente a apellido primero). Los apellidos compuestos españoles pueden escribirse con guion o separados por un espacio.
Los algoritmos fonéticos —Soundex, Metaphone, Double Metaphone— gestionan bien este caso, ya que codifican el sonido de un nombre en lugar de su ortografía exacta. «Mohammed» y «Muhammad» se corresponden con el mismo código Metaphone. La combinación de la codificación fonética con la puntuación difusa basada en tokens proporciona a tu proceso de coincidencia de entidades la cobertura que necesita en conjuntos de datos multilingües.
El proceso de preprocesamiento: cinco etapas previas a la puntuación
Para gestionar eficazmente las variantes de los nombres, es necesario llevar a cabo una fase de preprocesamiento específica antes de ejecutar cualquier algoritmo de similitud. A continuación se explica cómo se estructura un proceso de producción.
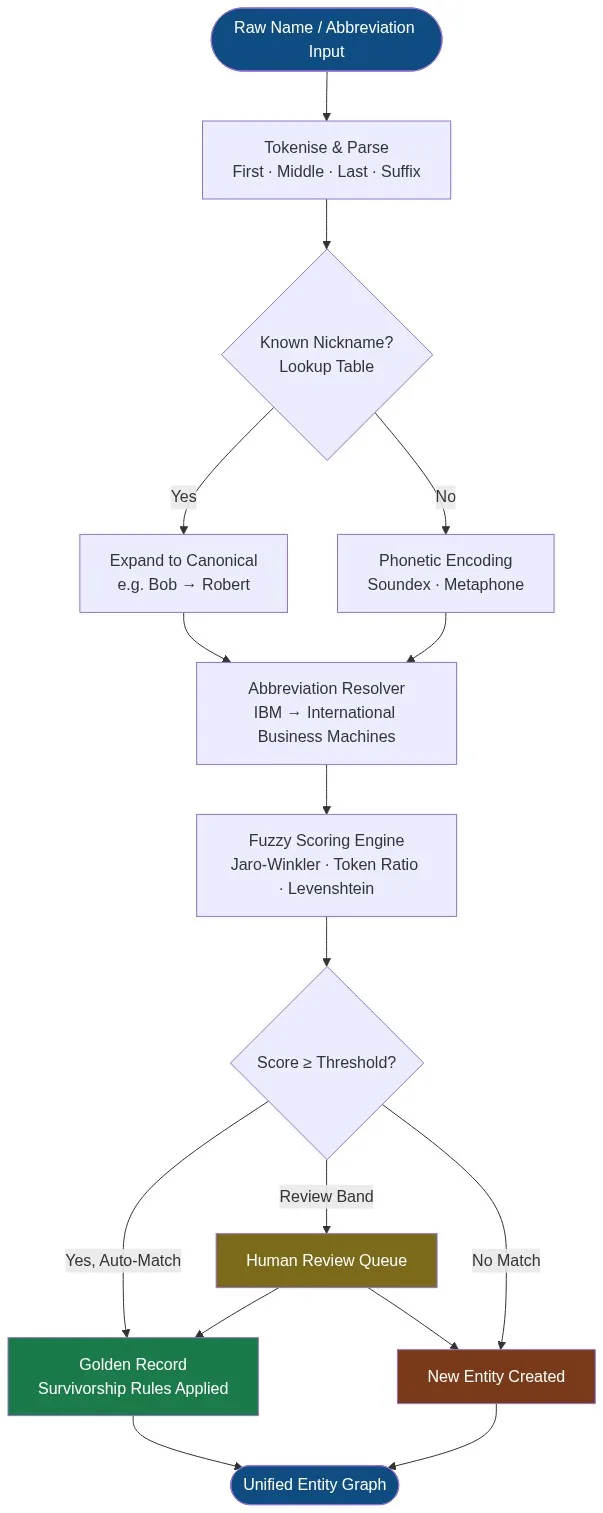
Etapa 1: tokenización y análisis sintáctico. Dividir la cadena de texto sin procesar del nombre en sus componentes: título, nombre, segundo nombre, apellido y sufijo. El análisis sintáctico separa «Dr. Robert A. Johnson Jr.» en cuatro tokens identificables. La coincidencia a nivel de campo siempre es más precisa que la coincidencia de la cadena completa en el caso de los nombres.
Etapa 2: Normalizar mayúsculas y puntuación. Poner en mayúscula todos los tokens; eliminar los guiones, los apóstrofos y los puntos que no tengan sentido. «O’Brien», «Obrien» y «O Brien» deben dar lugar a la misma forma normalizada. Esta etapa forma parte de la capa de limpieza automatizada de datos de Match Data Pro.
Etapa 3 — Aplicar la búsqueda de apodos y abreviaturas. Para cada token analizado, consultar el diccionario de apodos y la tabla de abreviaturas. Sustituir la forma informal por su equivalente canónico. Marcar la sustitución para que pueda tenerse en cuenta en la puntuación de confianza en etapas posteriores.
Etapa 4 — Codificación fonética. Se genera un código Soundex o Double Metaphone para cada token tras la sustitución. Este código se añade como clave de bloqueo, lo que reduce el espacio de comparación al agrupar los nombres fonéticamente similares antes de que comience el cálculo de similitud O(n²).
Etapa 5: puntuación de similitud mediante múltiples algoritmos. Se aplica el algoritmo de Jaro-Winkler a los tokens de nombre normalizados, la proporción de conjuntos de tokens a las cadenas de nombre completas y la distancia de edición de Levenshtein como criterio de desempate. Se combinan las tres puntuaciones, con las ponderaciones de campo configuradas, para obtener una puntuación de coincidencia compuesta. Los registros que superen el umbral de coincidencia automática pasan a la fase de supervivencia; los registros que se encuentren en el rango de revisión pasan a una cola de revisión manual. Así es como funciona en la práctica la comparación de datos mediante múltiples algoritmos.
Ejemplo práctico: antes y después de la resolución de variantes de nombres
Consideremos dos registros procedentes de un proceso de consolidación del CRM tras una fusión:
| Campo | Registro A (CRM heredado) | Registro B (CRM adquirido) |
|---|---|---|
| Nombre | Bobby R. Johnson | Robert Johnson |
| Empresa | GE Healthcare | General Electric Healthcare |
| Correo electrónico | b.johnson@gehc.com | robert.johnson@ge-healthcare.com |
| Teléfono | 312-555-0182 | (312) 555-0182 |
Sin tener en cuenta las variantes del nombre, la puntuación bruta de Jaro-Winkler para «Bobby R Johnson» frente a «Robert Johnson» es de aproximadamente 0,68, por debajo del umbral habitual de coincidencia automática, que es de 0,85. Los registros no están vinculados.
Tras aplicar el proceso de preprocesamiento: «Bobby» se completa como «Robert» mediante el diccionario de apodos; «R.» se identifica como una inicial coincidente; «GE Healthcare» se completa como «General Electric Healthcare» mediante la tabla de abreviaturas; los números de teléfono se estandarizan al formato E.164 y obtienen una puntuación de 1,0. La puntuación compuesta supera ahora el 0,93, lo que indica una coincidencia automática fiable. Dos registros fragmentados se convierten en un único registro de referencia verificado.
Este es precisamente el tipo de situación en la que las plataformas de resolución de entidades y de vinculación de datos deben funcionar correctamente. Si no lo hacen, puede ocurrir que un comercial llame dos veces al mismo cliente, que el departamento financiero procese una factura por duplicado o que un profesional sanitario atienda a un paciente sin disponer de su historial completo.
Configuración de umbrales para escenarios de variantes de nombre
El tratamiento de las variantes de los nombres plantea un importante reto de ajuste: ampliar los apodos aumenta la capacidad de recuperación (se encuentran más coincidencias reales), pero un diccionario demasiado agresivo puede aumentar los falsos positivos si dos personas diferentes comparten un mismo apodo. El umbral debe calibrarse teniendo en cuenta las pruebas adicionales procedentes de otros campos.
Un enfoque práctico de configuración:
- Cuando se active la canonicización del nombre (se ha realizado una sustitución), reduce ligeramente la ponderación del campo «nombre» y compénsalo aumentando la ponderación de los campos «correo electrónico», «teléfono» y «dirección». Dado que la coincidencia del nombre es menos segura, los demás campos tienen mayor peso probatorio.
- Establece un rango de revisión «flexible» (por ejemplo, una puntuación compuesta de 0,70 a 0,84) para los registros en los que se haya producido una expansión de un apodo, pero los campos complementarios estén incompletos o falten. Deriva estos registros a una cola de revisión manual en lugar de fusionarlos automáticamente.
- Registra todas las sustituciones en el historial de auditoría de coincidencias. Esto favorece la trazabilidad: un responsable de cumplimiento normativo puede ver exactamente por qué se fusionaron dos registros, incluyendo qué entrada del diccionario de apodos se activó. El software de resolución de entidades de Match Data Pro registra cada decisión de coincidencia con pruebas a nivel de campo.
El ajuste del umbral es un proceso iterativo. Procesá una muestra representativa de tus datos a través del flujo de trabajo, revisa manualmente un conjunto estratificado de decisiones de coincidencia y ajusta el umbral compuesto hasta que el equilibrio entre precisión y recuperación se adapte a tu caso de uso. Para la configuración del algoritmo de coincidencia de datos, Match Data Pro muestra todos los pesos y umbrales en una interfaz de usuario sin código, de modo que los ingenieros de datos puedan realizar iteraciones sin necesidad de volver a implementar el sistema.
Ampliación a volúmenes empresariales
Con 10 millones de registros, un enfoque ingenuo de comparación de todos los pares requiere 5 × 10¹³ comparaciones por pares, lo cual es inviable desde el punto de vista computacional. El bloqueo reduce esta cifra agrupando los registros que comparten una clave fonética o un prefijo antes de realizar las comparaciones. Una estrategia de bloqueo bien diseñada reduce el número de pares candidatos en más del 99 %, al tiempo que conserva casi el 100 % de los pares con coincidencia verdadera.
El motor de resolución de entidades Senzing de Match Data Pro utiliza una agrupación de entidades basada en grafos que se escala horizontalmente. Los registros con claves fonéticas comunes o tokens compartidos se agrupan en conjuntos de candidatos, se evalúan en paralelo y se resuelven en clústeres de entidades, todo ello dentro de un flujo de trabajo configurable que puede ejecutarse de forma programada o activada a través de la capa de automatización de tareas de la plataforma.
En los casos de uso en tiempo real —como la comprobación de registros duplicados en el momento de la introducción de datos en el CRM—, la API de búsqueda difusa en tiempo real aplica la misma lógica de preprocesamiento y puntuación en menos de 100 ms por consulta, incluyendo la expansión de apodos y el bloqueo fonético.
¿Estás listo para eliminar los falsos negativos causados por los apodos y las abreviaturas? Reserva una demostración para ver cómo Match Data Pro resuelve las variantes de nombres en tus propios datos, o regístrate para obtener una prueba gratuita y realiza una prueba de concepto hoy mismo.
Preguntas frecuentes
¿Cómo gestiona la coincidencia de entidades los apodos como «Bob» para «Robert»?
Un diccionario de apodos asocia los nombres propios informales a su forma básica canónica antes de que se ejecute cualquier algoritmo de similitud. Tanto «Bob» como «Robert» se sustituyen por «Robert» en la fase de preprocesamiento, por lo que el campo del nombre obtiene una puntuación de similitud de 1,0. Sin este paso, un algoritmo estándar de distancia de edición otorga a este par una puntuación de alrededor de 0,62 —muy por debajo de cualquier umbral razonable de coincidencia automática— y los registros no se detectan.
¿Cuál es el mejor algoritmo para relacionar nombres con sus abreviaturas?
No existe un único algoritmo que sea el más adecuado para todos los casos de abreviaturas. En el caso de las iniciales de nombres propios, un resolutor de iniciales basado en reglas ofrece mejores resultados que los algoritmos difusos. Para las siglas de organizaciones, lo más fiable es una tabla de consulta con vocabulario controlado. Una vez que las abreviaturas se han desarrollado a sus formas canónicas, la puntuación según el método de Jaro-Winkler o la proporción de conjuntos de tokens se encarga de la variación restante. La combinación de estos tres métodos en un proceso por etapas ofrece la mayor precisión.
¿Cómo puedo hacer coincidir los nombres entre distintos idiomas y variantes de transliteración?
Los algoritmos de codificación fonética —Soundex, Metaphone, Double Metaphone— codifican los nombres en función del sonido en lugar de la ortografía, lo que los hace eficaces para las distintas variantes de transliteración de un mismo nombre. «Muhammad» y «Mohammed» se corresponden con el mismo código fonético. En el caso de los alfabetos CJK o no latinos, es necesario realizar una transliteración antes de la codificación fonética. Match Data Pro admite claves de agrupación fonética configurables para conjuntos de datos multilingües.
¿Qué umbral debo utilizar cuando se activa la canonización de nombres?
Cuando se aplique una sustitución por apodo o abreviatura, reduce la ponderación del campo «nombre» entre un 10 % y un 15 % y aumenta las ponderaciones de los campos de corroboración, como el correo electrónico, el teléfono y la dirección. Establece un rango de revisión flexible (normalmente, una puntuación compuesta de entre 0,70 y 0,84) para los registros en los que se haya activado la sustitución, pero los campos de apoyo sean escasos. Realice la coincidencia automática solo cuando la puntuación compuesta de todos los campos supere el umbral validado, que suele ser de 0,85 o superior.
¿Puede el mismo proceso gestionar tanto nombres de personas como de organizaciones?
Sí, pero la lógica de preprocesamiento varía según el tipo de entidad. Los flujos de trabajo para nombres de personas aplican diccionarios de apodos, resolución de iniciales y análisis sintáctico neutro en cuanto al género. Los flujos de trabajo para nombres de organizaciones aplican tablas de acrónimos, normalización de sufijos legales («Ltd» frente a «Limited» frente a «LLC») e independencia del orden de los tokens. Match Data Pro admite definiciones de coincidencia independientes para cada tipo de entidad, cada una con sus propias ponderaciones de campos, diccionarios y umbrales.